R语言批量读取TCGA数据并整合表达矩阵的方法
本文介绍在R语言中处理TCGA等大规模生物信息数据的技巧,重点解决如何批量读取指定路径下的多个文本文件。通过遍历目录、提取元数据映射ID、使用data.table::fread加速读取,并结合for循环或lapply函数将各文件的第二列(如基因表达量)合并为一个完整的数据框,最终生成包含所有样本的表达式矩阵。



本文介绍在R语言中处理TCGA等大规模生物信息数据的技巧,重点解决如何批量读取指定路径下的多个文本文件。通过遍历目录、提取元数据映射ID、使用data.table::fread加速读取,并结合for循环或lapply函数将各文件的第二列(如基因表达量)合并为一个完整的数据框,最终生成包含所有样本的表达式矩阵。
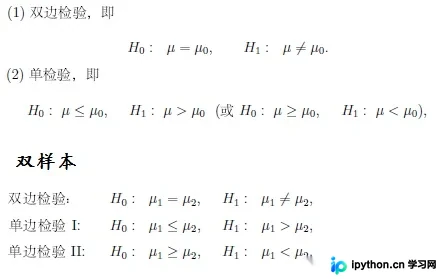
本文系统梳理R语言中常用的数据检验方法,包括正态性检验(W检验、K检验)、相关性检验(Pearson、Spearman)、均值与方差的t检验,以及卡方、Fisher和Wilcoxon等非参数检验。提供各检验的适用场景、R函数调用方式及P值解读,帮助读者快速掌握数据分析中的核心检验逻辑。
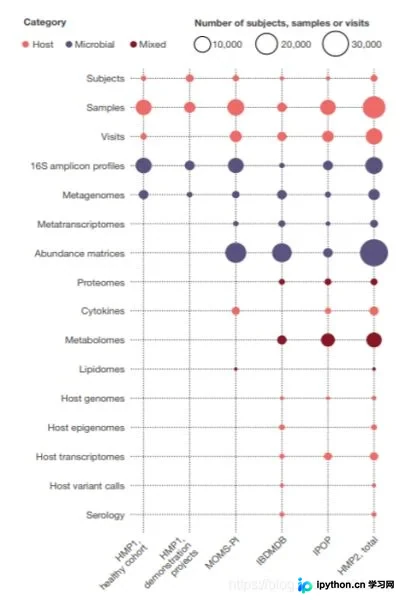
本文详解如何在R语言中利用ggplot2包绘制Bubble Matrix(气泡矩阵图)。通过展示从数据格式整理、宽长转换(melt函数)到核心绘图代码及主题美化的完整步骤,帮助用户清晰呈现两组分类变量之间的关联强度与数值差异。
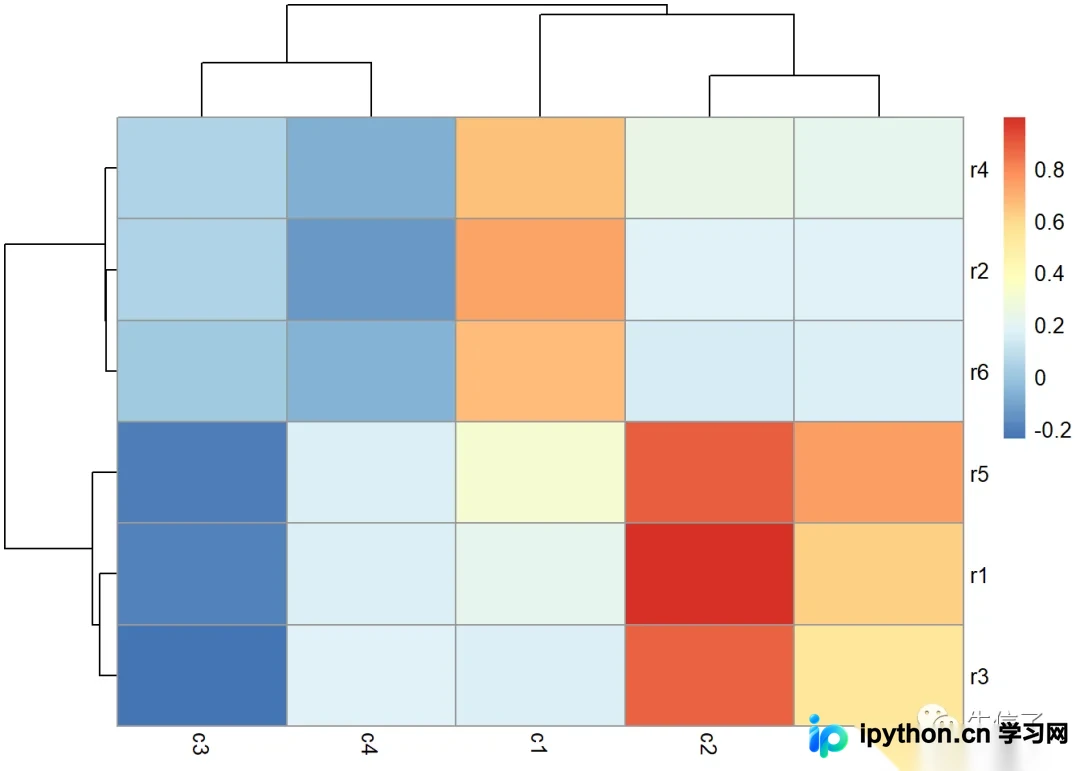
本文介绍在R语言中利用psych和pheatmap包计算两组变量间的Pearson相关系数,并绘制带聚类、数值显示及显著性标记的热图。通过调整参数可实现仅列聚类、自定义标题及不同聚类算法,适用于探索多维数据间的相关关系。
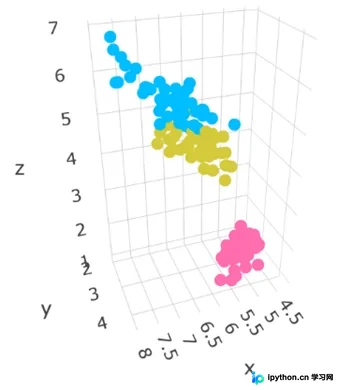
本教程介绍如何利用R语言的plotly包制作交互式3D散点图。内容涵盖从CSV数据读取、函数调用到具体绘图代码的完整操作流程,并详细演示了如何调整点的颜色和透明度,适合需要进行高级数据可视化的用户参考。
本文详细介绍如何使用R语言的基础绘图函数从零构建一把精确到毫米的厘米直尺。通过设定缩放单位、创建空白画布、叠加灰色阴影、绘制白色主体,并利用线段与文本函数精准标注刻度线与数值,最终完成可视化的直尺效果。该示例清晰展示了R中坐标控制与几何图形组合的逻辑。
本文详解在CentOS服务器上安装R及RStudio Server的完整流程。通过配置EPEL源安装基础R环境,下载并安装指定版本的RStudio服务端,解决默认IP:8787访问问题。针对root账号无法登录的限制,提供使用useradd和passwd创建新用户的操作指引,并补充服务重启后登录卡顿的排查技巧。
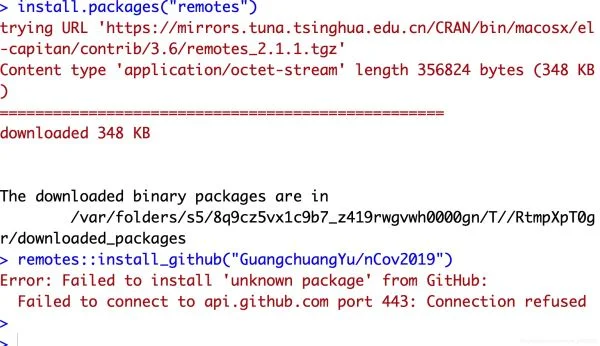
在R语言中通过Github安装软件包(如nCov2019)常因网络超时失败。推荐按顺序尝试三种在线策略:使用remotes或devtools安装、利用Gitee镜像加速;若网络仍不通畅,则转为下载Zip包的离线本地安装模式。本文详述各步骤代码及完成状态判定。
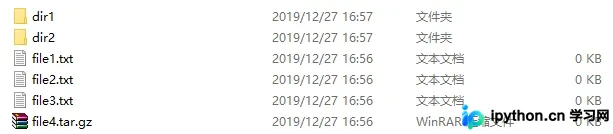
本文详细介绍 R 语言中常见的文件与文件夹操作函数,包括路径设置、文件列表获取(含递归)、新建与删除、以及存在性检测。结合实战示例,帮助读者掌握批量处理数据和自动化脚本编写的基础技能,如解压前的文件结构梳理。
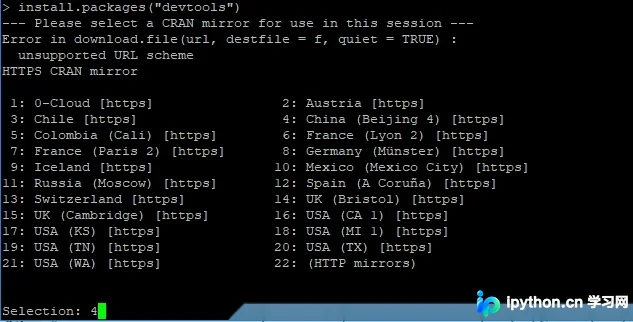
本文详细介绍在Linux或Windows服务器上安装R语言扩展包的方法。针对网络环境,指导通过install.packages()选择国内镜像;针对无网或内网场景,提供使用WinSCP/FileZilla上传包文件,并通过设置repos=NULL进行本地源码安装的完整步骤,以及处理依赖缺失导致安装失败的建议方案。
解决R语言绘图中无法直接将变量值嵌入数学公式标题的问题。通过对比 expression() 的局限性,引入 bquote() 配合 .() 语法,实现变量与公式符号的动态混合输出,适用于批量生成含不同参数值的统计图表标题。
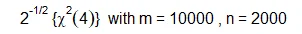
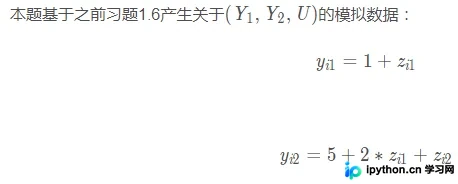
本文通过R语言模拟实验,探讨缺失数据场景下Bootstrap和Jackknife两种重抽样方法的差异。结果显示,直接对原始含缺失数据进行插补后重抽样会引入较大偏差;而在每次重抽样的子样本中独立进行线性插补,能显著降低估计误差,90%置信区间的覆盖次数更多,结果更可靠。