


Python实现酷狗音乐TOP500及飙升榜数据抓取教程

发布时间:2026-10-13 |
5人浏览过
本文详细介绍使用Python获取酷狗音乐TOP500榜单中歌曲MP3格式下载地址的方法,提供完整代码示例。针对部分页面规律失效导致无法完整爬取的问题,文章提供了转向爬取酷狗飙升榜100首的替代方案,包含API请求与网页解析两种实现路径,帮助开发者解决数据抓取中的跳转与完整性难题。
接下来介绍如何利用Python脚本获取酷狗音乐TOP500榜单中歌曲的MP3格式下载地址,具体实现代码如下:
# -*- coding: utf-8 -*-
# @Time : 2018/4/16
# @File : kugou_top500.py
# @Software: PyCharm
# @pyVer : python 2.7
import requests,json
headers={
 'UserAgent' : 'Mozilla/5.0 (iPhone; CPU iPhone OS 5_0 like Mac OS X) AppleWebKit/534.46 (KHTML, like Gecko) Version/5.1 Mobile/9A334 Safari/7534.48.3',
 'Referer' : 'http://m.kugou.com/rank/info/8888',
 'Cookie' : 'UM_distinctid=161d629254c6fd-0b48b34076df63-6b1b1279-1fa400-161d629255b64c; kg_mid=cb9402e79b3c2b7d4fc13cbc85423190; Hm_lvt_aedee6983d4cfc62f509129360d6bb3d=1523818922; Hm_lpvt_aedee6983d4cfc62f509129360d6bb3d=1523819865; Hm_lvt_c0eb0e71efad9184bda4158ff5385e91=1523819798; Hm_lpvt_c0eb0e71efad9184bda4158ff5385e91=1523820047; musicwo17=kugou'
 }
def get_songs(url):
 res=requests.get(url,headers=headers)
 return res.text
def get_song_download_url(url):
 res=requests.get(url,headers=headers)
 res_tmp_list = json.loads(res.text)
 return res_tmp_list['data']['play_url']
def get_song_page_data(url):
 Song_Json = json.loads(get_songs(URL))
 Song_List_Json = Song_Json['data']['info']
 total = []
 for i in range(len(Song_List_Json)):
 song_download_url = "http://www.kugou.com/yy/index.php?r=play/getdata&hash=%s&album_id=%s&_=1523819864065" % (Song_List_Json[i]['hash'], Song_List_Json[i]['album_id'])
 song_data_dict = {'downloadUrl':get_song_download_url(song_download_url),'fileName':Song_List_Json[i]['filename']}
 total.append(song_data_dict)
 return total
for i in range(1,18):
 URL='http://mobilecdngz.kugou.com/api/v3/rank/song?rankid=8888&ranktype=2&page=%s&pagesize=30&volid=&plat=2&version=8955&area_code=1' % i
 page_list_data = get_song_page_data(URL)
 for j in range(len(page_list_data)):
 print "%s %s" % (page_list_data[j]['fileName'],page_list_data[j]['downloadUrl'])
运行效果展示
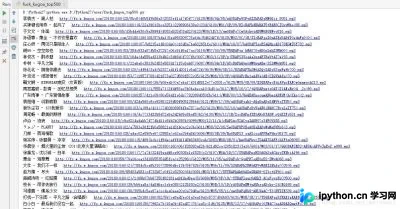
以下是通过Python抓取酷狗TOP500榜单数据的详细过程。
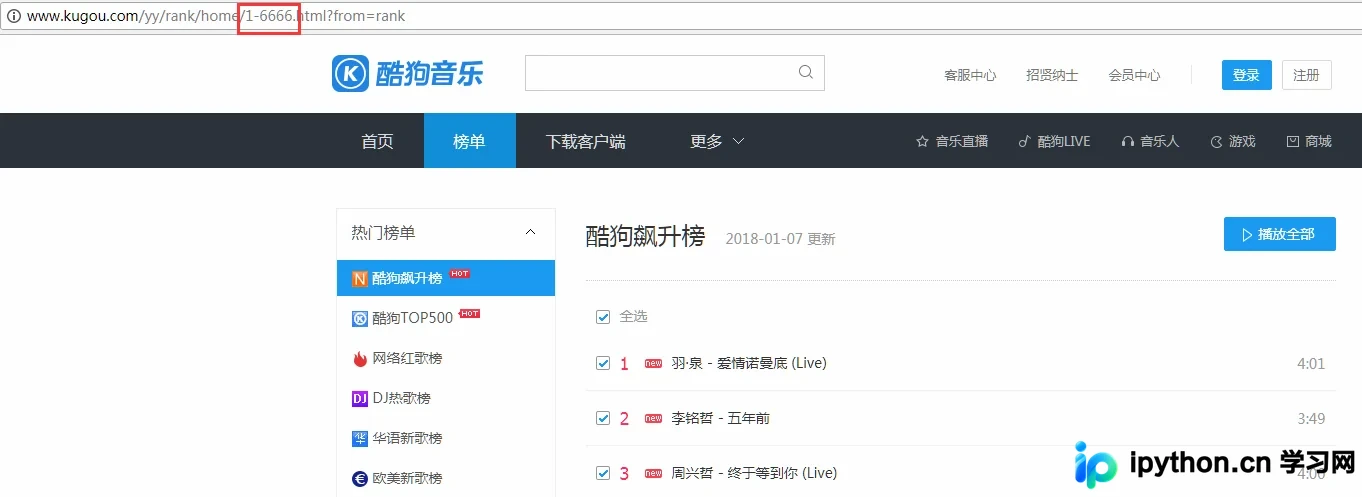
在爬取过程中,你可能会发现无法完整获取TOP500的所有数据。这是因为该榜单的URL规律仅在前几页有效,后续页面存在结构变化或跳转,导致无法直接遍历获取完整列表。为解决这一问题,我调整了策略,改为爬取酷狗飙升榜的前100首歌曲(参考上方提供的代码逻辑)。
希望酷狗平台能给予一定的宽容度,毕竟仅爬取100首数据对服务器负载影响极小。
from bs4 import BeautifulSoup
import requests
import time
headers={
 'User-Agent':'Mozilla/5.0 (Windows NT 6.1;WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/65.0.3298.4 Safari/537.36'
}
def get_info(url):
 wb_data = requests.get(url,headers=headers)
 soup = BeautifulSoup(wb_data.text,'lxml')
 ranks = soup.select('span.pc_temp_num')
 titles = soup.select('div.pc_temp_songlist > ul > li > a')
 times = soup.select('span.pc_temp_tips_r > span')
 for rank,title,time in zip(ranks,titles,times):
 data= {
  'rank':rank.get_text().strip(),
  'siger':title.get_text().split('-')[0],
  'song':title.get_text().split('-')[1],
  'time':time.get_text().strip()
 }
 print(data)
#酷狗飙升榜100首
if __name__ == '__main__':
 urls = ['http://www.kugou.com/yy/rank/home/{}-6666.html?from=rank/'.format(str(i)) for i in
range(1,6)]
 for url in urls:
 get_info(url)
 time.sleep(2)
总结
以上便是关于使用Python获取酷狗音乐TOP500榜单中歌曲MP3下载地址的详细介绍。希望本文内容能对你有所帮助。如果有任何疑问,欢迎留言咨询,我会及时回复。同时,非常感谢大家对本网站的支持!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















