



在 Debian 排查 JavaScript/Node.js 日志,先判断是临时排查、细筛,还是长期采集;工具不必多,关键是匹配场景。
先用 grep 快速定位关键词
已知事件含明确关键词时,先直接检索:
grep 'error' /var/log/myapp.log适合先捞出可疑日志;前提是关键词和日志字段较稳定。
需要时间窗口时,用 awk 或 sed 做细筛
要看指定时段内发生了什么,可按时间范围筛选:
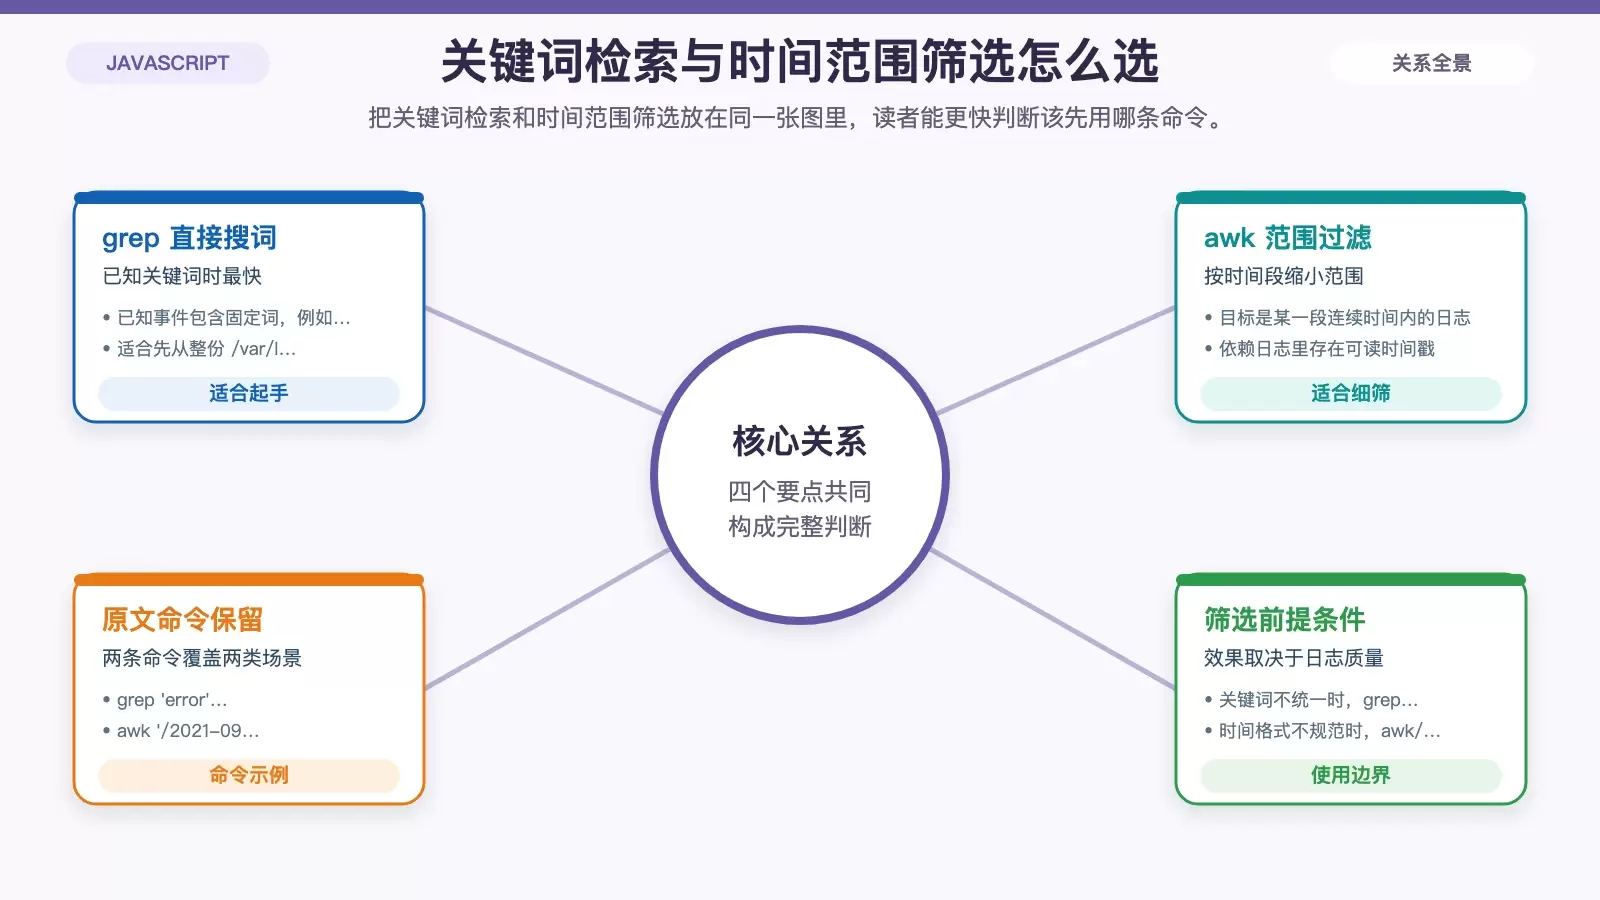
awk '/2021-09-01 12:00:00/, /2021-09-01 12:10:00/' /var/log/myapp.log这比全文件搜 error 更适合定位请求抖动、批处理失败、定时任务异常,但要求日志自带统一、可读的时间戳。
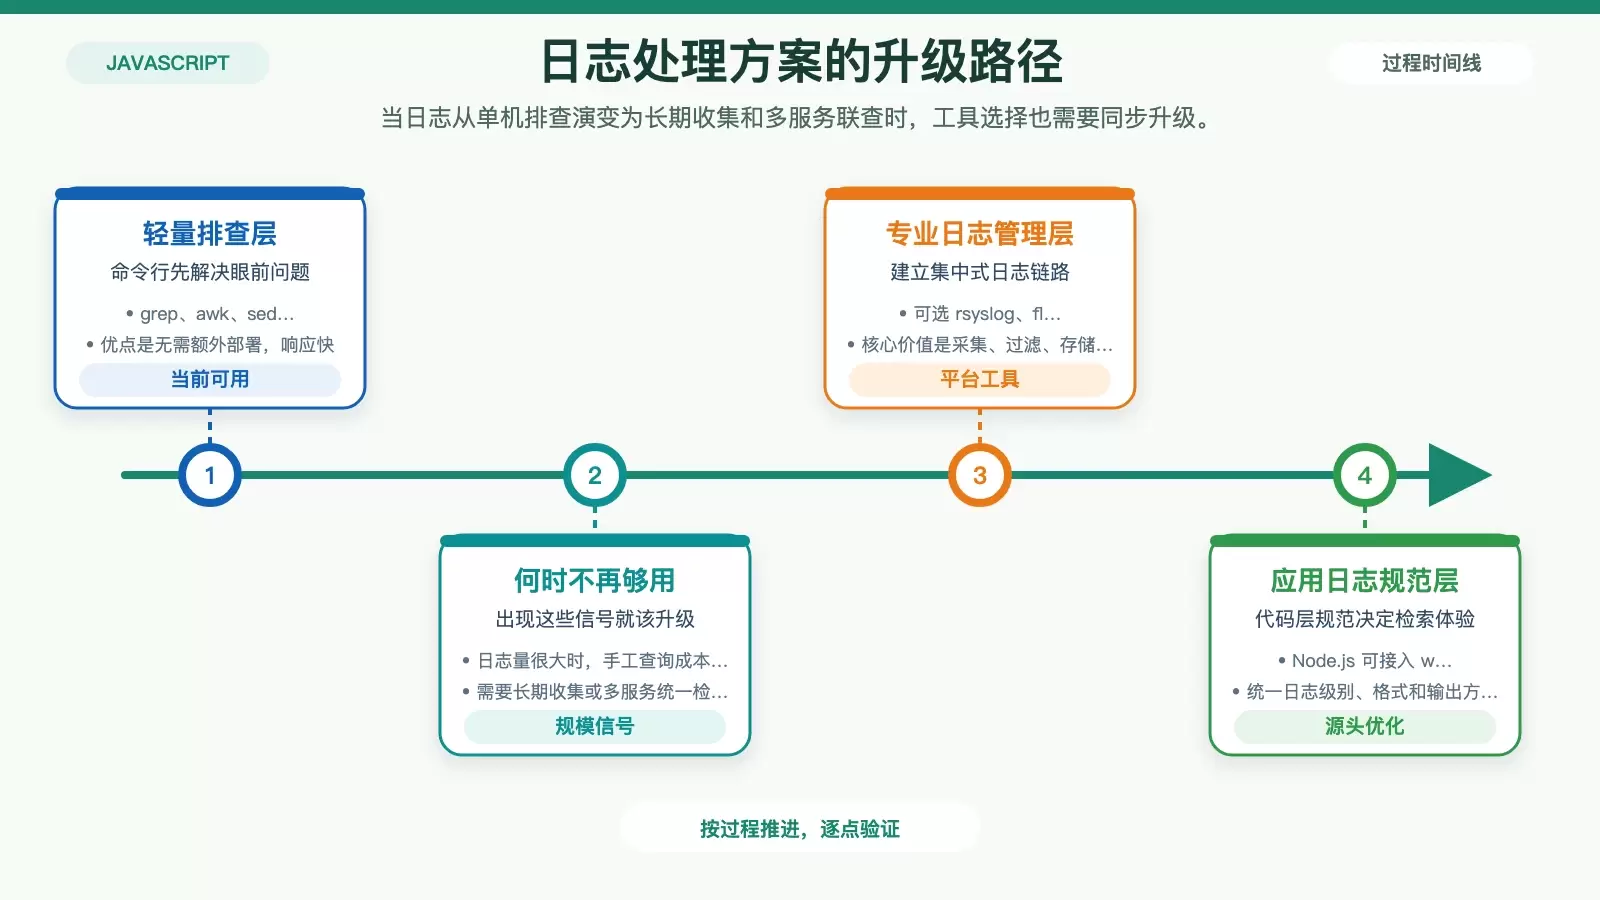
日志量变大后,再考虑专业日志管理工具
如果已进入长期收集、集中分析、多服务联查阶段,单靠命令行会吃力。可考虑 rsyslog、fluentd、logstash,统一采集、过滤、转发和存储。常见信号是:日志持续增大、要长期保留历史、多个 Node.js 服务需统一检索。
能改代码时,优先在 Node.js 里把日志打规范
若能改应用代码,优先规范日志源头。可用 winston、bunyan 统一日志级别、格式和输出位置。日志结构稳定后,无论继续用 grep/awk,还是接入集中化工具,筛选都会更高效。
筛选日志时别忽略敏感信息和完整性
日志中可能含用户标识、请求参数、错误堆栈或访问凭据,筛选与传输时要控制暴露范围;同时避免丢失、截断、覆盖,保证排查链路完整。
原文图片 URL:http://img.318050.com/uploads/20260730/17854033336a6b17c53d8ef196872066.webp















