


Python实现百度贴吧帖子全楼层图片批量下载

发布时间:2026-10-13 |
4人浏览过
本文提供基于Python 2.7的百度贴吧图片爬取完整代码。通过requests获取页面,利用BeautifulSoup解析img标签,结合正则表达式提取最大页码,实现自动遍历所有楼层并批量保存高清原图至本地指定目录。
本示例演示如何使用Python编写爬虫程序,以抓取百度贴吧帖子中所有楼层的图片资源。该方案可供读者参考学习。
主要目的是下载百度贴吧帖子中的图片,以便离线浏览。
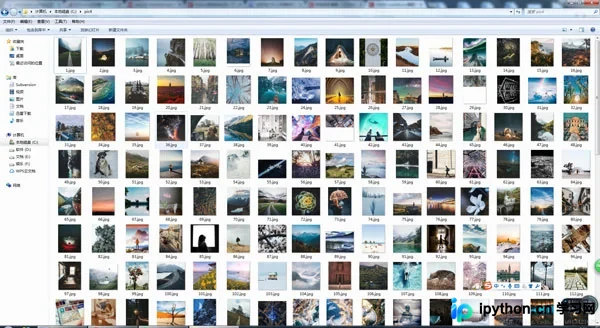
代码基于Python 2.7版本编写。
#coding=utf-8
import re
import requests
import urllib
from bs4 import BeautifulSoup
import time
time1=time.time()
def getHtml(url):
  page = requests.get(url)
  html =page.text
  return html
def getImg(html):
  soup = BeautifulSoup(html, 'html.parser')
  img_info = soup.find_all('img', class_='BDE_Image')
  global index
  for index,img in enumerate(img_info,index+1):
    print ("正在下载第{}张图片".format(index))
    urllib.urlretrieve(img.get("src"),'C:/pic4/%s.jpg' % index)
def getMaxPage(url):
  html = getHtml(url)
  reg = re.compile(r'max-page="(\d+)"')
  page = re.findall(reg,html)
  page = int(page[0])
  return page
if __name__=='__main__':
  url  = "https://tieba.baidu.com/p/5113603072"
  page = getMaxPage(url)
  index = 0
  for i in range(1,page):
    url = "%s%s" % ("https://tieba.baidu.com/p/5113603072?pn=",str(i))
    html = getHtml(url)
    getImg(html)
  print ("OK!All DownLoad!")
  time2=time.time()
  print u'总共耗时:' + str(time2 - time1) + 's'
此外,推荐以下两款正则表达式辅助工具供参考:
JavaScript正则表达式在线测试工具: http://tools.jb51.net/regex/javascript
正则表达式在线生成工具: http://tools.jb51.net/regex/create_reg
如需了解更多Python相关知识,可查阅本站相关专题,包括《Python Socket编程技巧总结》、《Python正则表达式用法总结》、《Python数据结构与算法教程》、《Python函数使用技巧总结》、《Python字符串操作技巧汇总》、《Python入门与进阶经典教程》以及《Python文件与目录操作技巧汇总》。
希望本示例对您的Python编程学习有所帮助。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















