


Python Socket网络编程:深入解析粘包问题与解决方案

本文详细解析Python Socket编程中的粘包现象,区分TCP与UDP在数据传输上的差异。深入探讨粘包的成因(Nagle算法、缓冲区机制),并提供从简单延时到基于Struct模块自定义报头的多种解决方案,帮助开发者掌握高效可靠的数据传输技巧。
一、粘包问题详解
1. 仅TCP存在粘包现象,UDP协议不会发生粘包。
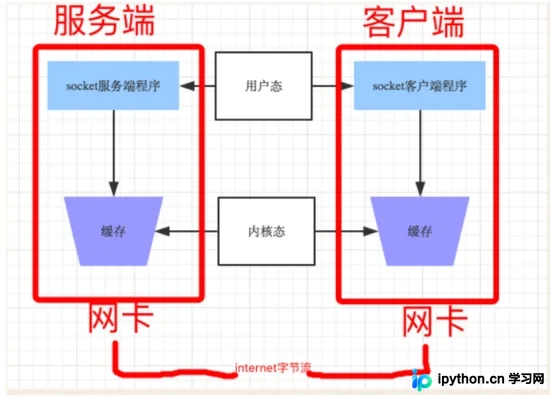
用户程序无法直接操作网卡,而是通过操作系统提供的接口进行交互。当程序向远程发送数据时,数据需先从用户态拷贝至内核态,这一过程消耗资源且耗时。若频繁在用户态与内核态间交换数据,发送效率将显著降低。因此,Socket为提高传输效率,通常会收集足够多的数据后才进行发送。如果连续多次发送的数据量较少,TCP Socket往往会根据优化算法将这些数据合并为一个TCP段后一次性发送,导致接收方接收到粘包数据。
2. 掌握Socket收发消息的基本原理
发送端可以以1KB为单位发送数据,而接收端的应用程序可以以2KB、3KB或多KB为单位提取数据。这种应用程序层面的不可见性使得TCP协议成为面向流的协议,这也是粘包现象易发的原因。相比之下,UDP是面向无连接的协议,每个UDP数据报都是一条独立的消息。应用程序必须以消息为单位提取数据,不能一次性提取任意字节的数据,这与TCP有显著不同。如何定义消息?通常认为对方一次性write/send的数据为一个消息。需要注意的是,当对方发送一条信息时,无论TCP层如何分段或分片,TCP协议层都会将构成整条消息的数据段排序完成后,才呈现在内核缓冲区中。
例如,基于TCP的套接字客户端向服务器端上传文件时,发送的数据是按照字节流一段一段发送的。在接收方看来,由于缺乏明确的边界信息,无法判断文件字节流的起始位置和结束位置。
3. 粘包产生的原因分析
3-1 直接原因
粘包问题的直接原因在于接收方无法知晓消息之间的界限,因此不知道一次性应该提取多少字节的数据。
3-2 根本原因
由发送方引起的粘包源于TCP协议本身的特性。为了提高传输效率,发送方通常会收集足够多的数据后才发送一个TCP段。如果连续几次需要send的数据量都很少,TCP通常会根据优化算法将这些数据合并为一个TCP段后一次性发送出去,从而导致接收方收到粘包数据。
3-3 总结
- TCP(传输控制协议)是面向连接的、面向流的,提供高可靠性服务。收发两端(客户端和服务器端)都必须拥有成对的Socket。因此,发送端为了将多个发往接收端的包更有效地发送到对方,使用了优化方法(如Nagle算法),将多次间隔较小且数据量小的数据合并成一个大的数据块,然后进行封包。这使得接收端难以分辨数据边界,必须提供科学的拆包机制,即面向流的通信是无消息保护边界的。
- UDP(用户数据报协议)是无连接的、面向消息的,提供高效率服务。它不使用块的合并优化算法。由于UDP支持一对多的模式,接收端的skbuff(套接字缓冲区)采用链式结构来记录每一个到达的UDP包。每个UDP包中包含了消息头(如消息来源地址、端口等信息),这使得接收端易于进行区分处理,即面向消息的通信是有消息保护边界的。
- TCP基于数据流,因此收发的消息不能为空,这需要在客户端和服务端都添加空消息的处理机制,以防止程序卡住。而UDP基于数据报,即使输入的是空内容(直接回车),也不是空消息,UDP协议会为其封装上消息头(实验略)。
UDP的recvfrom是阻塞的,一个recvfrom(x)必须对应唯一一个sendinto(y)。接收完x个字节的数据即算完成,若y>x则数据丢失。这意味着UDP根本不会发生粘包,但会丢数据,属于不可靠传输。
TCP的协议数据不会丢失,若未收完包,下次接收时会继续上次未接收的部分。己端总是在收到ack时才会清除缓冲区内容。数据是可靠的,但可能会发生粘包。
二、两种会导致粘包的情况
1. 发送端需等待本机缓冲区满后才发送数据,造成粘包(发送数据时间间隔很短,数据量小,Python使用了优化算法将数据合并,产生粘包)。
客户端代码示例
#_*_coding:utf-8_*_
import socket
BUFSIZE=1024
ip_port=('127.0.0.1',8080)
s=socket.socket(socket.AF_INET,socket.SOCK_STREAM)
res=s.connect_ex(ip_port)
s.send('hello'.encode('utf-8'))
s.send('feng'.encode('utf-8'))
服务端代码示例
#_*_coding:utf-8_*_
from socket import *
ip_port=('127.0.0.1',8080)
tcp_socket_server=socket(AF_INET,SOCK_STREAM)
tcp_socket_server.bind(ip_port)
tcp_socket_server.listen(5)
conn,addr=tcp_socket_server.accept()
data1=conn.recv(10)
data2=conn.recv(10)
print('----->',data1.decode('utf-8'))
print('----->',data2.decode('utf-8'))
conn.close()
2. 接收端不及时接收缓冲区的包,造成多个包被接收(客户端发送一段数据,服务端只接收了一小部分,服务端下次再接收时,会从缓冲区中取出上次遗留的数据,从而产生粘包)。
#_*_coding:utf-8_*_
import socket
BUFSIZE=1024
ip_port=('127.0.0.1',8080)
s=socket.socket(socket.AF_INET,socket.SOCK_STREAM)
res=s.connect_ex(ip_port)
s.send('hello feng'.encode('utf-8'))
客户端代码示例
#_*_coding:utf-8_*_
from socket import *
ip_port=('127.0.0.1',8080)
tcp_socket_server=socket(AF_INET,SOCK_STREAM)
tcp_socket_server.bind(ip_port)
tcp_socket_server.listen(5)
conn,addr=tcp_socket_server.accept()
data1=conn.recv(2) #一次没有收完整
data2=conn.recv(10)#下次收的时候,会先取旧的数据,然后取新的
print('----->',data1.decode('utf-8'))
print('----->',data2.decode('utf-8'))
conn.close()
服务端代码示例
三、粘包实例演示
import socket
import subprocess
din=socket.socket(socket.AF_INET,socket.SOCK_STREAM)
ip_port=('127.0.0.1',8080)
din.bind(ip_port)
din.listen(5)
conn,deer=din.accept()
data1=conn.recv(1024)
data2=conn.recv(1024)
print(data1)
print(data2)
服务端代码示例
import socket
import subprocess
din=socket.socket(socket.AF_INET,socket.SOCK_STREAM)
ip_port=('127.0.0.1',8080)
din.connect(ip_port)
din.send('helloworld'.encode('utf-8'))
din.send('sb'.encode('utf-8'))
四、拆包的发生情况
当发送端缓冲区的长度大于网卡的MTU(最大传输单元)时,TCP会将这次发送的数据拆分成几个数据包发送过去。
补充问题一:为何TCP是可靠传输,而UDP是不可靠传输?
关于TCP传输的更多参考:https://www.jb51.net/network/176867.html
TCP在数据传输时,发送端先将数据发送到自己的缓存中,然后协议控制将缓存中的数据发往对端。对端返回一个ack=1,发送端则清理缓存中的数据;若对端返回ack=0,则重新发送数据。因此,TCP是可靠的。
而UDP发送数据时,对端不会返回确认信息,因此属于不可靠传输。
补充问题二:send(字节流)和recv(1024)及sendall的含义是什么?
recv中指定的1024表示从缓存中一次取出1024个字节的数据。
send的字节流是先放入己端缓存,然后由协议控制将缓存内容发往对端。如果字节流大小大于缓存剩余空间,数据可能会丢失。使用sendall会循环调用send,确保数据不会丢失。
五、粘包问题的解决方案
问题的根源在于接收端不知道发送端将要传送的字节流的长度。因此,解决粘包的方法核心在于:如何让发送端在发送数据前,将自己将要发送的字节流总大小告知接收端,然后接收端通过一个死循环接收完所有数据。
5-1 简单的解决方法(表面解决)
在客户端发送数据后添加时间睡眠,并在服务端接收时也进行时间睡眠,可以有效避免粘包现象。
客户端代码示例
#客户端
import socket
import time
import subprocess
din=socket.socket(socket.AF_INET,socket.SOCK_STREAM)
ip_port=('127.0.0.1',8080)
din.connect(ip_port)
din.send('helloworld'.encode('utf-8'))
time.sleep(3)
din.send('sb'.encode('utf-8'))
服务端代码示例
#服务端
import socket
import time
import subprocess
din=socket.socket(socket.AF_INET,socket.SOCK_STREAM)
ip_port=('127.0.0.1',8080)
din.bind(ip_port)
din.listen(5)
conn,deer=din.accept()
data1=conn.recv(1024)
time.sleep(4)
data2=conn.recv(1024)
print(data1)
print(data2)
上述解决方法存在诸多纰漏,因为你无法预知传输何时完成。时间暂停的长短难以把握:过长则效率低,过短则不合适。因此,这种方法并不推荐。
5-2 普通的解决方法(根本解决)
问题的根源在于接收端不知道发送端将要传送的字节流的长度。解决粘包的方法核心在于:如何让发送端在发送数据前,将自己将要发送的字节流总大小告知接收端,然后接收端通过一个死循环接收完所有数据。
为字节流加上自定义的固定长度报头,报头中包含字节流的长度。然后依次send到对端,对端在接受时,先从缓存中取出定长的报头,然后再取真实数据。
使用struct模块对打包的长度进行固定处理,可以是4个字节或8个字节。当struct.pack.format参数为“i”时,只能打包长度为10的数字(注:此处原文表述可能有误,通常指打包整数)。此外,还可以先将长度转化为json字符串,再进行打包。
普通客户端代码示例
# _*_ coding: utf-8 _*_
import socket
import struct
phone = socket.socket(socket.AF_INET,socket.SOCK_STREAM)
phone.connect(('127.0.0.1',8880)) #连接服
while True:
 # 发收消息
 cmd = input('请你输入命令>>:').strip()
 if not cmd:continue
 phone.send(cmd.encode('utf-8')) #发送

 #先收报头
 header_struct = phone.recv(4) #收四个
 unpack_res = struct.unpack('i',header_struct)
 total_size = unpack_res[0] #总长度

 #后收数据
 recv_size = 0
 total_data=b''
 while recv_size<total_size: #循环的收
  recv_data = phone.recv(1024) #1024只是一个最大的限制
  recv_size+=len(recv_data) #
  total_data+=recv_data #
 print('返回的消息:%s'%total_data.decode('gbk'))
phone.close()
普通服务端代码示例
# _*_ coding: utf-8 _*_
import socket
import subprocess
import struct
phone = socket.socket(socket.AF_INET,socket.SOCK_STREAM) #买手机
phone.bind(('127.0.0.1',8880)) #绑定手机卡
phone.listen(5) #阻塞的最大数
print('start runing.....')
while True: #链接循环
 coon,addr = phone.accept()# 等待接电话
 print(coon,addr)
 while True: #通信循环

  # 收发消息
  cmd = coon.recv(1024) #接收的最大数
  print('接收的是:%s'%cmd.decode('utf-8'))

  #处理过程

  res = subprocess.Popen(cmd.decode('utf-8'),shell = True,
           stdout=subprocess.PIPE, #标准输出
           stderr=subprocess.PIPE #标准错误
        )
  stdout = res.stdout.read()
  stderr = res.stderr.read()

  #先发报头(转成固定长度的bytes类型,那么怎么转呢?就用到了struct模块)
  #len(stdout) + len(stderr)#统计数据的长度
  header = struct.pack('i',len(stdout)+len(stderr))#制作报头
  coon.send(header)

  #再发命令的结果
  coon.send(stdout)
  coon.send(stderr)
 coon.close()
phone.close()
5-3 优化版的解决方法(根本解决)
优化的解决粘包问题的思路是:服务端将报头信息进行优化,对要发送的内容用字典进行描述。首先,字典不能直接进行网络传输,需要序列化为json格式化字符串,然后转换为bytes格式由服务端发送。由于bytes格式的json字符串长度不固定,因此需要用struct模块将bytes格式的json字符串长度压缩成固定长度,发送给客户端。客户端接收后,反解即可得到完整的数据包。
终极版客户端代码示例
# _*_ coding: utf-8 _*_
import socket
import struct
import json
phone = socket.socket(socket.AF_INET,socket.SOCK_STREAM)
phone.connect(('127.0.0.1',8080)) #连接服务器
while True:
 # 发收消息
 cmd = input('请你输入命令>>:').strip()
 if not cmd:continue
 phone.send(cmd.encode('utf-8')) #发送

 #先收报头的长度
 header_len = struct.unpack('i',phone.recv(4))[0] #吧bytes类型的反解

 #在收报头
 header_bytes = phone.recv(header_len) #收过来的也是bytes类型
 header_json = header_bytes.decode('utf-8') #拿到json格式的字典
 header_dic = json.loads(header_json) #反序列化拿到字典了
 total_size = header_dic['total_size'] #就拿到数据的总长度了

 #最后收数据
 recv_size = 0
 total_data=b''
 while recv_size<total_size: #循环的收
  recv_data = phone.recv(1024) #1024只是一个最大的限制
  recv_size+=len(recv_data) #有可能接收的不是1024个字节,或许比1024多呢,
  # 那么接收的时候就接收不全,所以还要加上接收的那个长度
  total_data+=recv_data #最终的结果
 print('返回的消息:%s'%total_data.decode('gbk'))
phone.close()
终极版服务端代码示例
# _*_ coding: utf-8 _*_
import socket
import subprocess
import struct
import json
phone = socket.socket(socket.AF_INET,socket.SOCK_STREAM) #买手机
phone.setsockopt(socket.SOL_SOCKET,socket.SO_REUSEADDR,1)
phone.bind(('127.0.0.1',8080)) #绑定手机卡
phone.listen(5) #阻塞的最大数
print('start runing.....')
while True: #链接循环
 coon,addr = phone.accept()# 等待接电话
 print(coon,addr)

 while True: #通信循环
  # 收发消息
  cmd = coon.recv(1024) #接收的最大数
  print('接收的是:%s'%cmd.decode('utf-8'))

  #处理过程
  res = subprocess.Popen(cmd.decode('utf-8'),shell = True,
           stdout=subprocess.PIPE, #标准输出
           stderr=subprocess.PIPE #标准错误
        )
  stdout = res.stdout.read()
  stderr = res.stderr.read()

  # 制作报头
  header_dic = {
   'total_size': len(stdout)+len(stderr), # 总共的大小
   'filename': None,
   'md5': None
  }
  header_json = json.dumps(header_dic) #字符串类型
  header_bytes = header_json.encode('utf-8') #转成bytes类型(但是长度是可变的)

  #先发报头的长度
  coon.send(struct.pack('i',len(header_bytes))) #发送固定长度的报头

  #再发报头
  coon.send(header_bytes)

  #最后发命令的结果
  coon.send(stdout)
  coon.send(stderr)
 coon.close()
phone.close()
六、Struct模块详解
了解C语言的人一定知道struct结构体在C语言中的作用,它定义了一种结构,里面包含不同类型的数据(int、char、bool等),方便对某一结构对象进行处理。在网络通信中,大多传递的数据是以二进制流(binary data)存在的。当传递字符串时,不必担心太多问题;而当传递诸如int、char之类的基本数据时,就需要有一种机制将某些特定的结构体类型打包成二进制流的字符串,然后在网络传输。接收端也应该可以通过某种机制进行解包,还原出原始的结构体数据。Python中的struct模块就提供了这样的机制,该模块的主要作用就是对Python基本类型值与用Python字符串格式表示的C struct类型间的转化(This module performs conversions between Python values and C structs represented as Python strings.)。struct模块提供了几个简单的函数,下面通过几个例子进行说明。
1. 基本的pack和unpack
struct提供用format specifier方式对数据进行打包和解包(Packing and Unpacking)。例如:
#该模块可以把一个类型,如数字,转成固定长度的bytes类型
import struct
# res = struct.pack('i',12345)
# print(res,len(res),type(res)) #长度是4
res2 = struct.pack('i',12345111)
print(res2,len(res2),type(res2)) #长度也是4
unpack_res =struct.unpack('i',res2)
print(unpack_res) #(12345111,)
# print(unpack_res[0]) #12345111
代码中,首先定义了一个元组数据,包含int、string、float三种数据类型,然后定义了struct对象,并指定了format 'I3sf'。I表示int,3s表示三个字符长度的字符串,f表示float。最后通过struct的pack和unpack进行打包和解包。通过输出结果可以发现,value被pack之后,转化为了一段二进制字节串,而unpack可以把该字节串再转换回一个元组。但值得注意的是,对于float的精度发生了改变,这是由操作系统等客观因素所决定的。打包之后的数据所占用的字节数与C语言中的struct十分相似。
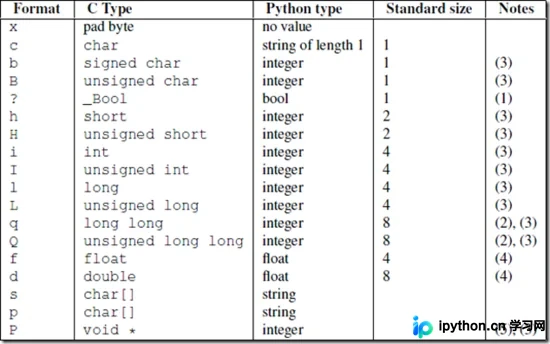
2. 定义format可参照官方API提供的对照表:
3. 基本用法
import json,struct
#假设通过客户端上传1T:1073741824000的文件a.txt
#为避免粘包,必须自定制报头
header={'file_size':1073741824000,'file_name':'/a/b/c/d/e/a.txt','md5':'8f6fbf8347faa4924a76856701edb0f3'} #1T数据,文件路径和md5值

#为了该报头能传送,需要序列化并且转为bytes
head_bytes=bytes(json.dumps(header),encoding='utf-8') #序列化并转成bytes,用于传输

#为了让客户端知道报头的长度,用struck将报头长度这个数字转成固定长度:4个字节
head_len_bytes=struct.pack('i',len(head_bytes)) #这4个字节里只包含了一个数字,该数字是报头的长度

#客户端开始发送
conn.send(head_len_bytes) #先发报头的长度,4个bytes
conn.send(head_bytes) #再发报头的字节格式
conn.sendall(文件内容) #然后发真实内容的字节格式

#服务端开始接收
head_len_bytes=s.recv(4) #先收报头4个bytes,得到报头长度的字节格式
x=struct.unpack('i',head_len_bytes)[0] #提取报头的长度
head_bytes=s.recv(x) #按照报头长度x,收取报头的bytes格式
header=json.loads(json.dumps(header)) #提取报头

#最后根据报头的内容提取真实的数据,比如
real_data_len=s.recv(header['file_size'])
s.recv(real_data_len)
以上就是本文的全部内容,希望对大家的学习有所帮助,也希望大家多多支持本站。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















