


Python自动化整理Word简历:批量提取信息并生成Excel导航

本文介绍如何利用Python批量整理数百份Word简历。通过遍历文件夹、规范文件名、转换doc格式,并提取关键信息写入Excel。重点解决Mac环境下解析doc文件的兼容性问题,利用相对路径生成可点击的附件链接,实现快速导航与数据汇总,减少重复人工操作。
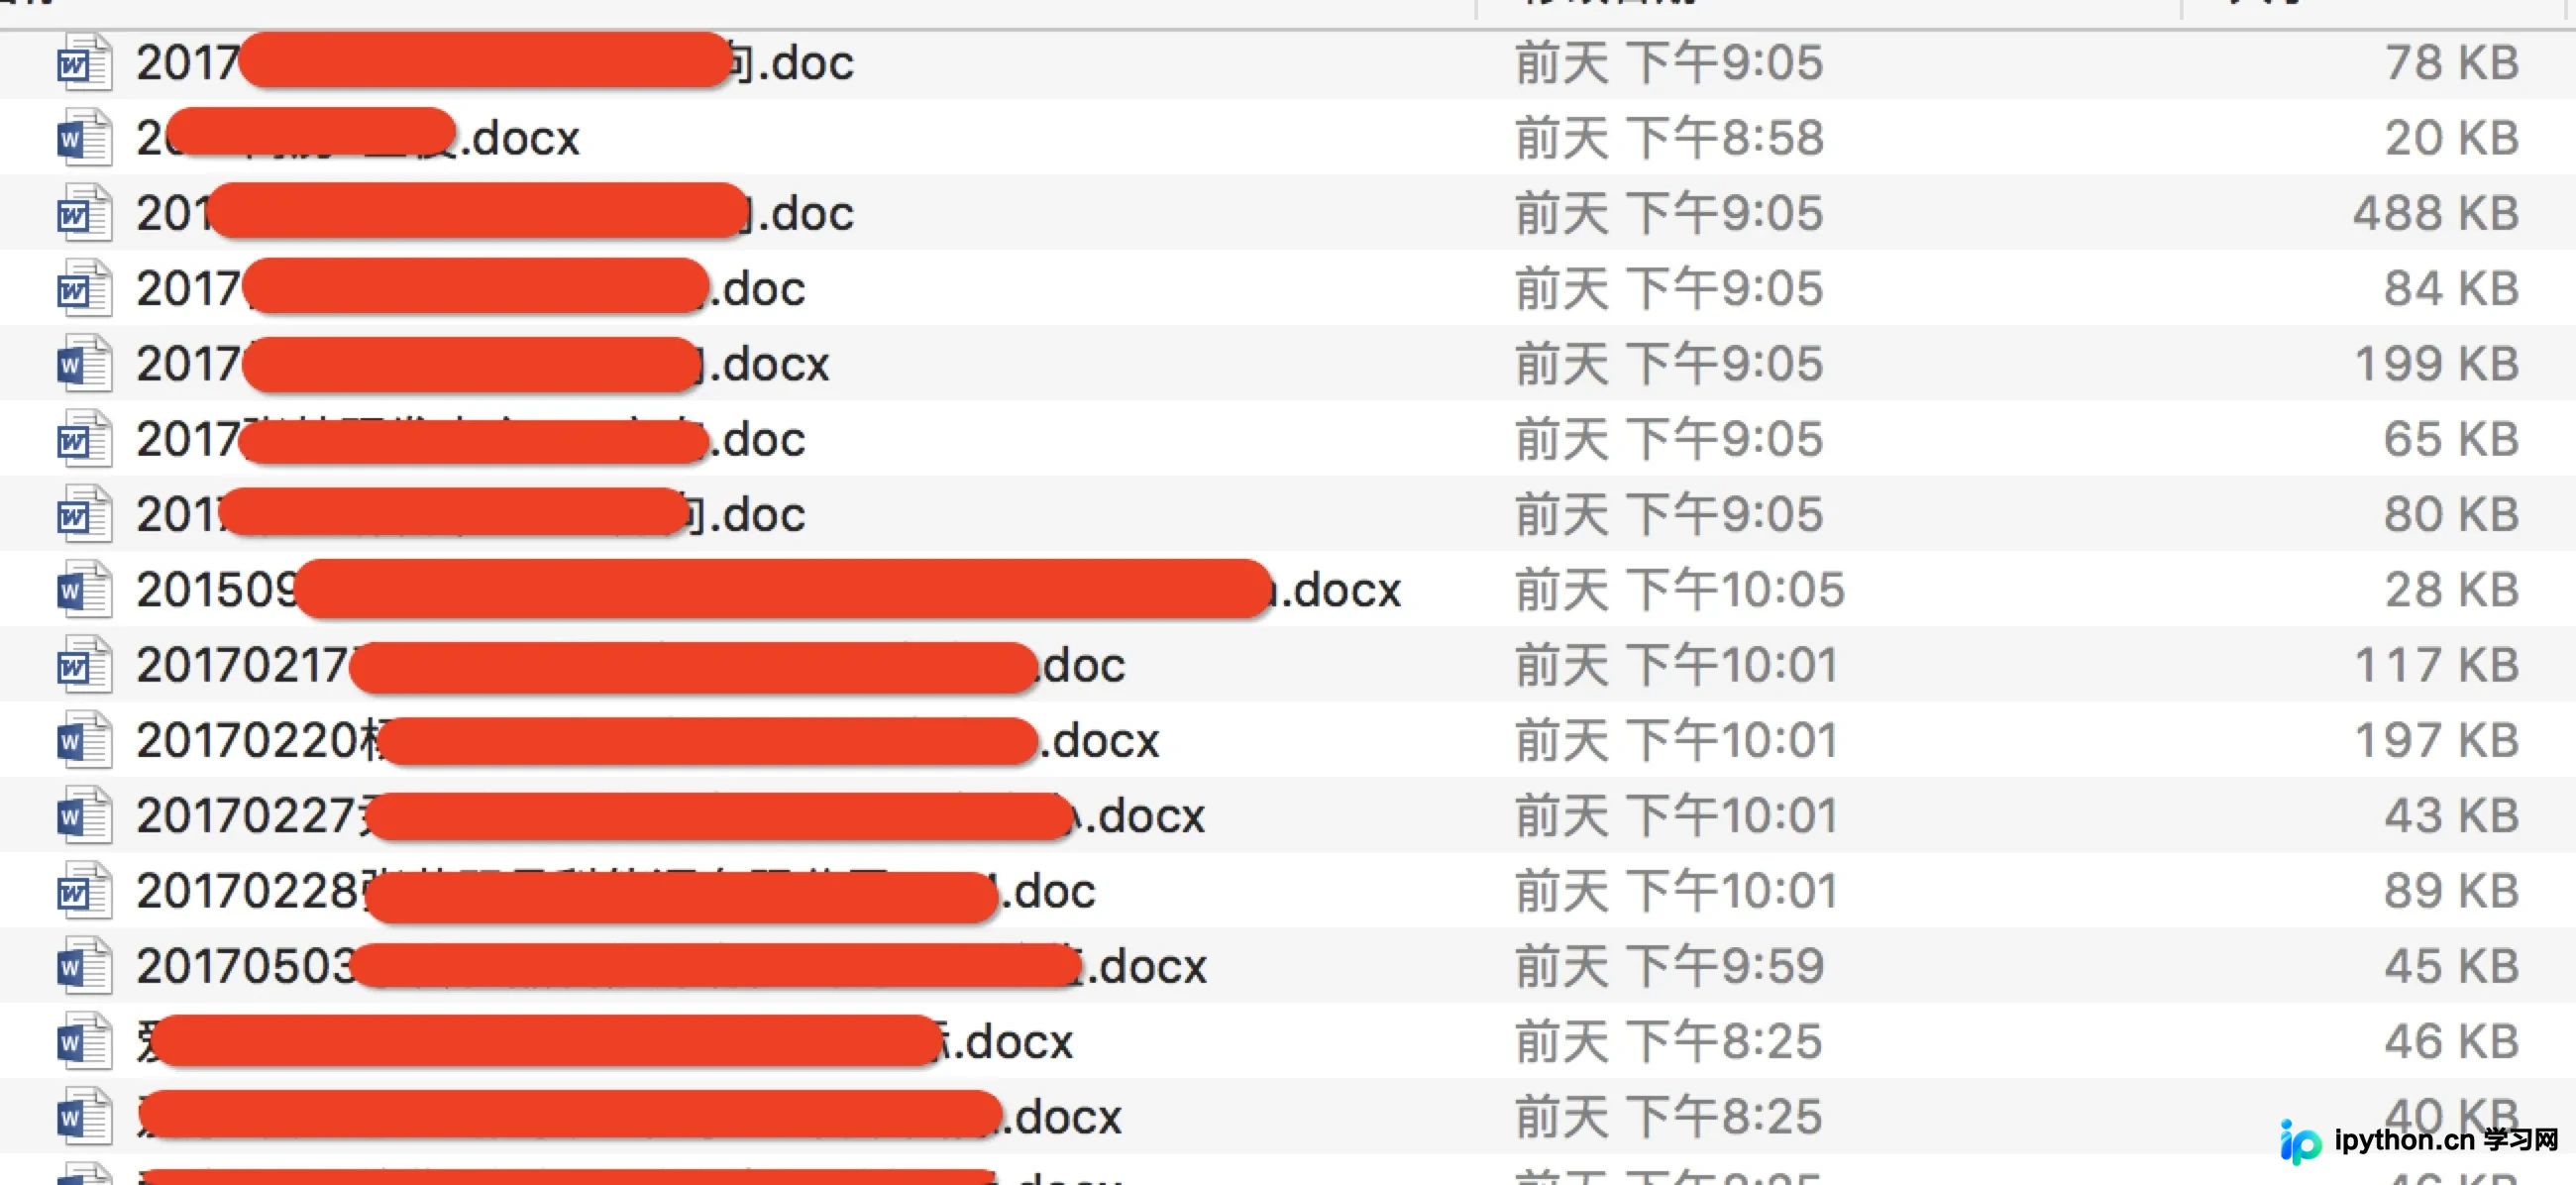
当前文件夹内包含500多份简历文件。若需查询学校、学历等特定信息,逐一打开Word文档查看效率极低。此时,使用Python进行自动化处理成为必要选择。
目标
面对600余份类似截图所示的Word文件,主要目标是进行基础整理:
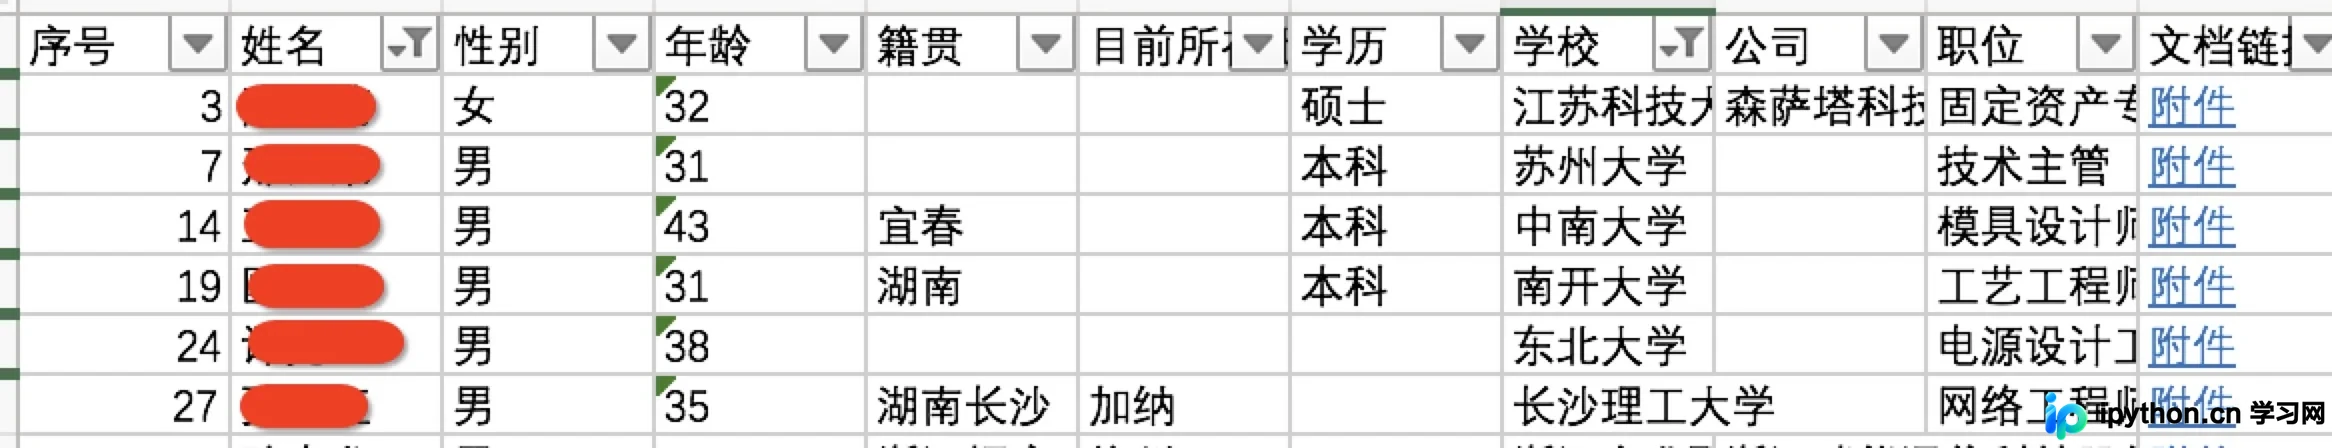
最终输出一份Excel导航表(类似目录功能),通过该表格可快速定位并跳转至对应附件,效果如下所示:
具体实现
明确目标后,具体实施思路较为清晰:遍历所有Word文件,提取其中的关键字段,并将结果保存至Excel文件中。
主要涉及以下模块:
import xlsxwriter
import subprocess
import os
import docx
import sys
import re
xlsxwriter用于操作Excel,该库仅支持写入操作,但效率高于xlwt;若数据量不大,使用xlwt亦可。
subprocess用于调用命令行工具。由于docx模块无法直接解析旧版.doc格式的Word文件,因此需在解析前将.doc文件转换为.docx格式。
os模块主要用于遍历文件夹以获取文件列表。
docx模块用于解析Word文档内容。
规范下文件名
首先对文件名进行规范化处理。因为在调用subprocess.call执行命令时,文件名中的空格或特殊符号可能导致转义失败从而引发报错,提前清理这些潜在问题可避免错误。
def remove_doc_special_tag():
  for filename in os.listdir(path):
    otherName = re.sub("[\s+\!\/_,$%^*(+\"\')]+|[+——()?【】“”!,。?、~@#¥%……&*()]+", "",filename)
    os.rename(os.path.join(path,filename),os.path.join(path,otherName))
遍历文件
随后进入核心环节,遍历每个文件并进行解析:
path='/Users/cavin/Desktop/files'
for filename in os.listdir(path):
  ...具体逻辑...
此处遇到一个难点:docx模块无法解析.doc格式文档,且由于使用Mac系统,无法调用win32com模块,导致处理较为棘手。经搜索发现,可通过命令行工具将.doc转换为.docx格式。
需注意,转换后的.docx文件样式可能会丢失,但这不影响提取文本信息的需求。
因此编写了相应代码:若文件为.doc格式,优先将其转换为.docx,解析完成后立即删除临时转换文件。
if filename.endswith('.doc'):
  subprocess.call('textutil -convert docx {0}'.format(fullname),shell=True)
  fullname=fullname[:-4]+".docx"
  sheetModel= etl_word_files(fullname)#解析文本逻辑
  subprocess.call('rm {0}'.format(fullname),shell=True) #移除转换的文件
解析word文件
接下来执行文件解析。利用docx模块可轻松实现,具体解析逻辑未在此展示,主要是遍历每一行,依据关键字和符号截取数据(鉴于大多数简历格式基本一致)。
doc = docx.Document(fullname)
for para in doc.paragraphs:
  print(para.text)
  ...具体解析逻辑...
填充excel
解析得到的数据可直接填充至Excel中:
workbook = xlsxwriter.Workbook('report_list.xlsx')
worksheet = workbook.add_worksheet('list')
worksheet.write(0,0, '序号')
worksheet.write(0,1, '姓名')
worksheet.write(0,2, '性别')
worksheet.write(0,3, '年龄')
worksheet.write(0,4, '籍贯')
worksheet.write(0,5, '目前所在地')
worksheet.write(0,6, '学历')
worksheet.write(0,7, '学校')
worksheet.write(0,8, '公司')
worksheet.write(0,9, '职位')
worksheet.write(0,10, '文档链接')
此处重点说明文档链接的填充方式。为确保他人使用时附件与Excel位于同一文件夹,采用相对路径方式,可借助Excel的HYPERLINK函数实现:
worksheet.write(index,10, '=HYPERLINK(\"./'+filename+'\",\"附件\")')
问题点
至此,基本功能已实现,但尚不完美。主要问题在于Word文档格式不规范,难以通过固定方式准确提取所有目标数据。不过,姓名、学校等核心信息大多已成功抓取,一定程度上减轻了工作量。
总结
利用Python确实减少了部分重复性劳动,但面对格式不标准的文档,目前仍缺乏通用的完美解决方案。
虽然可以增加逻辑以兼容各类非标准格式,但显然投入与产出比并不成正比。
关键在于善用现有工具提升效率。至于选择傻瓜式的重复劳动,还是通过代码减少重复工作,取决于个人的取舍。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















