


Python实现用户评论属性与情感词匹配提取

发布时间:2026-10-13 |
2人浏览过
本文介绍一种基于Python的中文用户评论处理方法,旨在从评论文本中自动提取评价对象(属性词)及对应的情感表达。通过观察发现属性词常与情感词伴随出现,且多为名词或形容词。文章提供了详细的算法流程图、示例数据及完整代码实现,展示如何遍历分词结果,识别名词后的情感描述,并处理否定词等特殊情况,最终输出结构化的匹配结果。
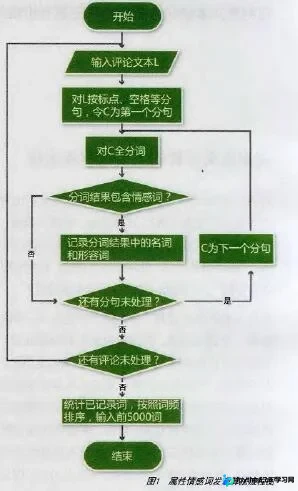
在分析用户评论数据时,我们注意到一个显著现象:属性词通常与情感词共同出现。这是因为用户在描述产品或服务的特定属性时,往往会附带表达对该属性的情感态度,此时属性成为了情感指向的对象。此外,观察还表明,属性词和专用情感词在词性上主要体现为名词或形容词(即形谓词)。
具体的算法处理流程如下图所示:
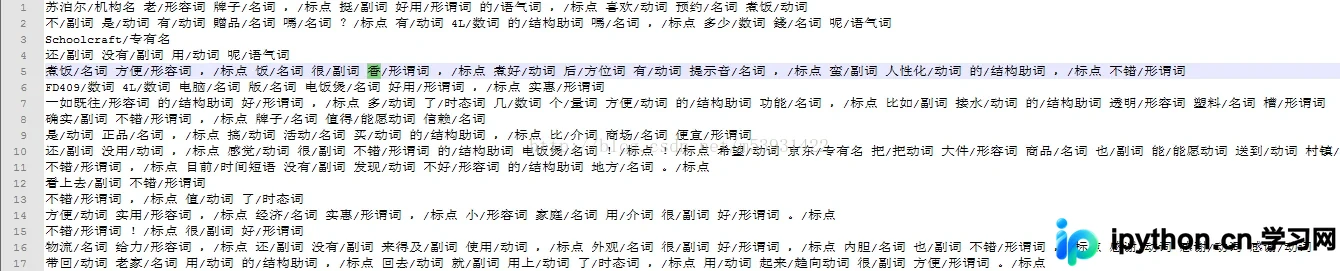
示例评论数据如下所示:
实现该功能的Python代码如下:
#encoding=utf-8

#############################
#
# 功能:给定一些中文的产品评论,希望从中找到评价对象及评价词。
#
# @author:licl
#
##############################

fdata = open('JD_DFB_comments_out.txt','r')
Output = open('Pattern_Result.txt','a')

try:
 data = fdata.readlines()

 listline = []


 for line in data:

  listline = line.replace(" ","/")
  listline = listline.split("/")

  i = 1

  while i < len(listline):

   if listline[i] != "名词":

    i = i+2

   else:

    new_list = ["","",""]
    new_list[0] = listline[i-1]

    a = i-1
    i = i+2

    while i < len(listline):

     if listline[i] == "标点":

      i = i+2
      break

     else:

      if listline[i-1]=='不' or listline[i-1]=='不怎么样' or listline[i-1]=='不怎么' or listline[i-1]=='不太':
       new_list[1] = listline[i-1]
      if listline[i] == "形容词" or listline[i] == "形谓词":
       new_list[1] += listline[i-1]

       b = i-1
       t = (b-a)/2
       new_list[2] = str(t)
       for line in new_list:

        Output.write(line + " ")

       Output.write("\n")
       break

      else:

       i = i+2
except:
 print "‘文件不存在'或者‘文件无法打开'"

finally:

 fdata.close()
 Output.close()
以上即为本文介绍的全部内容,希望这些内容能对您的学习或工作有所帮助,同时也欢迎大家继续支持本站。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















