



Rust 程序在 Ubuntu 上要跑得更快,第一步通常不是重写代码,而是先把编译方式、运行模型和分析工具用对。下面按编译优化、代码层改写、并发与内存、性能定位和系统参数几个层面展开,帮助你判断哪些手段见效最快,哪些只应在确认瓶颈后再投入。
先把编译优化吃满:这是最省成本的一步
对大多数 Rust 项目来说,最容易被忽略、但收益往往最直接的优化,就是不要再用默认的调试构建去评估性能。在 Ubuntu 上编译正式程序时,优先使用下面这条命令:
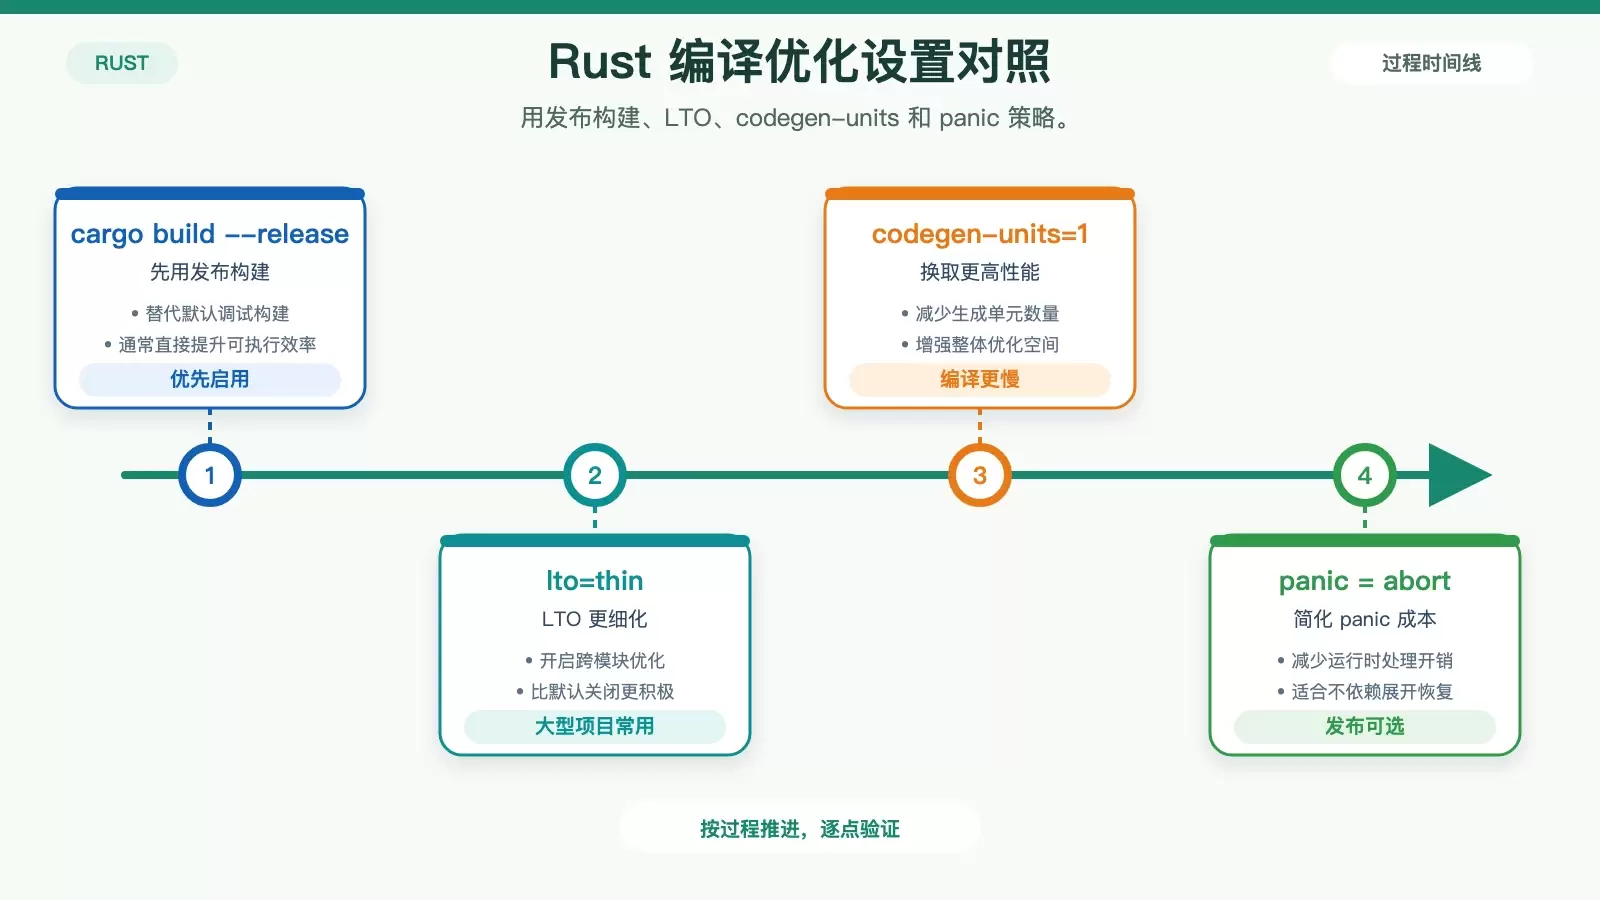
cargo build --release相比默认的 cargo build,发布构建会启用更激进的优化参数,典型包括 opt-level=3,并配合发布配置生成效率高得多的可执行文件。很多情况下,这一步就能拉开明显差距。
如果默认发布构建仍不够,可以继续通过 RUSTFLAGS 做精细调整:
RUSTFLAGS="-C opt-level=3 -C lto=thin"这里的 lto=thin 适合不少大型项目。它比默认关闭的 LTO 更容易在控制编译成本的同时,获得更好的跨模块优化效果。
另一个常见手段是减少代码生成单元数量,让编译器做更激进的整体优化:
RUSTFLAGS="-C opt-level=3 -C lto=thin -C codegen-units=1"codegen-units=1 往往能提升最终性能,但代价是编译时间可能变长,因此更适合发布构建而不是日常快速迭代。
如果你的程序对二进制体积和运行时开销敏感,还可以调整发布版本的 panic 行为。在 Cargo.toml 中加入:
[profile.release]
panic = "abort"
这样做可以去掉运行时的 panic 展开处理成本,适合对异常恢复没有强需求的程序。它的核心价值不是“让所有程序都更快”,而是减少不必要的运行时负担。
代码层怎么改更有效:少复制、少分配、选对容器
编译器优化只是起点,真正长期稳定的性能收益,通常来自代码本身。Rust 里最常见的性能损耗,往往不是算法写错,而是反复分配内存、生成中间结果,或者做了不必要的数据复制。
优先用迭代器,减少中间结果和显式控制成本
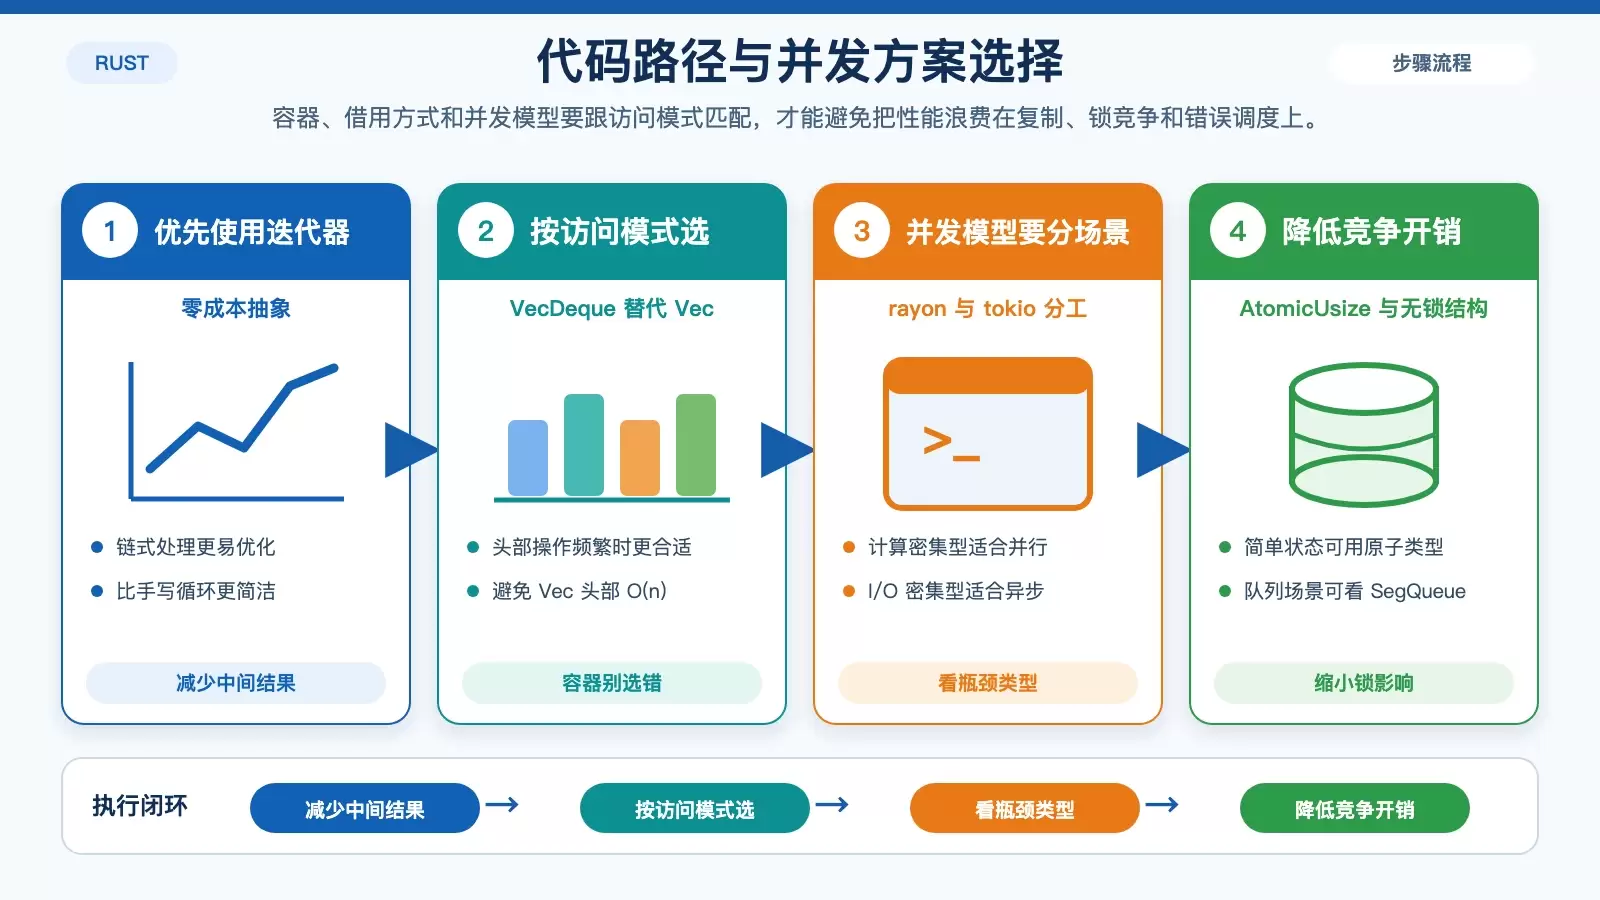
一个很实用的经验是:能用迭代器时,尽量不要手写显式循环。Rust 的迭代器属于零成本抽象,很多场景下比手写循环更容易被编译器优化。
vec![1,2,3].iter().sum()对比下面这种写法:
let mut sum = 0;
for num in vec![1,2,3] {
    sum += num;
}
前者通常更简洁,也更容易避免无意义的中间状态。尤其在链式处理数据时,迭代器优势更明显。
能借用就别复制,警惕不必要的 clone 和 copy
很多 Rust 程序变慢,不是因为计算复杂,而是因为复制太多。要特别留意不必要的 clone 和 copy。如果数据并不需要独占所有权,优先使用引用 & 或借用 borrow 传递数据,通常就能减少一批额外开销。
这类优化看起来零碎,但在热路径里影响非常实际。尤其字符串、集合和结构体层层传递时,少一次复制就可能少一次分配。
根据访问模式选容器,必要时用 Cow 延迟复制
数据结构选错,也会直接拖慢程序。比如你需要频繁在头部插入或删除元素时,Vec 就不是理想选择,因为头部操作是 O(n)。这种情况下,应该考虑 VecDeque,它对头部插入和删除的复杂度是 O(1)。
字符串或字节数据如果“大多数时候只读、少数时候修改”,可以考虑 Cow(Clone-on-Write)类型。它只在真正需要修改时才复制数据,能有效避免过早分配。比如:
process_data(Cow::Borrowed("input"))这类写法的价值在于,很多原本顺手写出的 to_string,其实根本没有必要发生。
并发和内存:让 CPU 跑满,也别让分配器拖后腿
Rust 在并发场景下的优势,不只是“安全”,更重要的是它能让你更放心地把优化推进到多线程和异步层面。不过并发优化一定要区分场景,计算密集型和 I/O 密集型的思路并不一样。
计算密集型用 rayon,I/O 密集型看 tokio
如果任务主要吃 CPU,例如批量计算、统计或转换,rayon 的并行迭代器非常实用:
let sum: i32 = (1..100).into_par_iter().sum()这类写法能自动把任务分发到多个线程,通常比手动拆线程更省事,也更符合 Rust 生态的使用习惯。
而在网络服务、代理、爬虫这类 I/O 密集型场景中,线程数堆得再多也不一定划算。此时更合适的是使用 tokio 异步运行时,通过 #[tokio::main] 配合异步 I/O,减少线程阻塞带来的资源浪费。
判断标准很简单:CPU 算不过来,优先看并行;线程大量等待 I/O,优先看异步。
缩小锁范围,必要时改用原子或无锁结构
并发性能的另一个常见瓶颈,是锁竞争。优化时要重点关注锁的粒度是否过大,锁持有时间是否过长。很多程序不是线程不够,而是线程都堵在同一把锁上。
如果只是简单计数或状态标记,可以考虑使用 AtomicUsize 这类原子类型,减少互斥锁带来的上下文切换成本。需要更高级的无锁队列时,crossbeam 提供的 SegQueue 也是常见选择。
预分配容量,必要时替换分配器
内存分配本身就是性能热点,尤其在循环、批处理和多线程场景里更明显。最直接的方式是预分配容量,避免容器一路扩容:
Vec::with_capacity(1000)相比边插入边增长的默认行为,这种方式可以减少多次重分配和数据搬移。
如果程序是多线程负载,且经过分析发现分配器成为瓶颈,可以考虑用 jemalloc 替代默认的 dlmalloc。配置方式如下,在 Cargo.toml 中添加:
jemallocator = "0.3"然后在代码中初始化全局分配器:
#[global_allocator]
static GLOBAL: Jemalloc = Jemalloc;
这类替换不应靠经验拍板,而应结合实际压测结果决定。不同负载下,收益并不完全一致。
别靠感觉调优:先用 perf、flamegraph 和基准测试找热点
性能优化最忌讳“看到哪里像慢就改哪里”。在 Ubuntu 上,先把热点找出来,通常比盲目重构更重要。Linux 环境里最常见的起点工具是 perf:
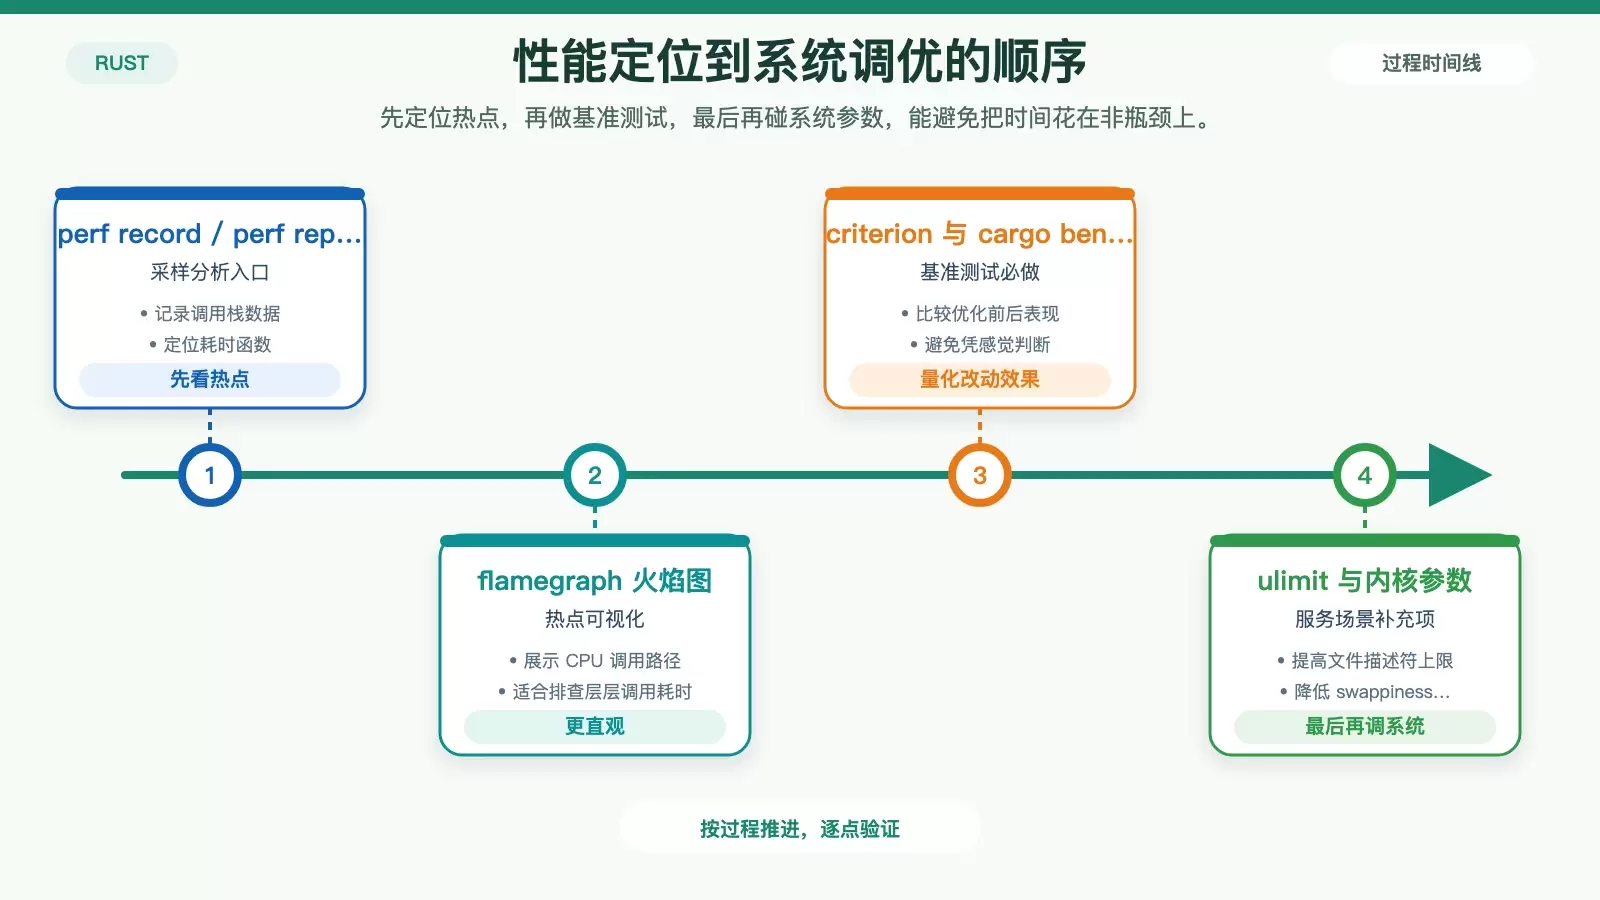
sudo perf record -g target/release/your_program这条命令会记录性能数据和调用栈。之后可以用:
sudo perf report查看热点函数分布,分析时间到底耗在什么地方。
如果你希望结果更直观,可以使用 flamegraph 生成火焰图:
cargo install flamegraph && cargo flamegraph --bin your_program火焰图非常适合看调用路径上的 CPU 消耗,尤其适合排查“哪一层调用拖慢了整体性能”这类问题。
除了采样分析,基准测试也必不可少。使用 criterion 可以把每次修改前后的性能变化量化出来,再配合:
cargo bench就能判断某个“优化”到底是真的提速,还是只是代码看起来更复杂了。
如果程序还涉及长期运行或怀疑存在内存问题,也可以用下面的方式做泄漏检查:
valgrind --tool=memcheck target/release/your_program它不一定是日常开发的首选,但在排查异常内存行为时很有价值。
系统层面的补充优化:适合高并发和长时间运行程序
当编译参数、代码路径和并发模型都已经比较合理后,系统环境配置才值得进入视野。它通常不是第一优先级,但对高并发服务或长期运行进程确实有帮助。
首先可以调整文件描述符限制,避免高并发下句柄耗尽:
ulimit -n 65535如果服务要同时处理大量连接、文件或套接字,这一步很常见。
内核内存策略方面,可以适当降低 vm.swappiness,例如设为 10,以减少交换分区使用,提升内存访问效率。这个参数是否值得改,要看机器内存压力和业务类型,不能脱离环境一概而论。
另外,使用 preload 预加载常用库,也能在部分场景下改善程序启动速度:
sudo apt install preload这类优化更偏系统运维侧,通常不会改变核心算法效率,但可能改善服务的整体响应体验。
更实用的优化顺序:先发布构建,再测量,再局部下手
如果把上面的技巧按投入产出比排序,通常可以遵循这样一条路径:先确认程序是否使用 cargo build --release;再根据项目规模补充 RUSTFLAGS、lto=thin、codegen-units=1 和 panic = "abort";然后回到代码层检查是否存在过度 clone、错误的数据结构选择和频繁分配;接着借助 perf、flamegraph、criterion 做定量分析;最后才考虑分配器替换和系统参数调优。
这样做的好处是,能先拿到最便宜的收益,再把优化精力集中到真实瓶颈上。Rust 在 Ubuntu 上并不缺少优化手段,关键是别把“能调的地方很多”误解为“所有地方都该一起动”。















