



很多人遇到 Rust 程序在 Debian 上“跑不满”的情况,第一反应往往是怀疑语言或发行版本身。实际上,真正拖慢性能的,通常是更具体的实现细节:数据结构选型、内存分配方式、并发模型、编译参数,甚至是 Debian 默认的系统限制。
这篇文章按排查顺序把常见瓶颈重新梳理一遍。你可以从代码层、运行时层、系统层一路往下看,快速判断性能问题更可能出在哪一段,也能据此决定下一步该优先改代码、换依赖,还是调整编译和内核参数。
先看代码路径:算法、分配和 I/O 往往最先暴露问题
算法与数据结构选错,优化空间会被直接吃掉
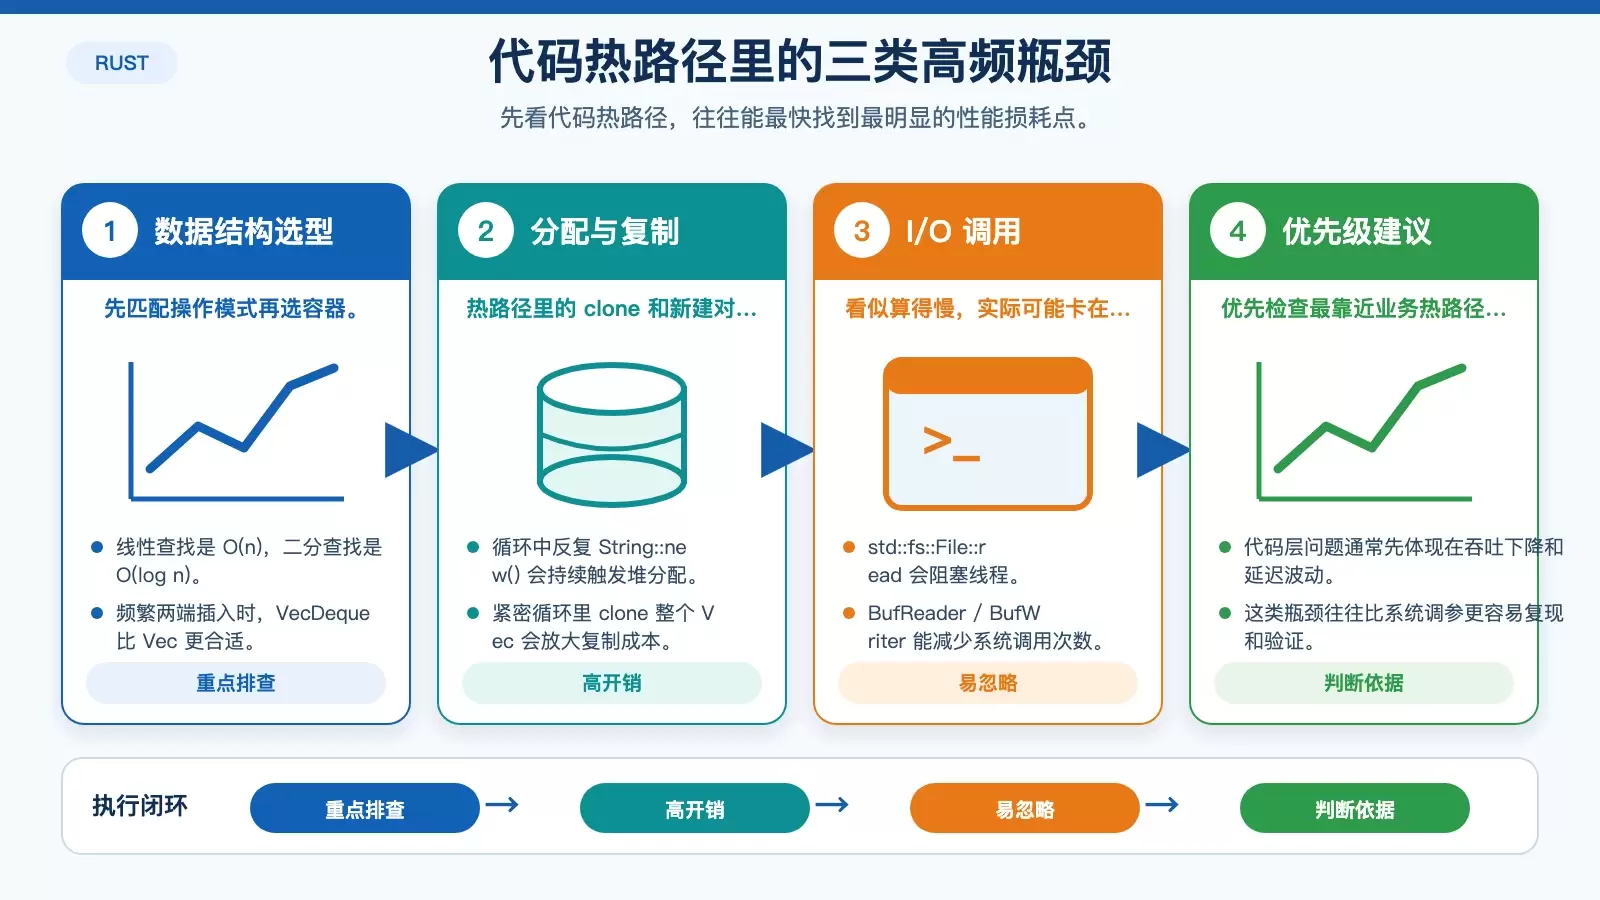
如果基础算法和数据结构不合适,后面的微调通常收益有限。最典型的例子是查找复杂度:线性查找是 O(n),二分查找是 O(log n),数据量一上来,差距会迅速放大。
容器选择也一样。频繁在两端插入数据时,Vec 的 push 一旦触发扩容,就要重新分配并复制已有内容;这种场景本来就更适合 VecDeque。类似地,HashMap 可能受到哈希冲突影响,BTreeMap 则要承担有序遍历带来的额外开销。结论很直接:先确认操作模式,再选容器,往往比后续优化更有效。
不必要的内存分配与复制,会在热路径里持续放大
Rust 的所有权模型保证了安全性,但不代表分配和复制没有成本。若在循环体里频繁调用 String::new(),或者习惯性使用 clone(),堆分配和内存复制就会稳定消耗时间。
常见反面案例,是在紧密循环中克隆整个 Vec。更稳妥的做法通常是优先借用,比如直接传递 &str,或者把处理逻辑改成迭代器链,例如 iter().map()。对于热路径,经验法则很简单:能借用就别复制,能遍历引用就别克隆整个对象。
I/O 与系统调用效率,常常比计算本身更先成为瓶颈
不少程序看似“算得慢”,实则卡在 I/O。同步调用如 std::fs::File::read 会直接阻塞线程,在并发场景里尤其明显;如果还是大量小文件、小块读写,系统调用次数会进一步推高开销。
这种情况下,通常有两条明确思路:一是改为异步 I/O,例如 tokio::fs;二是加入缓冲层,如 BufReader 和 BufWriter。缓冲的价值在于把多次小读取合并成较少的大块操作,例如 BufReader 先把一块数据读入内存,后续访问直接命中缓冲区,系统调用次数会明显下降。
再看并发与运行时:锁和异步并不天然高效
锁竞争会把多线程收益抵消掉
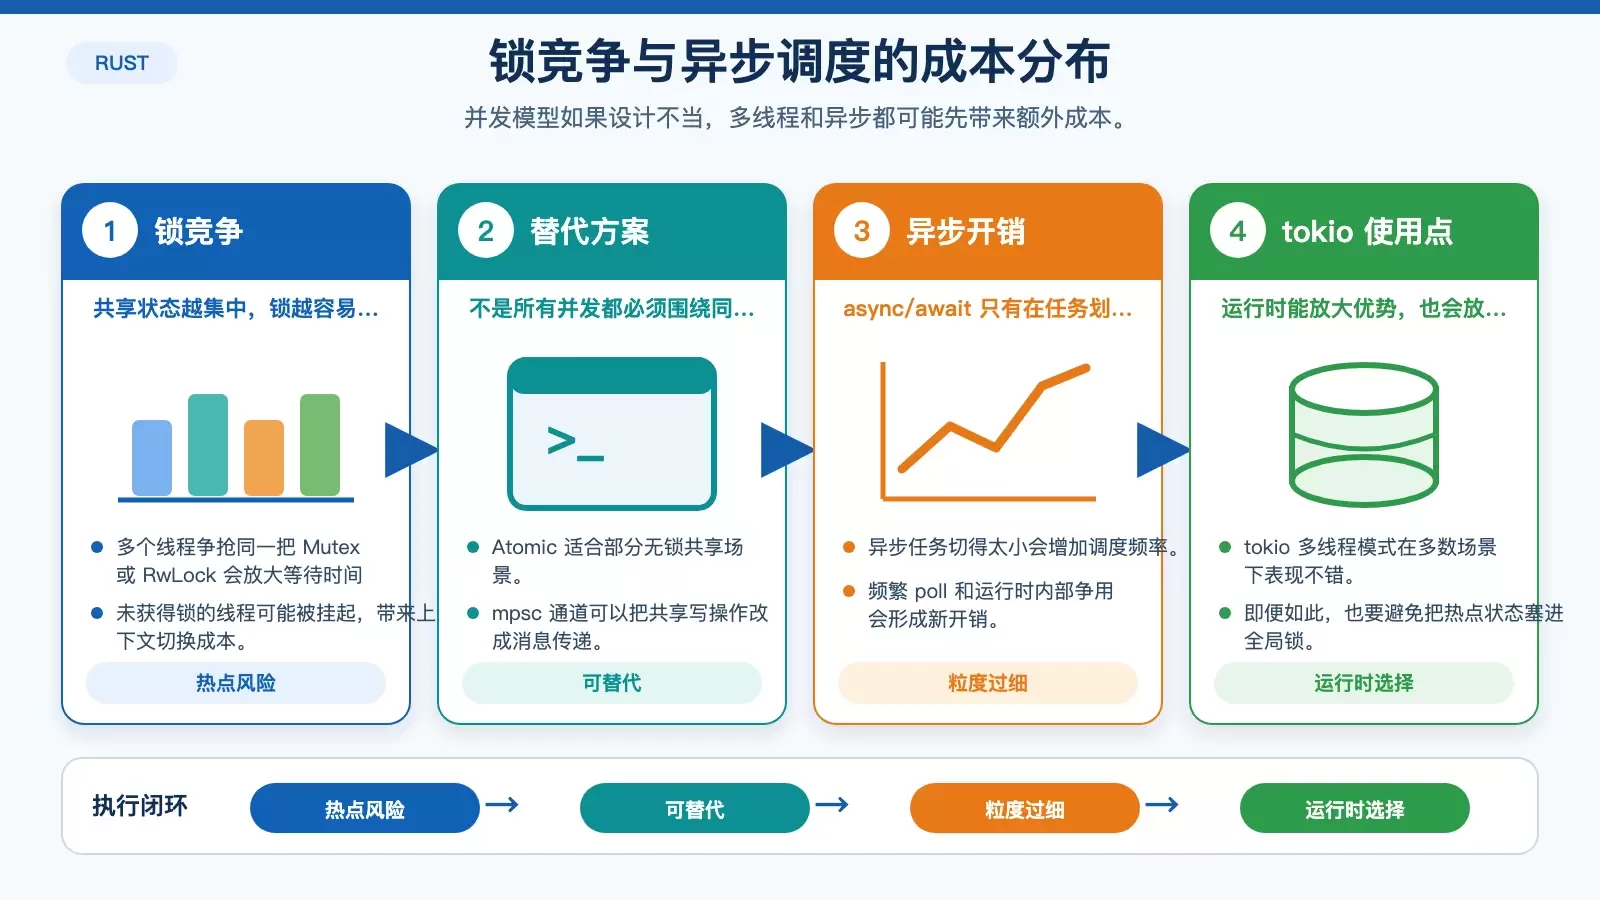
多线程程序一旦频繁围绕同一共享状态加锁,Mutex 和 RwLock 就可能从“保护机制”变成性能障碍。多个线程争抢同一把锁时,未获得锁的线程只能等待或被挂起,上下文切换也会跟着增多。
如果共享数据的访问模式允许,可以考虑改用无锁数据结构,例如 Atomic 类型,或者通过消息传递把共享写操作拆开,例如使用 mpsc 通道。锁并不是不能用,而是要确认它没有落在高频争用路径上。
异步编程的收益,取决于任务粒度和运行时选择
async/await 经常被描述为“零开销抽象”,但这个前提是使用方式合理。如果任务切得过细,运行时就要更频繁地调度任务;再叠加大量 poll 调用或全局锁竞争,异步本身也会产生可见成本。
实践里需要重点看两件事:第一,任务粒度是不是过小;第二,运行时是否适合当前负载。以 tokio 为例,它的多线程模式在多数场景下表现不错,但如果业务逻辑中仍然把热点状态放进全局锁里,运行时也无法替你消除这部分开销。
编译参数和依赖库,决定了上限能不能发挥出来
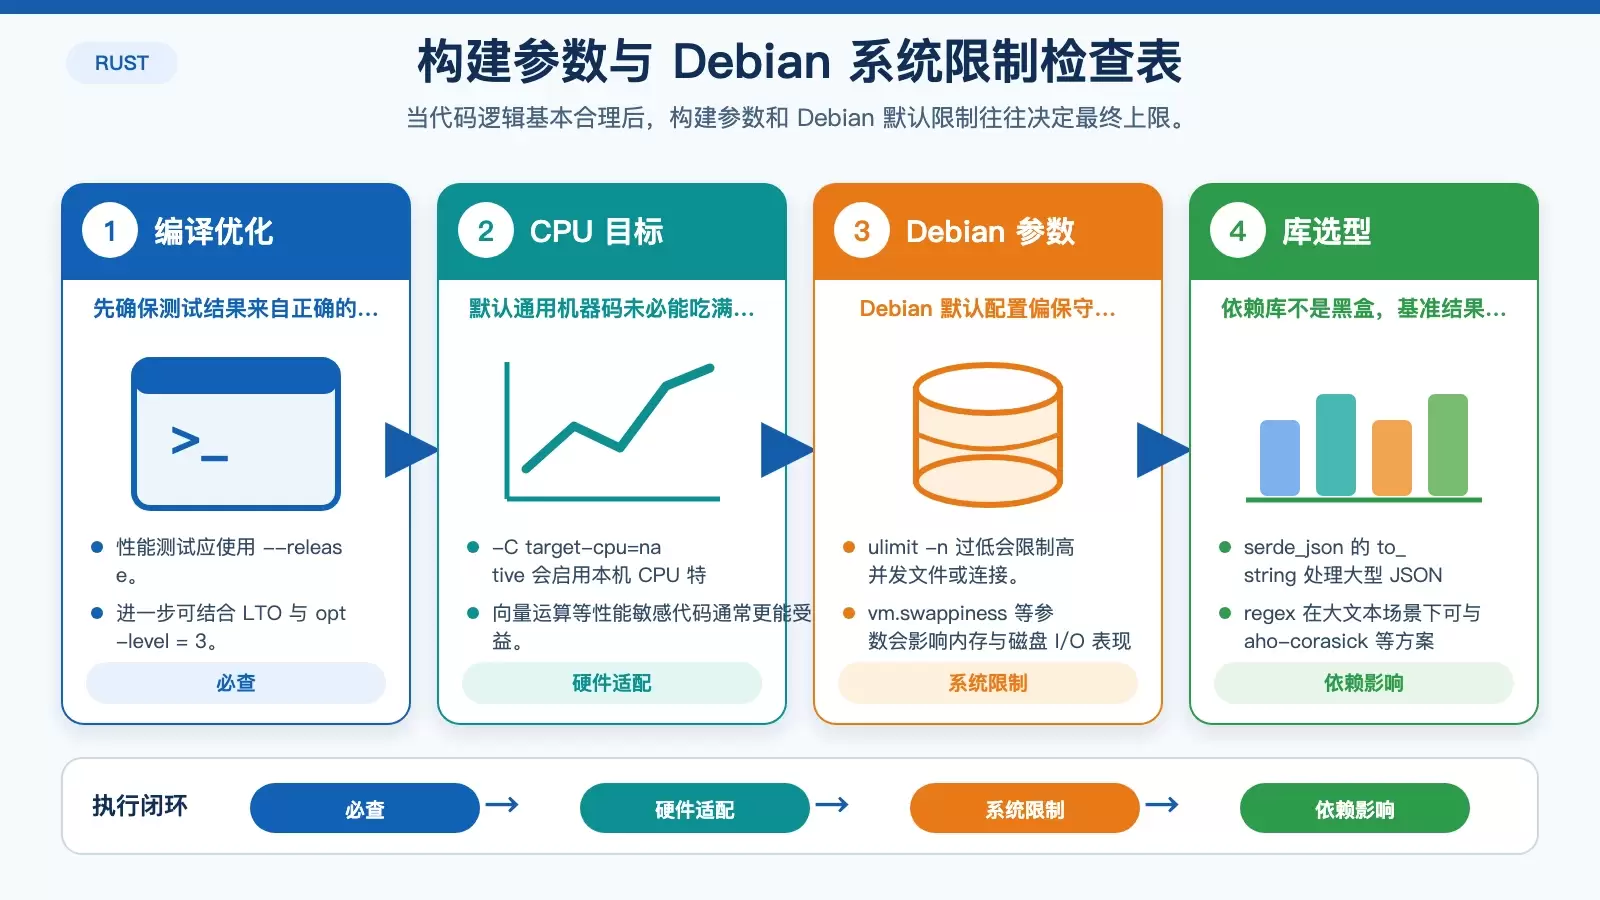
先确认编译优化是否真正打开
性能测试若直接在 debug 模式下进行,结果通常没有参考价值。生产环境至少应该使用 --release,这样编译器才会启用内联、循环展开等优化。
如果还要继续压榨性能,可以进一步打开链接时优化(LTO),并配合 opt-level = 3。这类配置的意义在于让编译器跨模块做更深入的优化,而不是只盯着单个编译单元。很多“莫名其妙变快”的结果,本质上只是之前根本没有在正确的构建模式下测。
第三方库选型,可能比局部代码优化更影响结果
依赖库不是纯粹的实现细节,它们直接决定了程序在某些任务上的速度。比如处理大型 JSON 时,serde_json 的 to_string 可能偏慢;如果业务允许二进制格式,改用 bincode 往往会更快。
文本匹配也类似。通用的 regex 很方便,但在大文本场景下未必是最省时的方案;如果需求更贴近多模式字符串匹配,aho-corasick 这类更专门的库可能更合适。选依赖时看看性能基准,往往比写一轮手工优化更节省时间。
分配器与 CPU 目标没有调好,也会白白损失性能
Rust 默认使用系统分配器,原文提到的是 dlmalloc。在高频分配和释放小对象的场景里,分配器策略本身就会影响吞吐和碎片控制。
如果这部分已经成为热点,可以考虑替换为 jemalloc 或 tcmalloc。例如通过引入 jemallocator crate 并将其设置为全局分配器,某些小对象密集场景会有较直接的改善。
另一个常被忽略的点,是编译目标对当前硬件的适配。编译器默认生成的是更通用的机器码,不会主动针对当前 CPU 指令集做激进优化。加入 -C target-cpu=native 后,编译器才能利用本机支持的 SIMD 指令和浮点能力;如果程序里有向量运算或明显依赖 CPU 特性,这一项尤其值得检查。
最后排查 Debian 系统层:默认参数可能卡住最后一段性能
文件描述符、网络缓冲与 Swap 策略,都可能成为系统级限制
Debian 的默认系统参数通常更偏保守,适合通用稳定运行,但不一定适合高性能 Rust 服务。常见问题包括:ulimit -n 设置过低,导致高并发打开文件或连接时直接受限;TCP 缓冲区偏小,网络吞吐上不去;Swap 策略不合适,引发额外磁盘 I/O,拖慢内存相关性能。
这类问题之所以难查,是因为代码本身可能没有明显异常,但程序始终达不到预期吞吐。此时就该回到系统配置,检查文件描述符上限、网络缓冲区以及 vm.swappiness 等内核参数。很多所谓“最后 1% 的瓶颈”,最后其实是 Debian 默认配置没有针对业务负载做调优。
怎么判断该先从哪里下手
如果你的 Rust 程序在 Debian 上表现不佳,排查顺序通常可以这样定:先看算法、数据结构和 I/O 路径,再看是否存在明显的分配复制和锁竞争,然后确认是否用了 --release、LTO、opt-level = 3 与 -C target-cpu=native,最后再回到 Debian 的系统参数和依赖库选型。
换句话说,Rust 的性能瓶颈很少只有一个来源。把问题拆成代码路径、运行时模型、构建配置和系统环境四层分别检查,通常比一上来怀疑语言本身更容易找到真正的短板。















