


Python Django REST Framework 实现 RESTful API 完整指南

本文详解如何使用Python结合Django与rest_framework开发RESTful API。内容涵盖从MySQL数据库连接、数据爬取入库,到Django项目搭建、模型生成、序列化配置及视图编写的全过程。重点讲解分页处理、数据输出格式及前后端交互细节,提供完整代码示例与GitHub项目地址,帮助开发者快速掌握Web API开发技能。
前言
开发Python接口的前提是拥有数据源。我们可以利用网络爬虫获取所需数据,此前已有关于Python爬虫技术的文章可供参考:https://www.jb51.net/article/141661.htm
将大量数据存入数据库是高效的管理方式。本文选用PyMySQL作为Python操作MySQL的模块,其用法与MySQLdb高度相似。需要注意的是,在Python 3.x环境中,PyMySQL已取代MySQLdb成为主流选择。
1.连接数据库
# 连接数据库,需指定charset否则可能会报错
db = pymysql.connect(host="localhost", user="root", password="123", db="mysql", charset="utf8mb4")
cursor = db.cursor() # 创建一个游标对象
2.创建数据库
cursor.execute("DROP TABLE IF EXISTS meizi_meizis") # 如果表存在则删除
 # 创建表sql语句
 createTab = """create table meizi_meizis(
 id int primary key auto_increment,
 mid varchar(10) not null,
 title varchar(50),
 picname varchar(10),
 page_url varchar(50),
 img_url varchar(50)
 );"""
 cursor.execute(createTab) # 执行创建数据表操作
3.爬取数据
def html(self, href, title):
 lists = []
 meiziid = href.split('/')[-1]
 html = self.request(href)
 max_span = BeautifulSoup(html.text, 'lxml').find('div', class_='pagenavi').find_all('span')[-2].get_text()
 for page in range(1, int(max_span) + 1):
 meizi = {}
 page_url = href + '/' + str(page)
 img_html = self.request(page_url)
 img_url = BeautifulSoup(img_html.text, 'lxml').find('div', class_='main-image').find('img')['src']
 picname = img_url[-9:-4]
 meizi['meiziid'] = meiziid
 meizi['title'] = title
 meizi['picname'] = picname
 meizi['page_url'] = page_url
 meizi['img_url'] = img_url
 lists.append(meizi) # 保存到返回数组中
 return lists
4.保存到数据库
def all_url(self, url):
 html = self.request(url)
 all_a = BeautifulSoup(html.text, 'lxml').find('div', class_='all').find_all('a')
 for index, a in enumerate(all_a):
 title = a.get_text()
 href = a['href']
 lists = self.html(href, title)
 for i in lists:
 # print(i['meiziid'], i['title'], i['picname'], i['page_url'], i['img_url'])
 # 插入数据到数据库sql语句,%s用作字符串占位
 sql = "INSERT INTO `meizi_meizis`(`mid`,`title`,`picname`,`page_url`,`img_url`) VALUES(%s,%s,%s,%s,%s)"
 try:
  cursor.execute(sql, (i['meiziid'], i['title'], i['picname'], i['page_url'], i['img_url']))
  db.commit()
  print(i[0] + " is success")
 except:
  db.rollback()
 db.close() # 关闭数据库
5.创建Web工程
运行爬虫脚本后,数据库表中将迅速填充数据。
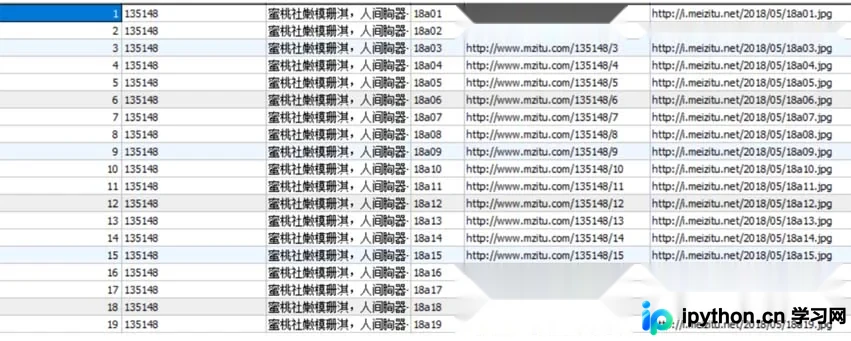
随后开始编写接口服务。本文采用Django结合rest_framework框架进行开发。
Django是基于Python的免费开源Web框架,旨在快速构建高性能且优雅的网站。它内置了开发网站常用的模块,预置了常见代码,从而有效减少重复劳动。
Django目录结构
urls.py
作为网址入口,负责将请求关联到views.py中的具体函数或Generic类。访问特定网址即触发对应的处理函数。
views.py
负责处理用户请求。数据从urls.py传递至此,通过渲染templates中的网页模板,可将登录用户名、用户请求数据等内容展示在网页上。
models.py
处理数据库操作,用于数据的存入或读取。若项目不涉及数据库,可选择不使用此文件。
forms.py
处理表单逻辑,包括用户输入数据的验证及输入框生成等。非必需模块,可根据需求选择是否使用。
templates 文件夹
views.py中的函数渲染该文件夹内的HTML模板,生成包含动态内容的网页。为提高性能,可引入缓存机制。
admin.py
用于配置后台管理界面,仅需少量代码即可构建强大的后台管理系统。
settings.py
Django的核心配置文件,包含DEBUG开关、静态文件路径等关键设置。
Django常用操作
1)新建一个django project
django-admin.py startproject project_name
2)新建 app
python manage.py startapp app_name
通常一个项目包含多个app,通用的app也可跨项目复用。
需在工程目录的settings.py文件中进行配置
INSTALLED_APPS = [
 'django.contrib.admin',
 'django.contrib.auth',
 'django.contrib.contenttypes',
 'django.contrib.sessions',
 'django.contrib.messages',
 'django.contrib.staticfiles',
 'rest_framework',

 'meizi',
]
在app/views.py下编写业务代码
def index(request):
 return HttpResponse(u"你好")
在工程目录urls.py中配置路由
from learn import views as learn_views
urlpatterns = [
 url(r'^$', learn_views.index),
]
通过python manage.py runserver启动服务,即可看到输出的“你好”信息
3)创建数据库表 或 更改数据库表或字段
在app下的models.py中定义表结构
class Person(models.Model):
 name = models.CharField(max_length=30)
 age = models.IntegerField()

 def __unicode__(self):
 # 在Python3中使用 def __str__(self):
 return self.name
运行相应命令,即可生成对应的数据表
Django 1.7.1及以上 用以下命令
# 1. 创建更改的文件
python manage.py makemigrations
# 2. 将生成的py文件应用到数据库
python manage.py migrate
在views.py文件中即可获取数据库中的数据
def create(request):
 # 新建一个对象的方法有以下几种:
 Person.objects.create(name='xiaoli', age=18)
 # p = Person(name="WZ", age=23)
 # p = Person(name="TWZ")
 # p.age = 23
 # p.save()
 # 这种方法是防止重复很好的方法,但是速度要相对慢些,返回一个元组,第一个为Person对象,
 # 第二个为True或False, 新建时返回的是True, 已经存在时返回False
 # Person.objects.get_or_create(name="WZT", age=23)
 s = Person.objects.get(name='xiaoli')
 return HttpResponse(str(s))
6.写接口
接口开发使用rest_framework,这是基于Django的REST框架,提供了一套强大且灵活的Web API构建工具包。
编写接口主要分为三步:连接数据库、获取数据、输出数据
1)连接数据库
在工程目录下的settings.py文件中进行配置
DATABASES = {
 # 'default': {
 # 'ENGINE': 'django.db.backends.sqlite3',
 # 'NAME': os.path.join(BASE_DIR, 'db.sqlite3'),
 # }
 'default': {
 'ENGINE': 'django.db.backends.mysql',
 'NAME': 'mysql',
 'USER': 'root',
 'HOST': '127.0.0.1',
 'PASSWORD': '123',
 'PORT': 3306,
 # show variables like 'character_set_database';
 # 修改字段字符编码
 # alter table spiders_weibo modify text longtext charset utf8mb4 collate utf8mb4_unicode_ci;
 'OPTIONS': {'charset': 'utf8mb4'},
 }
}
2)取数据
为确保Model与数据库一致,可采用快捷方式将数据库表生成对应的Model。在项目目录下执行命令
python manage.py inspectdb
可以看到生成的代码结构
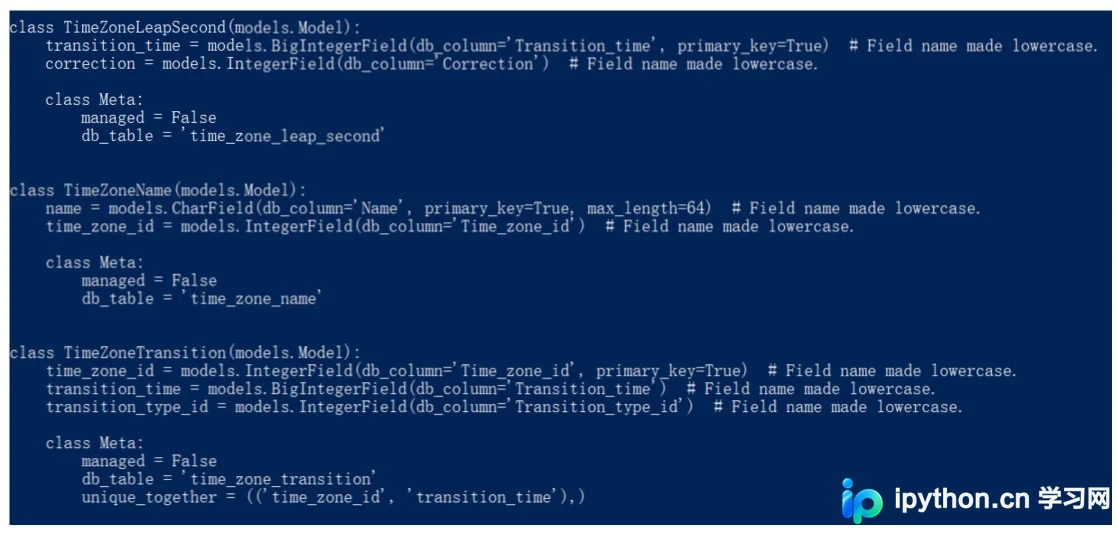
将生成的表Model代码拷贝至app下的models.py中
class Meizis(models.Model):
 mid = models.CharField(max_length=10)
 title = models.CharField(max_length=50, blank=True, null=True)
 picname = models.CharField(max_length=10, blank=True, null=True)
 page_url = models.CharField(max_length=50, blank=True, null=True)
 img_url = models.CharField(max_length=50, blank=True, null=True)

 class Meta:
 managed = False
 db_table = 'meizi_meizis'
创建一个序列化Serializer类
提供序列化和反序列化的途径,将数据转换为JSON等表现形式。可借助Serializer实现,其运作方式类似于Django的Form。在app目录下创建文件serializers.py。
class MeiziSerializer(serializers.ModelSerializer):
 # ModelSerializer和Django中ModelForm功能相似
 # Serializer和Django中Form功能相似
 class Meta:
 model = Meizis
 # 和"__all__"等价
 fields = ('mid', 'title', 'picname', 'page_url', 'img_url')
这样在views.py中即可获取数据库的数据
meizis = Meizis.objects.all()
serializer = MeiziSerializer(meizis, many=True)
return Response(serializer.data)
3) 数据输出客户端或前端
REST框架提供了两种编写API视图的封装方式。
- @api_view装饰器,基于方法的视图。
- 继承APIView类,基于类的视图。
request.data会自动处理输入的JSON请求
若需指定输出格式,需添加format关键字参数
http http://127.0.0.1:8000/getlist.json # JSON 后缀
http://127.0.0.1:8000/getlist.api # 可视化 API 后缀
http://127.0.0.1:8000/getlist/ code="print 123"post
@api_view(['GET', 'POST'])
def getlist(request, format=None):
 if request.method == 'GET':
 meizis = Meizis.objects.all()
 serializer = MeiziSerializer(meizis, many=True)
 return Response(serializer.data)

 elif request.method == 'POST':
 serializer = MeiziSerializer(data=request.data)
 if serializer.is_valid():
 serializer.save()
 return Response(serializer.data, status=status.HTTP_201_CREATED)
 return Response(serializer.errors, status=status.HTTP_400_BAD_REQUEST)
4)分页
最后别忘了在urls.py配置URL,通过浏览器即可访问JSON数据。
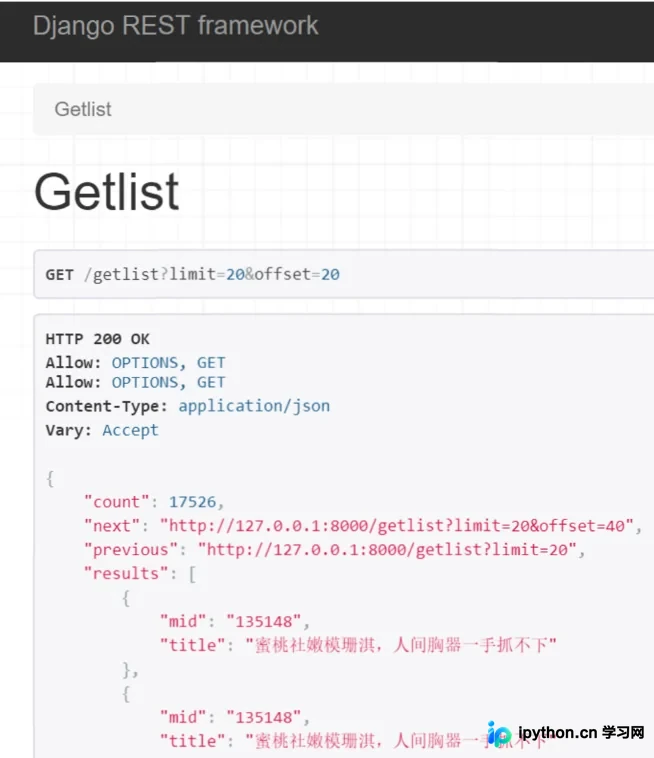
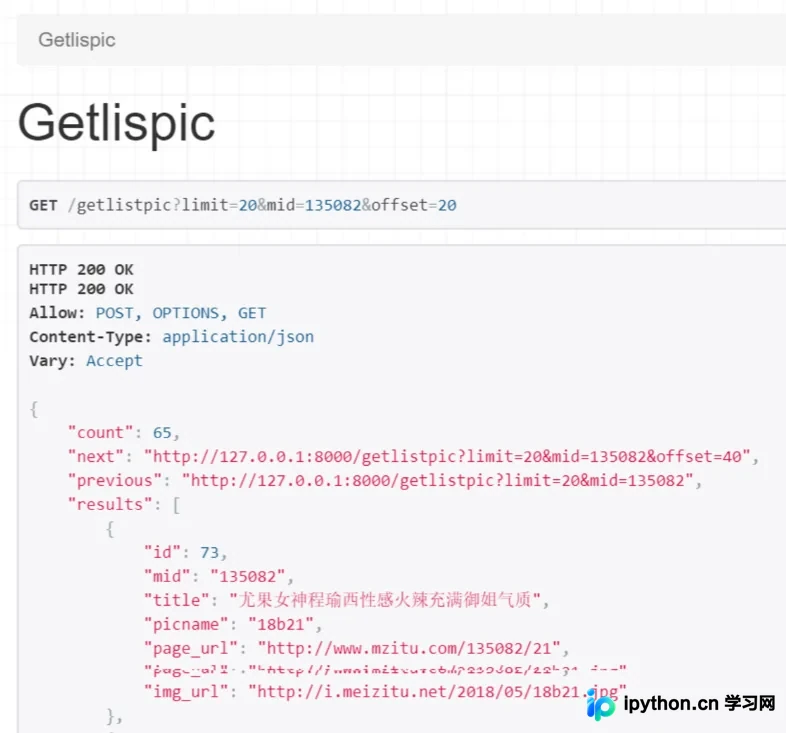
当然,APP端也可以调用我们的接口
还有个问题
若数据量达几千条,一次性返回不合理,因此需要分页。rest_framework框架虽提供此功能,但POST请求不支持自动分页,需自行查询数据库或切片返回。以下展示rest_framework的分页实现。在models.py里创建一个类
class StandardResultSetPagination(LimitOffsetPagination):
 # 默认每页显示的条数
 default_limit = 20
 # url 中传入的显示数据条数的参数
 limit_query_param = 'limit'
 # url中传入的数据位置的参数
 offset_query_param = 'offset'
 # 最大每页显示条数
 max_limit = None
在serializers.py创建两个类,为何需要两个?因为有两个接口:一个用于明细,一个用于列表。列表接口无需返回所有字段数据
class ListSerialize(serializers.ModelSerializer):
 class Meta:
 model = Meizis
 fields = ('mid', 'title')


class ListPicSerialize(serializers.ModelSerializer):
 class Meta:
 model = Meizis
 fields = "__all__"
在views.py里编写逻辑
@api_view(['GET'])
def getlist(request, format=None):
 if request.method == 'GET':
 meizis = Meizis.objects.values('mid','title').distinct()
 # http: // 127.0.0.1:8000 / getlist?limit = 20
 # http: // 127.0.0.1:8000 / getlist?limit = 20 & offset = 20
 # http: // 127.0.0.1:8000 / getlist?limit = 20 & offset = 40
 # 根据url参数 获取分页数据
 obj = StandardResultSetPagination()
 page_list = obj.paginate_queryset(meizis, request)
 # 对数据序列化 普通序列化 显示的只是数据
 ser = ListSerialize(instance=page_list, many=True) # 多个many=True # instance:把对象序列化
 response = obj.get_paginated_response(ser.data)
 return response


@api_view(['GET', 'POST'])
def getlispic(request, format=None):
 if request.method == 'GET':
 mid = request.GET['mid']
 if mid is not None:
 # get是用来获取一个对象的,如果需要获取满足条件的一些数据,就要用到filter
 meizis = Meizis.objects.filter(mid=mid)
 obj = StandardResultSetPagination()
 page_list = obj.paginate_queryset(meizis, request)
 ser = ListPicSerialize(instance=page_list, many=True)
 response = obj.get_paginated_response(ser.data)
 return response
 else:
 return Response(str('请传mid'))
至此接口编写完成。本文仅涉及框架的简单使用,希望对读者有所帮助。
GitHub地址,欢迎star
爬虫项目:https://github.com/peiniwan/CreeperTest(本地下载)
Web项目:https://github.com/peiniwan/mysite (本地下载)
APP项目:https://github.com/peiniwan/Ganhuo (本地下载)
总结
以上就是这篇文章的全部内容,希望本文内容对大家的学习或工作具有参考价值。如有疑问欢迎留言交流,感谢支持。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















