


Python决策树:基于信息增益的特征选择详解与实现

本文详细介绍Python决策树中基于信息增益的特征选择方法。通过计算数据集的信息熵与条件熵,量化特征划分带来的信息增益,从而筛选最优特征。文中包含熵与信息增益的定义、具体计算流程,以及基于海洋生物数据的完整Python代码示例和运行结果分析,帮助开发者理解并应用该核心算法。
本文通过具体实例解析Python决策树算法中基于信息增益的特征选择方法,供读者参考学习。
信息增益是决策树分类算法中广泛采用的特征选择策略。该方法通过计算各特征值划分数据集后获得的信息增益,对比增益大小以选取最优特征。
一、理论基础
1.1 熵的概念
熵是信息的期望值,用于衡量数据集的无序程度。熵值越高,数据越无序。计算公式如下:
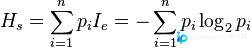
公式中H代表数据集的熵值,pi表示类别i出现的概率。若数据集中仅包含单一类别,则pi=1,此时H=0。因此,H=0即为熵的最小值,代表数据集完全有序。
1.2 信息增益定义
信息增益指划分数据集前后熵的减少量,即数据无序度降低的程度。
二、计算流程
1. 计算原始数据集的信息熵H1。
2. 选取特定特征,依据其特征值对数据进行分类,分别计算各类别的信息熵,并按比例加权求和,得到该划分方式下的信息熵H2。
3. 计算信息增益:
infoGain = H1 - H2
4. 遍历所有特征属性,重复步骤2和3计算各自的信息增益,保留增益较大的特征作为划分依据。
三、实例演示
使用海洋生物数据进行说明。
| 被分类项\特征 | 不浮出水面是否可以生存 | 是否有脚蹼 | 属于鱼类 |
|---|---|---|---|
| 1 | 是 | 是 | 是 |
| 2 | 是 | 是 | 是 |
| 3 | 是 | 否 | 否 |
| 4 | 否 | 是 | 否 |
| 5 | 否 | 是 | 否 |
3.1 原始数据信息熵计算
p(是鱼类) = p1 = 0.4 p(非鱼类) = p2 = 0.6
代入信息熵公式,可得原始数据的信息熵为H1 = 0.97095。
3.2 基于特征分类的信息熵计算
选取特征“是否浮出水面生存”进行分析。
数据集可划分为两组:[1,2,3]和[4,5],占比分别为0.6和0.4。
组[1,2,3]的信息熵计算结果为h1=0.918295834054。
组[4,5]的信息熵计算结果为h2=0。
综合计算划分后的加权信息熵H2 = 0.6 * h1 + 0.4 * h2 = 0.550977500433。
3.3 信息增益计算
infoGain_0 = H1 - H2 = 0.419973094022
3.4 特征选择结果
同理计算特征“是否有脚蹼”的信息增益,结果为infoGain_1 = 0.170950594455。
对比可知,“是否浮出水面生存”这一特征带来的信息增益更大,因此在当前实例中,它是划分数据集的最佳特征。
四、代码实现
# -*- coding:utf-8 -*-
#! python2
import numpy as np
from math import log
data_feature_matrix = np.array([[1, 1],
                [1, 1],
                [1, 0],
                [0, 1],
                [0, 1]]) # 特征矩阵
category = ['yes', 'yes', 'no', 'no', 'no'] # 5个对象分别所属的类别
def calc_shannon_ent(category_list):
  """
  :param category_list: 类别列表
  :return: 该类别列表的熵值
  """
  label_count = {} # 统计数据集中每个类别的个数
  num = len(category_list) # 数据集个数
  for i in range(num):
    try:
      label_count[category_list[i]] += 1
    except KeyError:
      label_count[category_list[i]] = 1
  shannon_ent = 0.
  for k in label_count:
    prob = float(label_count[k]) / num
    shannon_ent -= prob * log(prob, 2) # 计算信息熵
  return shannon_ent
def split_data(feature_matrix, category_list, feature_index, value):
  """
  筛选出指定特征值所对应的类别列表
  :param category_list: 类别列表
  :param feature_matrix: 特征矩阵
  :param feature_index: 指定特征索引
  :param value: 指定特征属性的特征值
  :return: 符合指定特征属性的特征值的类别列表
  """
  # feature_matrix = np.array(feature_matrix)
  ret_index = np.where(feature_matrix[:, feature_index] == value)[0] # 获取符合指定特征值的索引
  ret_category_list = [category_list[i] for i in ret_index] # 根据索引取得指定的所属类别,构建为列表
  return ret_category_list
def choose_best_feature(feature_matrix, category_list):
  """
  根据信息增益获取最优特征
  :param feature_matrix: 特征矩阵
  :param category_list: 类别列表
  :return: 最优特征对应的索引
  """
  feature_num = len(feature_matrix[0]) # 特征个数
  data_num = len(category_list) # 数据集的个数
  base_shannon_ent = calc_shannon_ent(category_list=category_list) # 原始数据的信息熵
  best_info_gain = 0 # 最优信息增益
  best_feature_index = -1 # 最优特征对应的索引
  for f in range(feature_num):
    uni_value_list = set(feature_matrix[:, f]) # 该特征属性所包含的特征值
    new_shannon_ent = 0.
    for value in uni_value_list:
      sub_cate_list = split_data(feature_matrix=feature_matrix, category_list=category_list, feature_index=f, value=value)
      prob = float(len(sub_cate_list)) / data_num
      new_shannon_ent += prob * calc_shannon_ent(sub_cate_list)
    info_gain = base_shannon_ent - new_shannon_ent # 信息增益
    print '初始信息熵为:', base_shannon_ent, '按照特征%i分类后的信息熵为:' % f, new_shannon_ent, '信息增益为:', info_gain
    if info_gain > best_info_gain:
      best_info_gain = info_gain
      best_feature_index = f
  return best_feature_index
if __name__ == '__main__':
  best_feature = choose_best_feature(data_feature_matrix, category)
  print '最好用于划分数据集的特征为:', best_feature
运行结果如下:
初始信息熵为: 0.970950594455 按照特征0分类后的信息熵为: 0.550977500433 信息增益为: 0.419973094022 初始信息熵为: 0.970950594455 按照特征1分类后的信息熵为: 0.8 信息增益为: 0.170950594455 最好用于划分数据集的特征为: 0
如需了解更多Python相关知识,可参考本站专题:《Python数学运算技巧总结》、《Python数据结构与算法教程》、《Python函数使用技巧总结》、《Python字符串操作技巧汇总》、《Python入门与进阶经典教程》及《Python文件与目录操作技巧汇总》。
希望本文的内容能对您的Python程序设计提供有益帮助。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















