



很多初学者第一次接触 C# 异常处理时,容易把“程序报错”都混在一起理解:有的是编译期就能发现的语法问题,有的是业务逻辑写错,还有一类则是运行时才暴露出来的异常。本文从异常到底是什么讲起,再到 `try-catch` 的基本写法、多 `catch` 的匹配规则,以及 `TryParse` 与异常处理的取舍,帮你建立一套能直接落地的判断方式。
为什么要先理解异常
异常不等于语法错误,也不等于普通 Bug
在 C# 里,异常是指程序执行期间出现、并打断正常指令流的运行时错误。它不同于“BUG”这种逻辑错误,比如本来要做加法却写成减法;也不同于语法错误,那类问题通常在编译阶段就会被编译器指出。
异常更像程序运行过程中的突发状况,常见场景包括:
- 尝试打开一个不存在的文件。
- 网络连接突然中断。
- 请求的内存过大,系统无法分配。
- 数组索引超出了范围。
- 尝试对一个
null的对象进行操作。
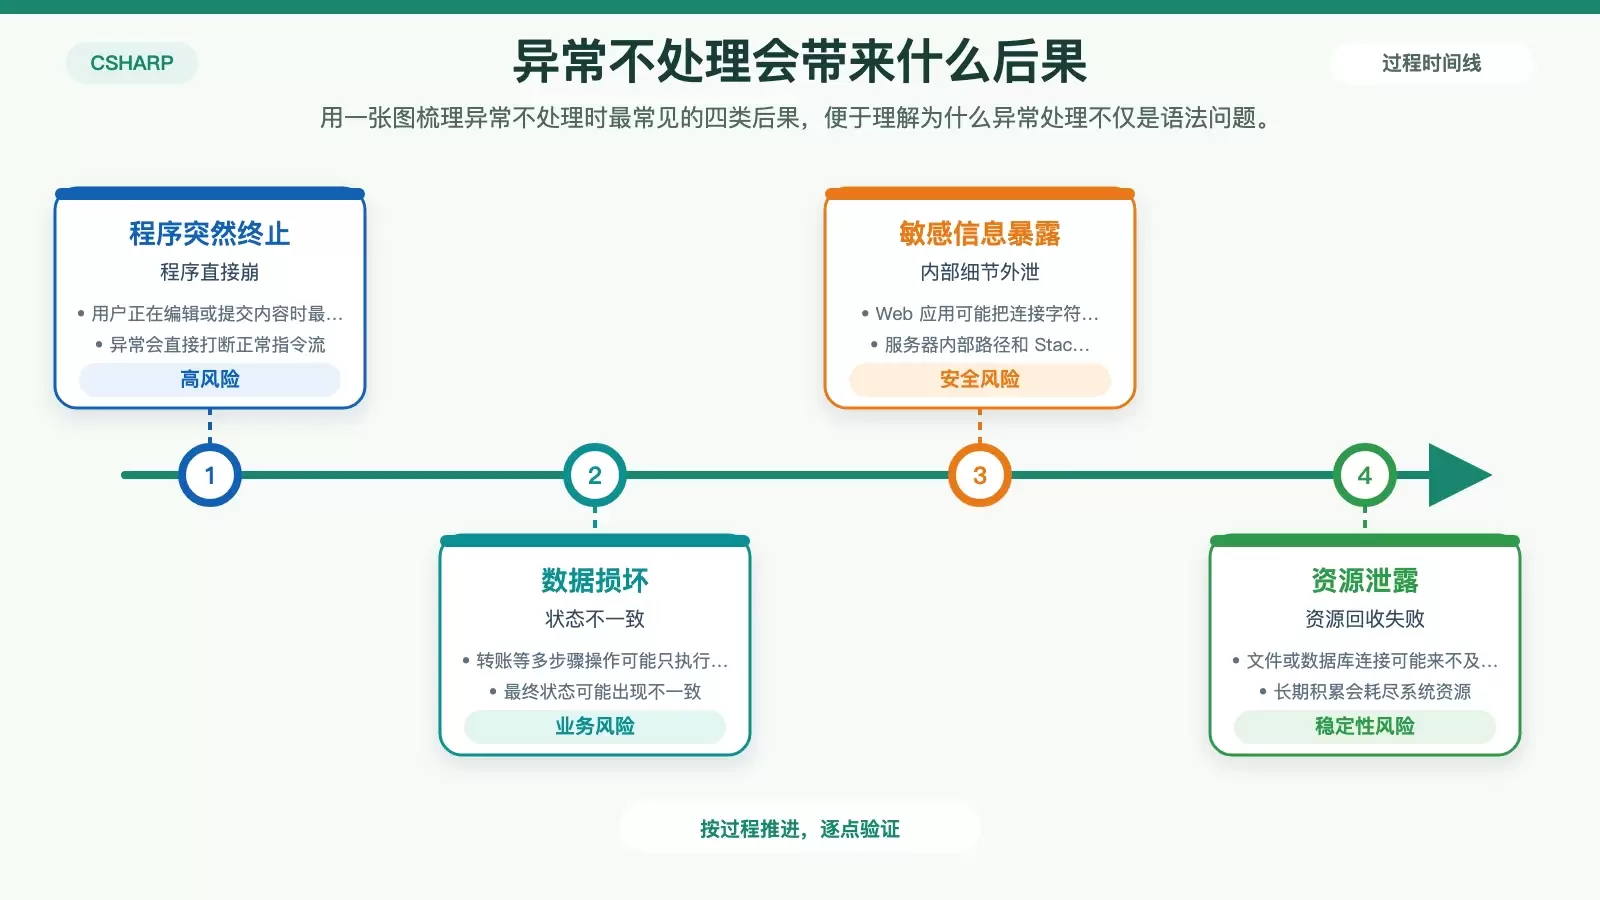
异常不处理,代价通常比报错本身更大
- 程序突然终止:用户正在编辑文档、填写表单时,程序直接崩溃,已有操作可能全部丢失。
- 数据损坏:例如转账逻辑执行到一半崩溃,可能出现扣款成功但入账失败,造成状态不一致。
- 敏感信息暴露:在 Web 应用中,未处理异常可能把数据库连接字符串、服务器路径、完整 Stack Trace 直接暴露给用户。
- 资源泄露:文件、数据库连接等资源来不及释放,长期累积后会拖慢系统,严重时甚至影响整体稳定性。
`try-catch` 怎么工作
`try` 块负责圈定风险代码
try 后面跟着的代码块,就是你预期“可能抛出异常”的区域。只要其中某条语句出错,正常执行流就会立刻中断,转去查找能处理该异常的 catch。
try
{
    // 这里是“风险区”
    Console.WriteLine("请输入一个数字:");
    int number = int.Parse(Console.ReadLine());
    int result = 100 / number;
    Console.WriteLine($"100除以{number}的结果是:{result}");
}
catch(Exception e)
{
    Console.WriteLine(e.ToString());
}
这段代码里,int.Parse() 可能因为输入了非数字字符抛出 FormatException,而 100 / number 则可能因为输入为 0 抛出 DivideByZeroException。
`catch` 块负责接住异常并决定后续动作
catch 紧跟在 try 后面。当 try 中出现异常时,CLR 会寻找匹配的 catch 块并执行其中逻辑。
最简单的写法是不带参数:
try
{
    // ... 风险代码 ...
}
catch
{
    // 异常发生时,执行这里的代码
    Console.WriteLine("发生了一个未知错误!");
}
这种写法能捕获任何类型的异常,但问题也很明显:你拿不到具体原因,后续处理只能非常粗糙。对于调试和定向恢复来说,这通常不够用。
`catch (Exception ex)` 能拿到哪些关键信息
更常见的写法,是在 catch 中声明异常类型和变量。由于 System.Exception 是所有异常的基类,catch (Exception ex) 几乎可以作为通用兜底方案使用。
try
{
    Console.WriteLine("请输入一个数组索引(0-2):");
    int[] numbers = { 10, 20, 30 };
    int index = int.Parse(Console.ReadLine());
    Console.WriteLine($"索引 {index} 上的值为: {numbers[index]}");
}
catch (Exception ex)
{
    Console.WriteLine("n--- 程序出现问题!---");
    Console.WriteLine($"错误类型: {ex.GetType().Name}"); // 获取异常的具体类型名
    Console.WriteLine($"错误信息: {ex.Message}");        // 获取异常的描述信息
    Console.WriteLine("--- 详细堆栈跟踪 ---");
    Console.WriteLine(ex.StackTrace);                  // 获取异常发生时的调用堆栈
    Console.WriteLine("----------------------");
}

Console.WriteLine("n程序已通过异常处理,继续执行...");
这里最有价值的通常是三类信息:
ex.GetType().Name:异常的具体类型名。ex.Message:当前异常的说明信息。ex.StackTrace:异常发生时的调用堆栈,定位问题时非常关键。
多 `catch` 的匹配顺序与层次结构
为什么具体异常一定要写在前面
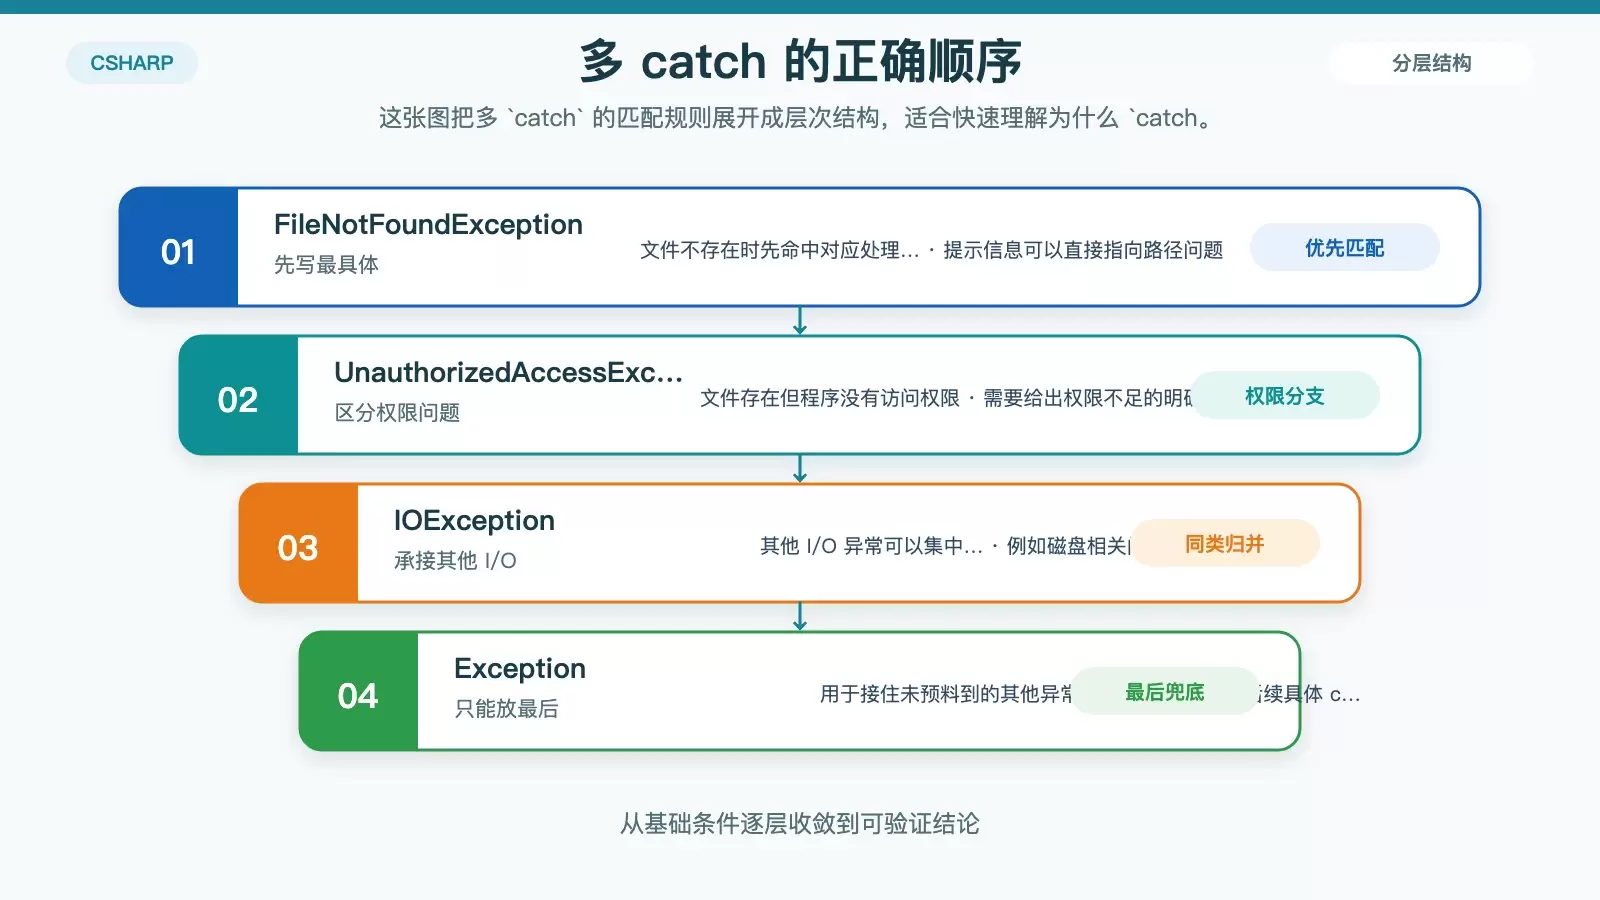
一个 try 后面可以跟多个 catch,每个块处理一种特定异常。CLR 会按从上到下的顺序进行匹配,并执行第一个匹配成功的 catch。
这里的“匹配”不只是类型完全一致。如果抛出的异常类型是某个 catch 所声明类型的子类,也会命中这个 catch。因此,多 catch 的关键规则就是:从最具体的子类写到最通用的父类。
看一个文件读取示例:
public void ProcessFile(string filePath)
{
    try
    {
        string content = System.IO.File.ReadAllText(filePath);
        Console.WriteLine("文件内容处理成功!");
    }
    catch (System.IO.FileNotFoundException ex) // 最具体的异常
    {
        Console.WriteLine($"错误:文件 '{filePath}' 不存在。请检查路径是否正确。");
    }
    catch (System.UnauthorizedAccessException ex) // 另一个具体的异常
    {
        Console.WriteLine($"错误:程序没有权限访问文件 '{filePath}'。");
    }
    catch (System.IO.IOException ex) // 捕获其他所有IO相关的异常
    {
        Console.WriteLine($"读取文件时发生 I/O 错误: {ex.Message}");
    }
    catch (Exception ex) // 最后的“万能捕手”,捕获所有其他意想不到的异常
    {
        Console.WriteLine($"发生未知错误,请联系技术支持。");
        // 在真实应用中,这里应该记录完整的ex.ToString()到日志文件
        // Log.Error(ex.ToString());
    }
}
这段代码的实际效果很明确:
- 文件不存在时,进入
catch (FileNotFoundException)。 - 文件存在但没有权限时,进入
catch (UnauthorizedAccessException)。 - 其他 I/O 问题,例如磁盘相关错误,则由
catch (IOException)接住。 - 最后的
catch (Exception)只作为通用兜底。
如果把 catch (Exception ex) 放到最前面,它会先把所有异常都截走,后面的具体 catch 就没有任何机会执行,编译器也会直接报错。
两个常见误区:吞异常与滥用异常
空 `catch` 为什么是危险信号
实际项目里,最需要警惕的写法之一就是“吞噬异常”:
// 警告:极度危险的代码!
try
{
    SomeRiskyOperation();
}
catch (Exception)
{
    // 什么也不做
}
表面上看,程序没有崩;实际上,错误只是被悄悄藏起来了。这样做至少有两类后果:
- 隐藏问题:例如数据库连接失败后,程序仍继续运行,后续逻辑可能建立在错误状态上,造成更难排查的数据问题。
- 调试困难:没有日志,没有报错信息,也没有崩溃记录,问题出现时几乎没有线索可追。
更合理的做法是:如果异常确实属于“预期内且可恢复”的情况,至少要留下记录,再执行恢复逻辑。
try
{
    // ...
}
catch (SomeExpectedAndRecoverableException ex)
{
    // 记录下来,以备后续分析
    Log.Warning($"一个可恢复的错误发生了: {ex.Message}");
    // 然后执行恢复逻辑
    // ...
}
`TryParse` 和 `try-catch` 该怎么选
输入校验是最容易出现误用的场景。比如判断用户输入是否为整数,常见有两种写法。
方法 A:使用 int.TryParse 先检查结果
string input = Console.ReadLine();
if (int.TryParse(input, out int number))
{
    // 成功,使用 number
    Console.WriteLine($"你输入的数字是: {number}");
}
else
{
    // 失败,处理无效输入
    Console.WriteLine("无效的输入,请输入一个整数。");
}
方法 B:直接 int.Parse,失败时交给异常处理
string input = Console.ReadLine();
try
{
    int number = int.Parse(input);
    // 成功,使用 number
    Console.WriteLine($"你输入的数字是: {number}");
}
catch (FormatException)
{
    // 失败,处理无效输入
    Console.WriteLine("无效的输入,请输入一个整数。");
}
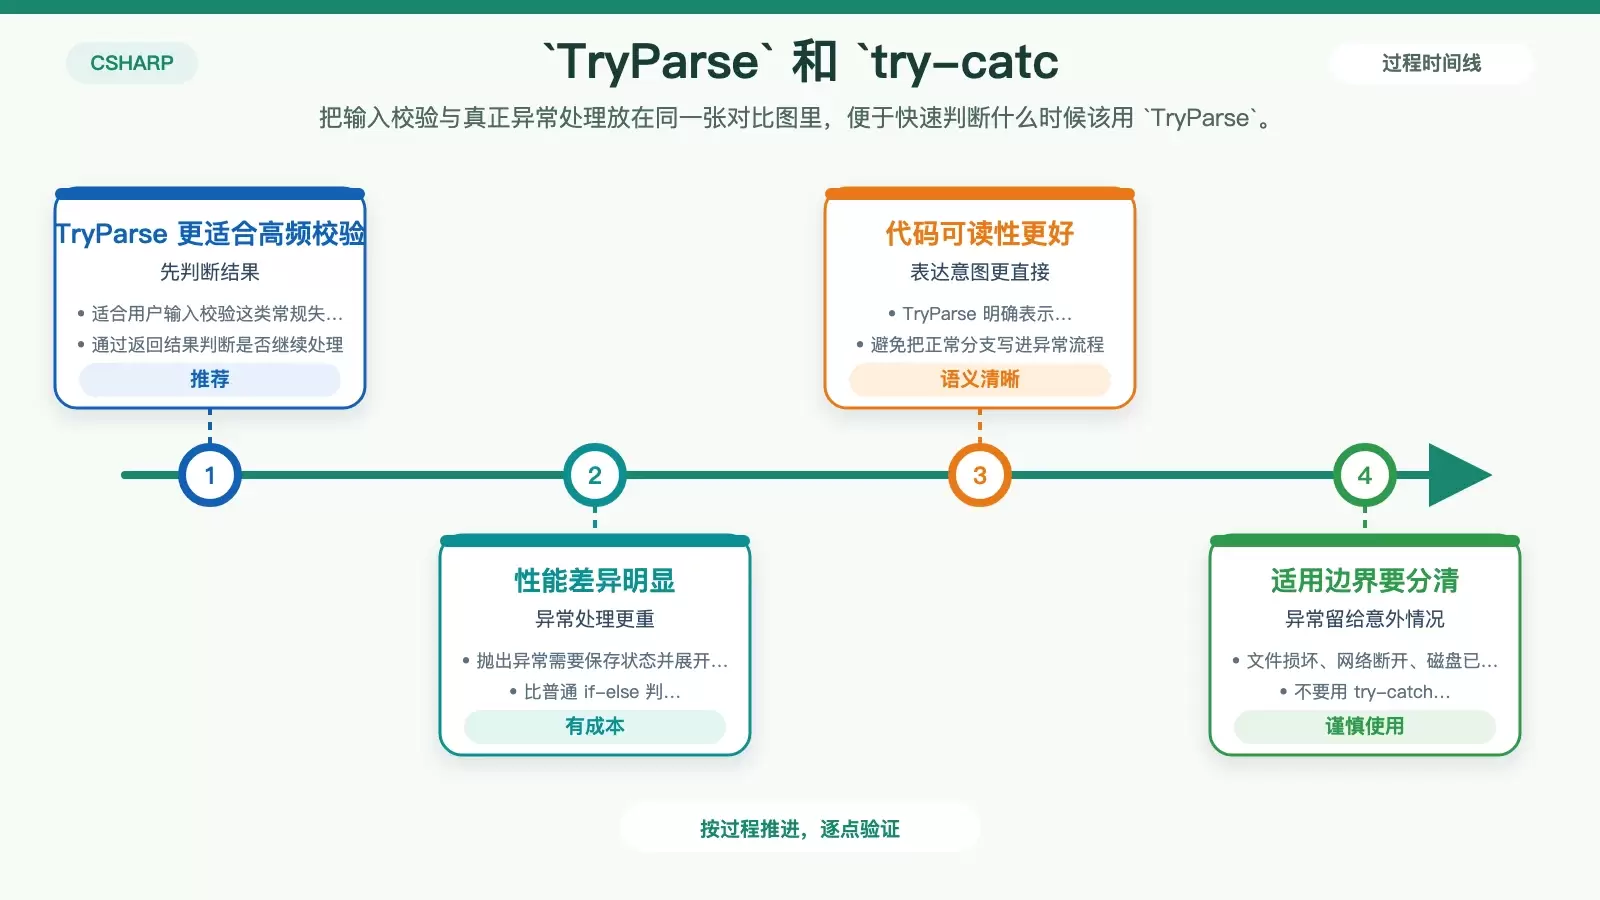
这两种写法都能达到目的,但适用场景不同:
- 性能:抛出和捕获异常的成本很高,CLR 需要保存执行状态、展开调用堆栈并搜索匹配的
catch,明显重于普通分支判断。 - 语义清晰度:
TryParse明确表达“这本来就是可能失败的常规分支”;而用try-catch做输入校验,容易把正常流程和异常流程混在一起。 - 具体选择:用户输入错误、字典查找失败这类高频且可预期的情况,优先用
TryParse这一类模式;文件损坏、网络断开、磁盘已满这类真正的异常情况,再交给try-catch。
一句话总结:不要用异常来控制程序流程。异常处理是为意外准备的,不是为日常分支准备的。
入门阶段最值得记住的几个判断
- 异常是运行时问题,和语法错误、业务逻辑错误不是一回事。
try里放可能失败的代码,catch里写清楚恢复、提示或记录策略。- 多个
catch必须先具体、后通用,否则匹配规则会出问题。 - 不要写空
catch,至少要记录异常。 - 面对可预期、经常发生的失败分支,优先考虑
TryParse这类返回结果的 API。















