


Python使用random模块打乱数组顺序的两种方法

本文介绍Python中利用random模块打乱数组顺序的两种方法。通过iris数据集示例,演示如何使用sample()生成新索引序列以重排数据,以及shuffle()直接修改原列表。重点强调shuffle无返回值及sample返回新列表的区别,帮助开发者避免常见错误。
在处理数据时,若需保持数据内容不变而仅改变其排列顺序,可通过重新随机排列索引值来生成新数组。这一功能主要依赖Python标准库中random模块提供的sample()函数实现。
sample(population, k) method of random.Random instance
 Chooses k unique random elements from a population sequence or set.
以下代码示例演示如何打乱iris数据集的顺序。该数据集为常见的CSV格式文件,包含三种鸢尾花(setosa、versicolor和virginica)的记录,具体字段包括SepalLengthCm(花萼长度)、SepalWidthCm(花萼宽度)、PetalLengthCm(花瓣长度)和PetalWidthCm(花瓣宽度)。
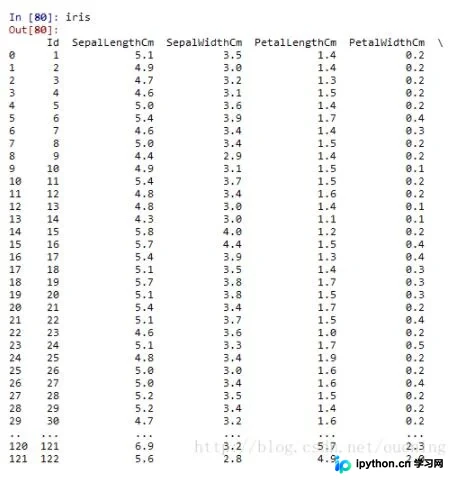
在进行聚类分析时曾使用iris数据。若环境中已安装scikit-learn模块,可通过直接加载该数据集。
from sklearn import datasets
iris = datasets.load_iris()
获取
参考链接:http://scikit-learn.org/stable/auto_examples/datasets/plot_iris_dataset.html
以下程序展示了如何打乱iris数据的顺序:
import pandas as pd
import random as rd # 导入random模块,使用里面的sample函数
from pylab import *
iris = pd.read_csv('D:\\Iris.csv')
a1=reshape(iris['Id'],[150,1])
a2=reshape(iris['SepalLengthCm'],[150,1])
a3=reshape(iris['SepalWidthCm'],[150,1])
data=c_[a1,a2,a3]
idx=rd.sample(range(150),150)

iris = data[idx] # 打乱顺序,这里只选取了花萼长度和宽度这两个特征值
2017/7/10 updated
另一种打乱顺序的方法是使用random.shuffle(iterable),该方法会直接修改传入的可迭代对象顺序。shuffle意为洗牌,需注意random.shuffle()函数没有返回值。若执行,将不会得到任何结果。
mylist = random.shuffle(list1)
将不会得到任何结果
以上关于Python random模块打乱数组顺序的实例讲解到此结束,希望能为您提供参考,并欢迎您支持本站。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















