


Python3爬取英雄联盟英雄皮肤大图实例代码

本文详细解析了使用Python3抓取英雄联盟英雄皮肤大图的技术路径。通过分析网页源码中的JavaScript文件,定位英雄列表及皮肤URL拼接规则,利用requests和json模块实现自动化下载。文章提供了完整的Python3.6运行环境配置、依赖模块说明及GitHub源码链接,帮助开发者掌握前端数据提取与后端爬虫结合的实现方法。
爬虫思路
初步尝试
首先检查网络请求(Network),未发现可用的直接API接口;随后尝试使用bs4解析英雄列表页,但发现请求返回的HTML中不包含实际的英雄列表数据,相关节点仅显示“正在加载中”的提示文本。对英雄详情页进行相同分析后,结果一致,由此推断这些数据由JavaScript动态加载。
继续尝试
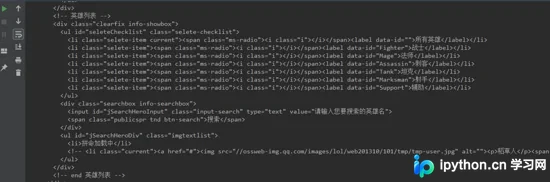
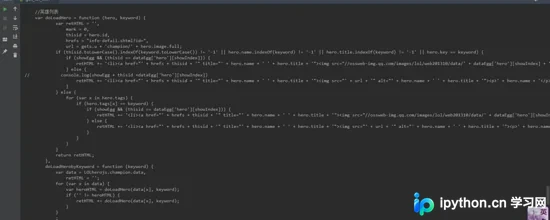
接着查看英雄列表页的源代码,检查外部引入的JS文件及行内脚本。在第368行附近发现处理英雄列表的JS注释,继续阅读代码后找到第一个关键线索:引入了一个名为champion.js的文件,推测该文件包含完整的英雄列表数据。打开该链接查看JS内容,虽然格式压缩严重,但经格式化处理后确认其为英雄列表的JS数据源。
接着尝试
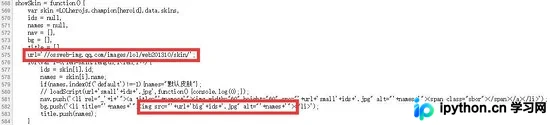
基于前一步在列表源码中找到英雄列表JS数据文件的经验,继续随机点击一个英雄详情页,查看其源代码。在第568行附近发现一个名为showSkin的JS方法,通过该方法找到第二个关键线索:皮肤图片URL地址的拼接规则。
最后尝试
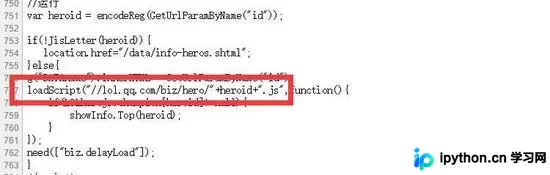
既然已掌握皮肤图片URL的拼接方法,并注意到一行关键代码 `var skin =LOLherojs.champion[heroid].data.skins`,可知skin变量存储了该英雄所有皮肤的图片数组。但该文件内部并未定义LOLherojs变量,说明其为外部引入。继续向下查看源代码以定位该变量的引入位置,最终在第757行找到最后一个关键线索:英雄皮肤的JS文件。由此确认每个英雄都有独立的JS文件,并掌握了该JS文件的URL拼接方法。
思路总结
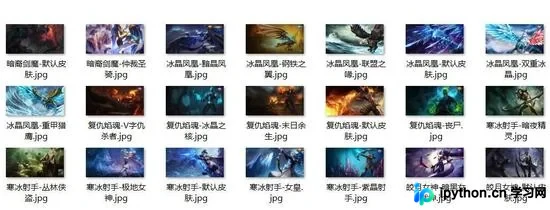
通过上述分析,已获取爬取LOL皮肤图片所需的全部数据准备。核心逻辑简化为:直接提取JS文件中的英雄列表及英雄详情数据即可实现抓取需求。以下是运行后抓取到的图片展示……
运行环境
Python运行环境:python3.6
用到的模块:requests、json、urllib、os
未安装的模块,请使用pip install进行安装,例如:pip install requests
完整代码
省略其他无关说明,直接提供完整代码。如有问题可直接留言,代码已上传至GitHub。此外,若有英雄详情的JS文件存在异常,读者可自行研究;若存在更快捷的爬取方法,欢迎交流讨论,谢谢。
#!/usr/bin/env python
# -*- coding: utf-8 -*-
"""
抓取英雄联盟英雄全皮肤
author: gxcuizy
date: 2018-11-13
"""
import requests
import json
from urllib import parse
import os
class GetLolSkin(object):
  """抓取LOL英雄皮肤"""
  def __init__(self):
    """初始化变量"""
    self.hero_url = 'https://lol.qq.com/biz/hero/champion.js'
    self.hero_detail_url = 'http://lol.qq.com/biz/hero/'
    self.skin_folder = 'skin'
    self.skin_url = 'https://ossweb-img.qq.com/images/lol/web201310/skin/big'
  @staticmethod
  def get_html(url):
    """下载html"""
    request = requests.get(url)
    request.encoding = 'gbk'
    if request.status_code == 200:
      return request.text
    else:
      return "{}"
  def get_hero_list(self):
    """获取英雄的完整信息列表"""
    hero_js = self.get_html(self.hero_url)
    # 删除左右的多余信息,得到json数据
    out_left = "if(!LOLherojs)var LOLherojs={};LOLherojs.champion="
    out_right = ';'
    hero_list = hero_js.replace(out_left, '').rstrip(out_right)
    return json.loads(hero_list)
  def get_hero_info(self, hero_id):
    """获取英雄的详细信息"""
    # 获取js详情
    detail_url = parse.urljoin(self.hero_detail_url, hero_id + '.js')
    detail_js = self.get_html(detail_url)
    # 删除左右的多余信息,得到json数据
    out_left = "if(!herojs)var herojs={champion:{}};herojs['champion'][%s]=" % hero_id
    out_right = ';'
    hero_info = detail_js.replace(out_left, '').rstrip(out_right)
    return json.loads(hero_info)
  def download_skin_list(self, skin_list, hero_name):
    """下载皮肤列表"""
    # 循环下载皮肤
    for skin_info in skin_list:
      # 拼接图片名字
      if skin_info['name'] == 'default':
        skin_name = '默认皮肤'
      else:
        if ' ' in skin_info['name']:
          name_info = skin_info['name'].split(' ')
          skin_name = name_info[0]
        else:
          skin_name = skin_info['name']
      hero_skin_name = hero_name + '-' + skin_name + '.jpg'
      self.download_skin(skin_info['id'], hero_skin_name)
  def download_skin(self, skin_id, skin_name):
    """下载皮肤图片"""
    # 下载图片
    img_url = self.skin_url + skin_id + '.jpg'
    request = requests.get(img_url)
    if request.status_code == 200:
      print('downloading……%s' % skin_name)
      img_path = os.path.join(self.skin_folder, skin_name)
      with open(img_path, 'wb') as img:
        img.write(request.content)
    else:
      print('img error!')
  def make_folder(self):
    """初始化,创建图片文件夹"""
    if not os.path.exists(self.skin_folder):
      os.mkdir(self.skin_folder)
  def run(self):
    # 获取英雄列表信息
    hero_json = self.get_hero_list()
    hero_keys = hero_json['keys']
    # 循环遍历英雄
    for hero_id, hero_code in hero_keys.items():
      hero_name = hero_json['data'][hero_code]['name']
      hero_info = self.get_hero_info(hero_id)
      if hero_info:
        skin_list = hero_info['result'][hero_id]['skins']
        # 下载皮肤
        self.download_skin_list(skin_list, hero_name)
      else:
        print('英雄【%s】的皮肤获取有问题……' % hero_name)
# 程序执行入口
if __name__ == '__main__':
  lol = GetLolSkin()
  # 创建图片存储文件
  lol.make_folder()
  # 执行脚本
  lol.run()
总结
以上介绍了Python3爬取英雄联盟英雄皮肤大图的实例代码,希望有所帮助。如有任何疑问,请留言,小编会及时回复。感谢大家对本站的支持!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















