


Python实现美拍短视频抓取与JS逆向解析实战

发布时间:2026-10-14 |
6人浏览过
本文详细介绍使用Python抓取美拍短视频的完整流程。从环境搭建到利用requests和xpath获取页面数据,重点解析如何通过JS逆向定位加密逻辑,将JavaScript中的Base64及自定义混淆算法转换为Python代码,最终实现视频地址的解密与下载。
一、抓取目标
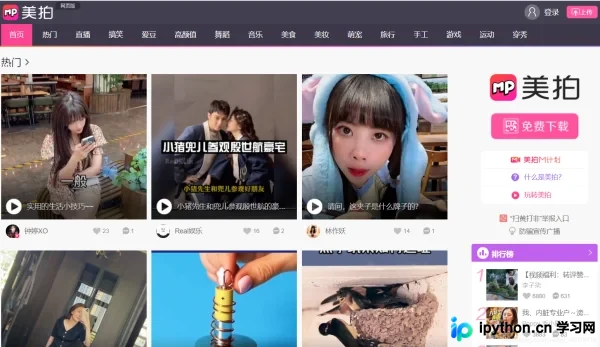
目标网址:美拍视频
二、工具使用
开发环境:win10、python3.7 开发工具:pycharm、Chrome 工具包:requests、xpath、base64
三、重点学习内容
爬虫采集数据的解析过程 js代码调试技巧 js逆向解析代码 Python代码的转换
四、项目思路解析
进入网站首页后,选择感兴趣的分类,并根据首页地址获取跳转至详情页面的超链接地址。
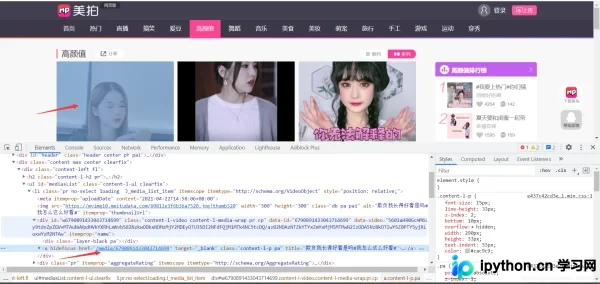
接下来需要定位到对应加密的视频播放地址数据。
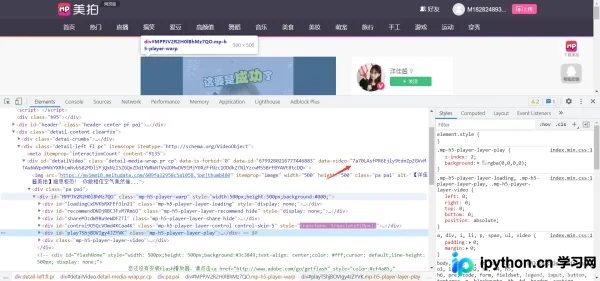
该数据属于静态网页内容,需通过js代码进行解码。具体步骤包括:找到对应的解析代码,先定位视频播放地址,再找到解析该地址的加密js文件,点击播放时会触发相关文件加载。
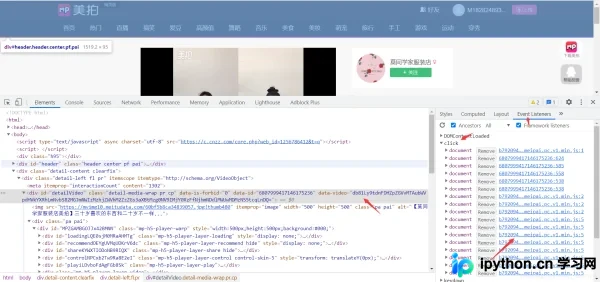
初步观察可发现这是base64加密后的数据。在对应的js文件中搜索关键字,从而找到js的加密方式。
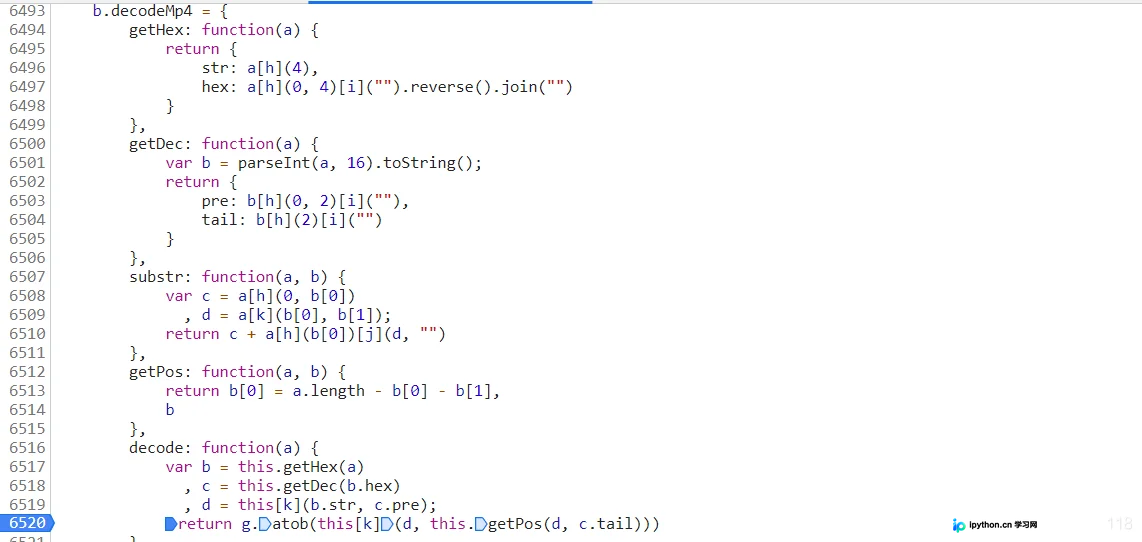
研究js函数中部分函数的具体用法。
# eplace()方法用于在字符串中用一些字符替换另一些字符
    # parseInt 数据转换成对应的整型
    # base64.atob   对base64编码过的字符串进行解码
    # substring 方法可在字符串中抽取从 start 下标开始的指定数目的字符
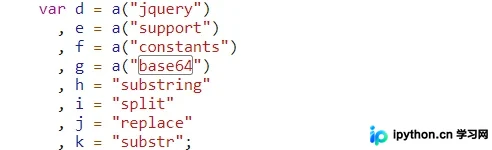
将js代码逻辑转换为Python代码。
import base64

def decode(data):
    def getHex(a):
        return {
            'str': a[4:],
            'hex': ''.join(list(a[:4])[::-1]),
        }

    def getDec(a):
        b = str(int(a, 16))
        return {
            'pre': list(b[:2]),
            'tail': list(b[2:]),
        }

    def substr(a, b):
        c = a[0: int(b[0])]
        d = a[int(b[0]): int(b[0]) + int(b[1])]
        return c + a[int(b[0]):].replace(d, "")

    def getPos(a, b):
        b[0] = len(a) - int(b[0]) - int(b[1])
        return b

    b = getHex(data)
    c = getDec(b['hex'])
    d = substr(b['str'], c['pre'])
    return base64.b64decode(substr(d, getPos(d, c['tail'])))

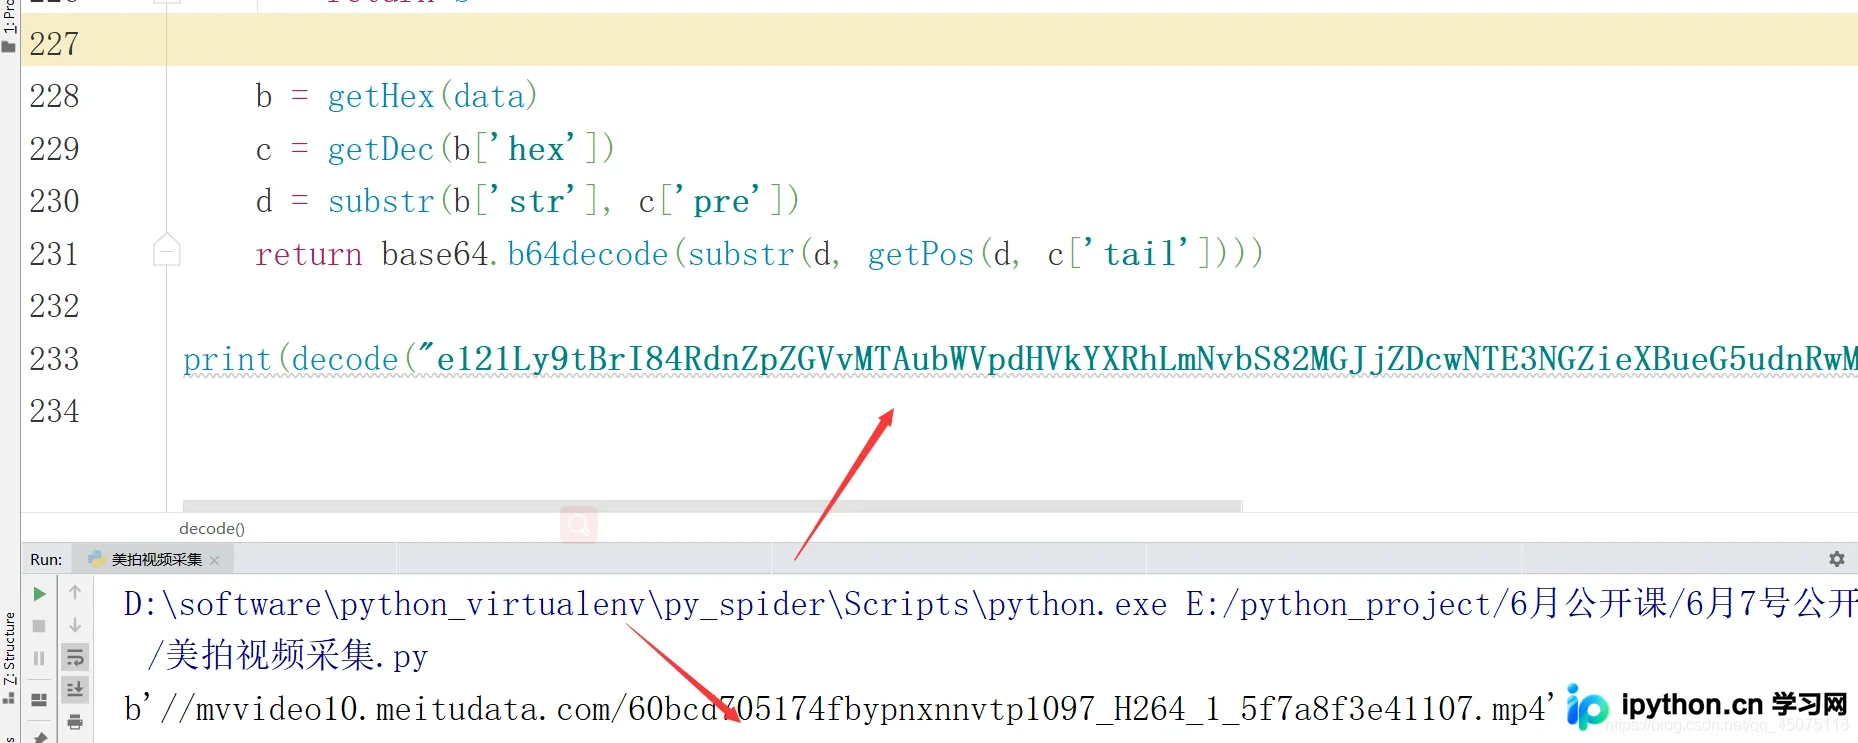
print(decode("e121Ly9tBrI84RdnZpZGVvMTAubWVpdHVkYXRhLmNvbS82MGJjZDcwNTE3NGZieXBueG5udnRwMTA5N19IMjY0XzFfNWY3YThmM2U0MTEwNy5tc2JVjAu3EDQ="))
通过上述转换与计算,得出最终的视频播放地址。
五、简易源码分享
import requests
from lxml import etree
import base64

def decode_mp4(data):
    def getHex(a):
        return {
            'str': a[4:],
            'hex': ''.join(list(a[:4])[::-1]),
        }

    def getDec(a):
        b = str(int(a, 16))
        return {
            'pre': list(b[:2]),
            'tail': list(b[2:]),
        }

    def substr(a, b):
        c = a[0: int(b[0])]
        d = a[int(b[0]): int(b[0]) + int(b[1])]
        return c + a[int(b[0]):].replace(d, "")

    def getPos(a, b):
        b[0] = len(a) - int(b[0]) - int(b[1])
        return b

    b = getHex(data)
    c = getDec(b['hex'])
    d = substr(b['str'], c['pre'])
    return base64.b64decode(substr(d, getPos(d, c['tail'])))
# 运行主函数
def main():
    url = 'https://www.meipai.com'
    headers = {
        'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/75.0.3770.142 Safari/537.36',
    }
    response = requests.get(url=url, headers=headers)
    html_data = etree.HTML(response.text)
    href_list = html_data.xpath('//div/a/@href')
    # print(href_list)
    for href in href_list:
        res = requests.get('https://www.meipai.com' + href, headers=headers)
        html = etree.HTML(res.text)
        name = html.xpath('//div[@id="detailVideo"]/img/@alt')[0]
        mp4_data = html.xpath('//div[@id="detailVideo"]/@data-video')[0]
        # print(name, mp4_data)
        mp4_url = decode_mp4(mp4_data).decode('utf-8')
        print(mp4_url)
        result = requests.get("http:" + mp4_url)
        with open(name + ".mp4", 'wb') as f:
            f.write(result.content)
            f.close()


if __name__ == '__main__':
    main()
到此这篇关于Python爬取某拍短视频的文章就介绍到这了,更多相关Python爬取视频内容请搜索本站以前的文章或继续浏览下面的相关文章希望大家以后多多支持本站!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















