


Python基于itchat实现微信好友数据分析与可视化

发布时间:2026-10-13 |
7人浏览过
本文介绍如何利用Python的itchat库获取微信好友信息,并通过pandas、matplotlib及jieba等工具对好友的性别、省份分布及个性签名进行统计分析。文章提供了完整的代码实现思路,包括数据清洗、词频统计及词云生成方法,帮助开发者快速掌握微信社交数据的分析与可视化技巧。
本文基于微信开放的个人号接口Python库itchat,实现了对微信好友信息的获取功能,并进一步对好友的省份分布、性别比例以及微信个性签名进行了详细的数据分析。
运行效果如下所示:
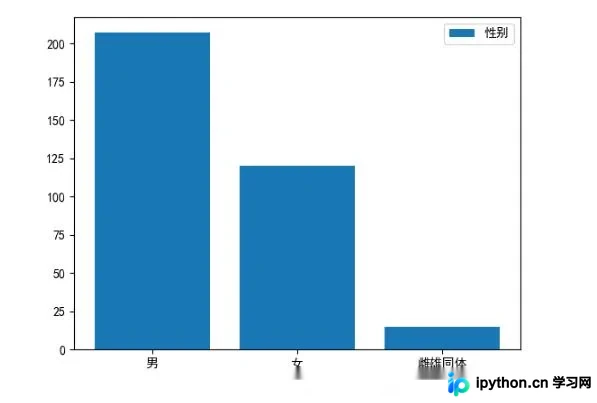
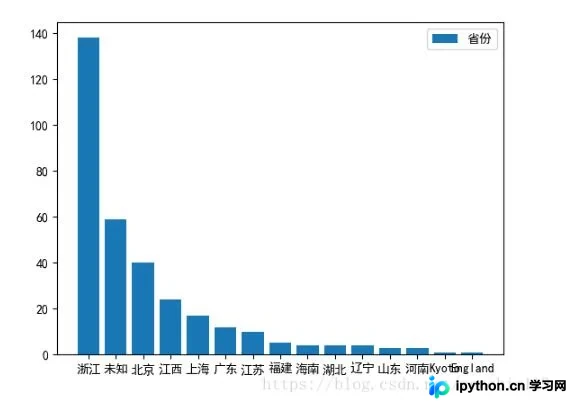
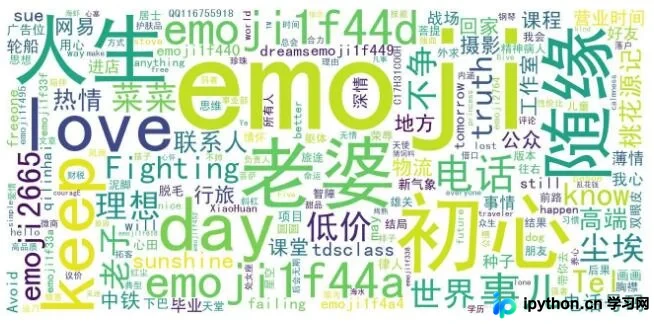
以下是具体代码实现。首先,请创建三个空的文本文件,分别命名为stopwords.txt、newdit.txt和unionWords.txt。此外,需下载simhei.ttf字体文件,或者在代码中移除对字体的要求,即可直接运行程序。
 #wxfriends.py 2018-07-09
import itchat
import sys
import pandas as pd
import matplotlib.pyplot as plt
plt.rcParams['font.sans-serif']=['SimHei']#绘图时可以显示中文
plt.rcParams['axes.unicode_minus']=False#绘图时可以显示中文
import jieba
import jieba.posseg as pseg
from scipy.misc import imread
from wordcloud import WordCloud
from os import path
#解决编码问题
non_bmp_map = dict.fromkeys(range(0x10000, sys.maxunicode + 1), 0xfffd)


#获取好友信息
def getFriends():
 friends = itchat.get_friends(update=True)[0:]
 flists = []
 for i in friends:
  fdict={}
  fdict['NickName']=i['NickName'].translate(non_bmp_map)
  if i['Sex'] == 1:
   fdict['Sex']='男'
  elif i['Sex'] == 2:
   fdict['Sex']='女'
  else:
   fdict['Sex']='雌雄同体'
  if i['Province'] == '':
   fdict['Province'] ='未知'
  else:
   fdict['Province']=i['Province']
  fdict['City']=i['City']
  fdict['Signature']=i['Signature']
  flists.append(fdict)
 return flists


#将好友信息保存成CSV
def saveCSV(lists):
 df = pd.DataFrame(lists)
 try:
  df.to_csv("wxfriends.csv",index = True,encoding='gb18030')
 except Exception as ret:
  print(ret)
 return df


#统计性别、省份字段
def anysys(df):
 df_sex = pd.DataFrame(df['Sex'].value_counts())
 df_province = pd.DataFrame(df['Province'].value_counts()[:15])
 df_signature = pd.DataFrame(df['Signature'])
 return df_sex,df_province,df_signature


#绘制柱状图,并保存
def draw_chart(df_list,x_feature):
 try:
  x = list(df_list.index)
  ylist = df_list.values
  y = []
  for i in ylist :
   for j in i:
    y.append(j)
  plt.bar(x,y,label=x_feature)
  plt.legend()
  plt.savefig(x_feature)
  plt.close()
 except:
  print("绘图失败")


#解析取个性签名构成列表
def getSignList(signature):
 sig_list = []
 for i in signature.values:
  for j in i:
   sig_list.append(j.translate(non_bmp_map))
 return sig_list


#分词处理,并根据需要填写停用词、自定义词、合并词替换
def segmentWords(txtlist):
 stop_words = set(line.strip() for line in open('stopwords.txt', encoding='utf-8'))
 newslist = []
 #新增自定义词
 jieba.load_userdict("newdit.txt")
 for subject in txtlist:
  if subject.isspace():
   continue
  word_list = pseg.cut(subject)

  for word, flag in word_list:
   if not word in stop_words and flag == 'n' or flag == 'eng' and word !='span' and word !='class':
    newslist.append(word)
  #合并指定的相似词
 for line in open('unionWords.txt', encoding='utf-8'):
  newline = line.encode('utf-8').decode('utf-8-sig') #解决\ufeff问题
  unionlist = newline.split("*")
  for j in range(1,len(unionlist)):
   #wordDict[unionlist[0]] += wordDict.pop(unionlist[j],0)
   for index,value in enumerate(newslist):
    if value == unionlist[j]:
     newslist[index] = unionlist[0]
 return newslist


#高频词统计
def countWords(newslist):
 wordDict = {}
 for item in newslist:
  wordDict[item] = wordDict.get(item,0) + 1
 itemList = list(wordDict.items())
 itemList.sort(key=lambda x:x[1],reverse=True)
 for i in range(100):
  word, count = itemList[i]
  print("{}:{}".format(word,count))


#绘制词云
def drawPlant(newslist):
 d = path.dirname(__file__)
 mask_image = imread(path.join(d, "timg.png"))
 content = ' '.join(newslist)
 wordcloud = WordCloud(font_path='simhei.ttf', background_color="white",width=1300,height=620, max_words=200).generate(content) #mask=mask_image,
 # Display the generated image:
 plt.imshow(wordcloud)
 plt.axis("off")
 wordcloud.to_file('wordcloud.jpg')
 plt.show()


def main():
 #登陆微信
 itchat.auto_login() # 登陆后不需要扫码 hotReload=True
 flists = getFriends()
 fdf = saveCSV(flists)
 df_sex,df_province,df_signature = anysys(fdf)
 draw_chart(df_sex,"性别")
 draw_chart(df_province,"省份")
 wordList = segmentWords(getSignList(df_signature))
 countWords(wordList)
 drawPlant(wordList)

main()
以上就是本文的全部内容,希望这些内容能对读者的学习有所帮助,同时也欢迎大家多多支持本站。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















