


利用Python自动处理PDF复制换行并调用Google翻译

发布时间:2026-10-13 |
4人浏览过
本文介绍如何使用Python脚本解决从PDF复制内容到Google翻译时产生的换行问题。通过监控剪贴板并将换行符替换为空格,实现内容格式化。进阶方案结合webbrowser模块,自动构建翻译链接并在Chrome中打开,实现从复制到翻译的一键自动化操作。
在将PDF文档内容复制到Google翻译时,经常会出现意外的换行现象,导致翻译结果混乱。如果手动逐一去除这些换行符,操作过程会显得非常繁琐且耗时。
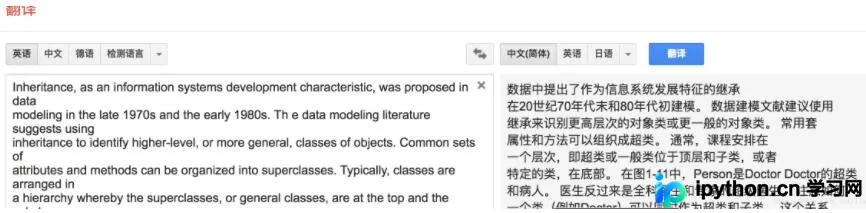
借助Python脚本可以有效解决这一痛点。当内容被复制到系统剪贴板后,程序会自动检测并将其中的换行符(\n)替换为空格,从而整理好文本格式,使用户能够顺利地将处理后的内容粘贴至Google翻译界面。
具体实现代码如下:
import pyperclip
import time
import webbrowser
copyBuff=' '
while True:
 time.sleep(10)
 copyedText=pyperclip.paste()
 if copyBuff!=copyedText:
  copyBuff=copyedText
  normalizedText = copyBuff.replace('\n', ' ')
  pyperclip.copy(normalizedText)
 else:
  print('no change')
尽管上述方法解决了换行问题,但操作步骤仍显冗余。为了进一步提升效率,我们可以优化代码逻辑,实现在复制内容后自动调用Google翻译,无需手动跳转。以下是改进后的代码方案:
import pyperclip
import time
import webbrowser
copyBuff=' '
while True:
 time.sleep(10)
 copyedText=pyperclip.paste()
 if copyBuff!=copyedText:
  copyBuff=copyedText

  normalizedText = copyBuff.replace('\n', ' ')

  url='https://translate.google.cn/#en/zh-CN/'+normalizedText

  #webbrowser.open(url)之前这么做的,默认用Safari打开,404 not found
  #所以要用chrome打开就OK啦
  w = webbrowser.get('chrome')
  w.open(url)

 else:
  print('no change')
经过优化,操作流程已变得十分顺畅。
以上关于利用Python解决PDF复制至Google翻译换行问题的方案即为完整分享。希望该技巧能为读者提供实用参考,也欢迎继续支持本站获取更多技术内容。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















