


Python含中文字符串正则表达式的编码处理与实战

本文详细解析Python中处理含中文字符串时的编码问题,重点讲解str与unicode的转换机制及正则表达式匹配中文的规则。通过Python2.7环境下的实测案例,演示了如何正确设置文件编码、处理不同编码格式文件的读取显示,以及利用Unicode范围匹配中日韩文字与标点符号,为开发中解决中文乱码和匹配问题提供实用参考。
前言
Python源文件默认采用ascii编码格式,由于ascii码表中不包含中文字符,因此直接处理汉字会导致识别错误。
若需在Python文件中编写或处理中文字符,通常需要在文件头部添加 # -*- coding: utf-8 -*- 或 #coding=utf-8 声明。
该声明用于指定文件的编码格式,表明中文字符将以指定的编码(如utf-8、gbk或gb2312等)进行存储和解析。
关于测试的几点注意 --------------------------------------------
注1:若代码中包含中文字符,必须在文件头部明确指定编码方式;此外,若使用集成开发环境(IDE)编写代码,还需确保IDE的文件存储编码格式(通常在设置中配置)与声明一致。
注2:Python 3.x版本的源文件默认使用utf-8编码,能够直接解析中文,因此头部不指定编码也可运行。但为了保持代码规范并避免潜在兼容性问题,建议显式指定编码。
注3:Linux交互式命令行(左侧)与Python脚本文件(右侧)的运行结果存在差异:
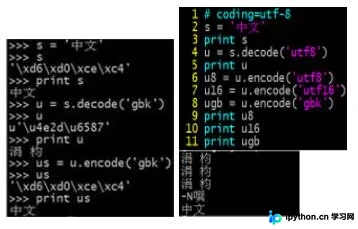
左侧截图中,由于CMD终端设置了gbk编码格式,变量u是字符串s经gbk解码后得到的unicode对象。为使print正常显示原始中文字符,需再次将其编码为gbk;右侧截图中,Python文件指定了utf-8编码,因此u是字符串s经utf-8解码后的unicode对象(若使用其他编码会导致运行错误),且要在屏幕打印中文,还需将其encode为CMD设置的编码格式,否则将显示乱码。
注4:在测试中文字符的显示和正则匹配时,建议优先使用Python脚本文件编写,否则当交互环境与文件编码不一致时,极易出现令人困惑的乱码问题。
----------------------------------------------------------------
以下实验基于Python 2.7版本及Linux系统环境,未测试Windows控制台及Windows下的IDE表现;
以下实验旨在通过转码测试,实现中文字符的正常显示及正则表达式对中文的准确匹配。
(一)Python的str和中文字符串
简而言之,编码过程指将unicode转换为ch-str(字符字符串),解码过程指将ch-str转换为unicode。
关于print显示中文的示例:使用编码内容相同但编码格式分别为gb18030和utf-8的两份文档进行测试:
#coding=utf-8
import sys
with open('ch_input_gbk', 'r') as f1, open('ch_input_utf', 'r') as f2:
 for l1 in f1:
 lines = l1.strip().split('\t') # lines是list, 通过打印它可以看看str不同编码的内容
 sent = lines[0]   # sent是ch-str
 print lines, sent
 for l2 in f2:
 lines = l2.strip().split('\t')
 sent = lines[0]
 print lines, sent
 print sent.decode('utf8').encode('gbk')
 #print str(sent).decode('string_escape').decode('utf8').encode('gbk')
输出结果如下:
['\xd3\xc4\xc8\xcb\xd6\xf1\xc9\xa3\xd4\xb0'] 幽人竹桑园 ['\xb9\xe9\xce\xd4\xbc\xc5\xce\xde\xd0\xfa'] 归卧寂无喧 ['\xce\xef\xc7\xe9\xbd\xf1\xd2\xd1\xbc\xfb'] 物情今已见 ['\xb4\xd3\xb4\xcb\xd3\xfb\xce\xde\xd1\xd4'] 从此欲无言 ['\xe5\xb9\xbd\xe4\xba\xba\xe7\xab\xb9\xe6\xa1\x91\xe5\x9b\xad'] 骞戒汉绔规鍥 幽人竹桑园 ['\xe5\xbd\x92\xe5\x8d\xa7\xe5\xaf\x82\xe6\x97\xa0\xe5\x96\xa7'] 褰掑崸瀵傛棤鍠 归卧寂无喧 ['\xe7\x89\xa9\xe6\x83\x85\xe4\xbb\x8a\xe5\xb7\xb2\xe8\xa7\x81'] 鐗╂儏浠婂凡瑙 物情今已见 ['\xe4\xbb\x8e\xe6\xad\xa4\xe6\xac\xb2\xe6\x97\xa0\xe8\xa8\x80'] 浠庢娆叉棤瑷 从此欲无言
第7行中,f1文件的sent变量能正常显示,是因为txt文件采用gb18030编码,读取后仍保持该编码(这与文件首行的#coding声明无关),且我的CMD终端同样设置为gb18030编码。
第11行中,f2文件的sent变量显示乱码,是因为txt文件采用utf-8编码,读取后仍为utf-8格式,但print函数对str类型字符串是按CMD设置的编码格式进行解读的,导致不匹配。
第12行中,sent变量恢复正常显示,是因为执行了utf-8解码为unicode,再编码为gb18030的操作,使得print能够正确解读并显示。
第13行中,有时读取或抓取的中文内容并非\xd3\xc4,而是呈现为\\xd3\\xc4的形式,这是因为反斜杠\被转义了。对此类字符串无法直接进行decode编码转换,需先使用str(sent).decode('string_escape')去除反斜杠的转义,后续处理即与第12行一致。
附注:若在第12行直接编写 sent.encode('gbk'),将会报错:
UnicodeDecodeError: 'ascii' codec can't decode byte 0xe5 in position 0
该错误表明,当前位置的str字符串无法被Python默认的ascii编码解码,因为其内容为中文str;必须使用其实际的编码格式进行解码,而非默认的ascii。
解决方法1:修改Python默认编码,由ascii改为当前str的实际编码(如utf-8或gb18030等)。
reload(sys)
sys.setdefaultencoding('utf8')
解决方法2:然而,当读取多个包含多种编码格式的文档时,方法1并不便捷。因此,更推荐对不同ch-str统一采用转换为unicode再编码的方式(如上述示例中的做法)。
(二)中文字符串的正则匹配
核心原则仅有一条:匹配字符串与原字符串的编码必须统一。
继续通过示例说明:
# -*- coding: utf-8 -*-
import re
def findPart(regex, text, name):
 res = re.findall(regex, text)
 print "There are %d %s parts:" % (len(res), name)
 for r in res:
 print r.encode('gbk')

sample = '''en: Regular expression is a powerful tool for manipulating text.
  zh: 正则表达式是一种很有用的处理文本的工具。
  jp: 正規表現は非常に役に立つツールテキストを操作することです。
  jp-char: あアいイうウえエおオ
  kr:정규 표현식은 매우 유용한 도구 텍스트를 조작하는 것입니다.
  puc: ,。?!:,.?!:《》%&*#<>%&*#
  '''
#convert the utf8 to unicode
usample = unicode(sample,'utf8') #相当于usample = sample.decode('utf8')

#get each language parts:
findPart(u"[\u4e00-\u9fa5]+", usample, "unicode chinese")
findPart(u"[\uac00-\ud7ff]+", usample, "unicode korean")
findPart(u"[\u30a0-\u30ff]+", usample, "unicode japanese katakana")
findPart(u"[\u3040-\u309f]+", usample, "unicode japanese hiragana")
findPart(u"[\u3000-\u303f\ufb00-\ufffd]+", usample, "unicode cjk Punctuation")
第20行中,目标字符串usample为unicode类型,因此匹配字符串regex也需保持一致(例如u"[\u4e00-\u9fa5]+"),u前缀表示将其转换为unicode;
第7行中,usample为unicode类型,若要print正确显示,则需执行r.encode('gbk'),依据CMD的编码格式进行转换;
正则匹配规则此处不作赘述,[\u????-\u????] 代表不同语言的Unicode编码段,该例输出结果如下:
中文部分共6个part:正则表达式是一种很有用的处理文本的工具、正規表現、非常、役、立、操作
韩文部分共8个part:정규、표현식은、매우、유용한、도구、텍스트를、조작하는、것입니다
日文片假名部分共6个part:ツールテキスト、ア、イ、ウ、エ、オ
日文平假名部分共11个part:は、に、に、つ、を、することです、あ、い、う、え、お
非英文标点符号部分共4个part:。、。、,。?!:、《》%&*#
此外,列举几个简单的正则匹配示例:
s1 = '天天天向上天天向上'
print (re.sub(ur'[\u4e00-\u9fa5]{1,}', u'1', s1.decode('utf8'))).encode('gbk') # 1
print (re.sub(ur'([\u4e00-\u9fa5])\1{1,}', u'1', s1.decode('utf8'))).encode('gbk') # 1向上1向上
print (re.sub(ur'([\u4e00-\u9fa5])\1{2,}', u'1', s1.decode('utf8'))).encode('gbk') # 1向上天天向上
s2 = '【aa】天天bb@cc'
print (re.sub(ur'【.*】', u'1', s2.decode('utf8'))).encode('gbk')   # 1天天bb@cc
print (re.sub(ur'@', u'1', s2.decode('utf8'))).encode('gbk')   # 【aa】天天bb1cc
第2行中,{1,}表示匹配1至n个前面的表达式,因此6个汉字全部被匹配;
第3行中,()内定义为一个group,\1指代第一个group,{1,}需再匹配1至n个前面group的内容(若group内仅1个字,{1,}需匹配第2个及之后的字),因此匹配了3个天和2个天;
第6行和第7行中,涉及中英文标点符号匹配。若regex中未使用转义符,可不写r;若text全为英文,也可不写u。
以上关于Python下含中文字符串正则表达式编码问题的探讨即为全部内容,希望能为大家提供参考,也希望大家多多支持本站。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















