


Python机器学习实战:scikit-learn封装KNN算法详解

发布时间:2026-10-13 |
4人浏览过
本文详细介绍如何在Python中利用scikit-learn库封装K近邻(KNN)算法。内容涵盖环境准备、核心代码实现及预测流程,重点解析无需显式训练过程但需拟合数据的特性,并提供完整的分类器封装与测试代码示例,帮助开发者快速掌握KNN在机器学习中的应用。
本文通过具体实例,深入解析Python机器学习领域中scikit-learn库内KNN(K近邻)算法的封装技巧与实际操作方法,旨在为读者提供具有参考价值的技术指南。
首先进行工具准备,确保开发环境已配置好Python运行环境,并推荐使用PyCharm作为集成开发工具。
在机器学习语境下,KNN算法具有特殊性:它无需传统的模型训练阶段。这意味着输入样例可直接调用predict方法获取预测结果,此时训练数据集本身即被视为模型。不过,必须将训练数据与对应的训练标签进行拟合操作,才能正式构建出可用的模型。
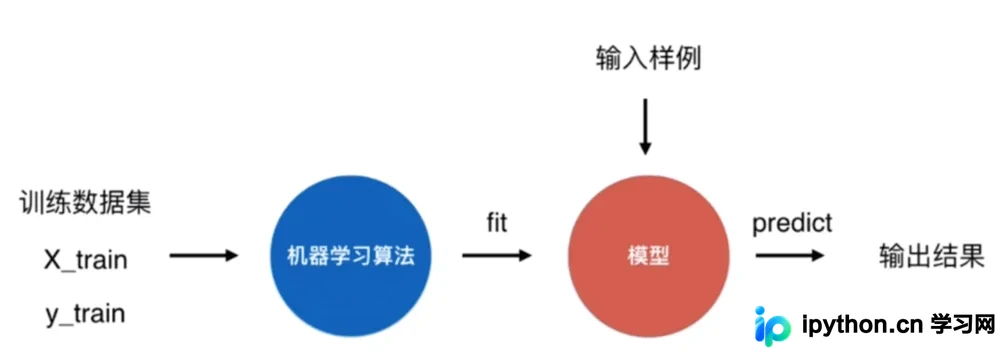
接下来,在PyCharm环境中创建一个新的项目工程,并在该项目目录下新建名为KNN.py的文件,用于存放核心算法代码。
import numpy as np
from math import sqrt
from collections import Counter
class KNNClassifier:
  def __init__(self,k):
    """初始化KNN分类器"""
    assert k >= 1
    """断言判断k的值是否合法"""
    self.k = k
    self._X_train = None
    self._y_train = None
  def fit(self,X_train,y_train):
    """根据训练数据集X_train和Y_train训练KNN分类器,形成模型"""
    assert X_train.shape[0] == y_train.shape[0]
    """数据和标签的大小必须一样
    assert self.k <= X_train.shape[0]
    """k的值不能超过数据的大小"""
    self._X_train = X_train
    self._y_train = y_train
    return self
  def predict(self,X_predict):
    """必须将训练数据集和标签拟合为模型才能进行预测的过程"""
    assert self._X_train is not None and self._y_train is not None
    """训练数据和标签不可以是空的"""
    assert X_predict.shape[1]== self._X_train.shape[1]
    """待预测数据和训练数据的列(特征个数)必须相同"""
    y_predict = [self._predict(x) for x in X_predict]
    return np.array(y_predict)
  def _predict(self,x):
    """给定单个待测数据x,返回x的预测数据结果"""
    assert x.shape[0] == self._X_train.shape[1]
    """x表示一行数据,即一个数组,那么它的特征数据个数,必须和训练数据相同
    distances = [sqrt(np.sum((x_train - x)**2))for x_train in self._X_train]
    nearest = np.argsort(distances)
    topk_y = [self._y_train[i] for i in nearest[:self.k]]
    votes = Counter(topk_y)
    return votes.most_common(1)[0][0]
随后,新建test.py文件,并在其中引入之前定义的KNNClassifier对象,以便进行后续的测试与调用。
from KNN.py import KNNClassifier
raw_data_x = [[3.393,2.331],
       [3.110,1.781],
       [1.343,3.368],
       [3.582,4.679],
       [2.280,2.866],
       [7.423,4.696],
       [5.745,3.533],
       [9.172,2.511],
       [7.792,3.424],
       [7.939,0.791]]
raw_data_y = [0,0,0,0,0,1,1,1,1,1]
X_train = np.array(raw_data_x)
y_train = np.array(raw_data_y)
x = np.array([9.880,3.555])
# 要将x这个矩阵转换成2维的矩阵,一行两列的矩阵
X_predict = x.reshape(1,-1)
"""1,创建一个对象,设置K的值为6"""
knn_clf = KNNClassifier(6)
"""2,将训练数据和训练标签融合"""
knn_clf.fit(X_train,y_train)
"""3,经过2才能跳到这里,传入待预测的数据"""
y_predict = knn_clf.predict(X_predict)
print(y_predict)
若读者对Python其他技巧感兴趣,可进一步查阅本站专题内容,包括《Python数学运算技巧总结》、《Python数据结构与算法教程》、《Python函数使用技巧总结》、《Python字符串操作技巧汇总》以及《Python入门与进阶经典教程》。
期望本文所述内容能对广大Python程序设计人员有所助益。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















