


Python爬虫实战:使用Requests与BS4抓取新浪新闻

本文详细介绍如何使用Python编写爬虫程序抓取新浪新闻。通过安装requests和bs4库,模拟浏览器请求获取原始数据,并解决常见的乱码问题。接着利用浏览器开发者工具定位HTML标签,结合BeautifulSoup解析提取新闻标题、发布时间及链接,最终实现结构化数据的自动采集。
提及Python,许多人首先联想到的是网络爬虫。近年来爬虫技术的兴起主要得益于大数据时代的到来,数据不再局限于单一服务器,而Python因其语法简洁、开发高效,成为构建爬虫工具的首选语言。本文将具体演示如何使用Python爬取新浪新闻数据。
爬虫的核心原理是模拟浏览器的HTTP请求,获取服务器返回的数据后,通过逻辑分析提取出目标信息。这一过程涵盖了请求发送、数据接收以及内容解析三个关键环节,构成了爬虫程序的基本实现流程。
在开发爬虫时,可参考现有工具以简化入门难度。首先涉及数据请求,Python中广泛使用的requests库能轻松处理HTTP交互;其次涉及数据解析,bs4(BeautifulSoup)库则是处理HTML/XML文档的利器。若系统已安装Python 3,可直接通过pip3命令进行安装;若为Python 2环境,则使用pip命令即可。
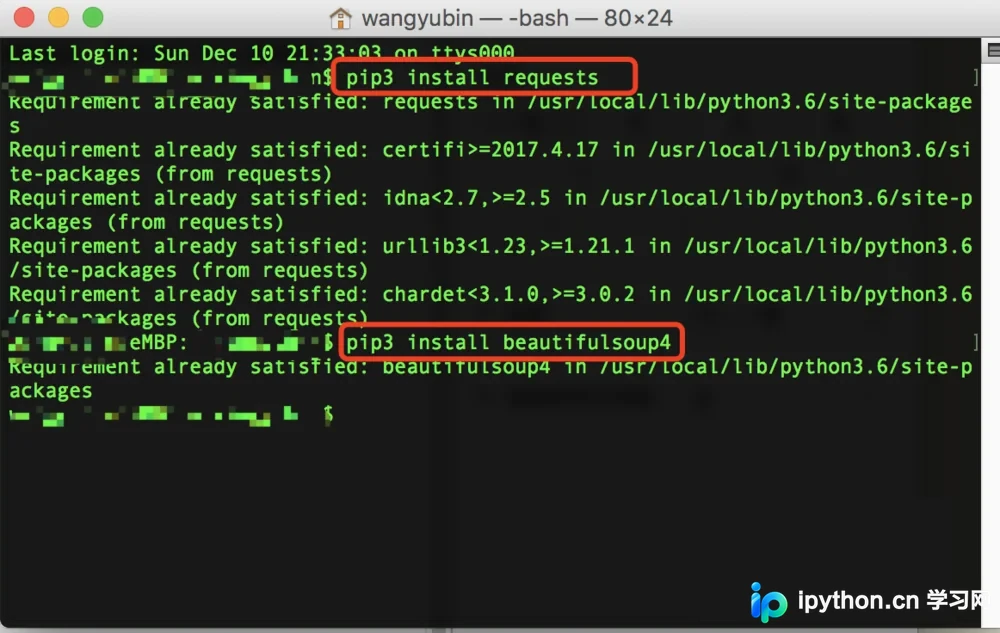
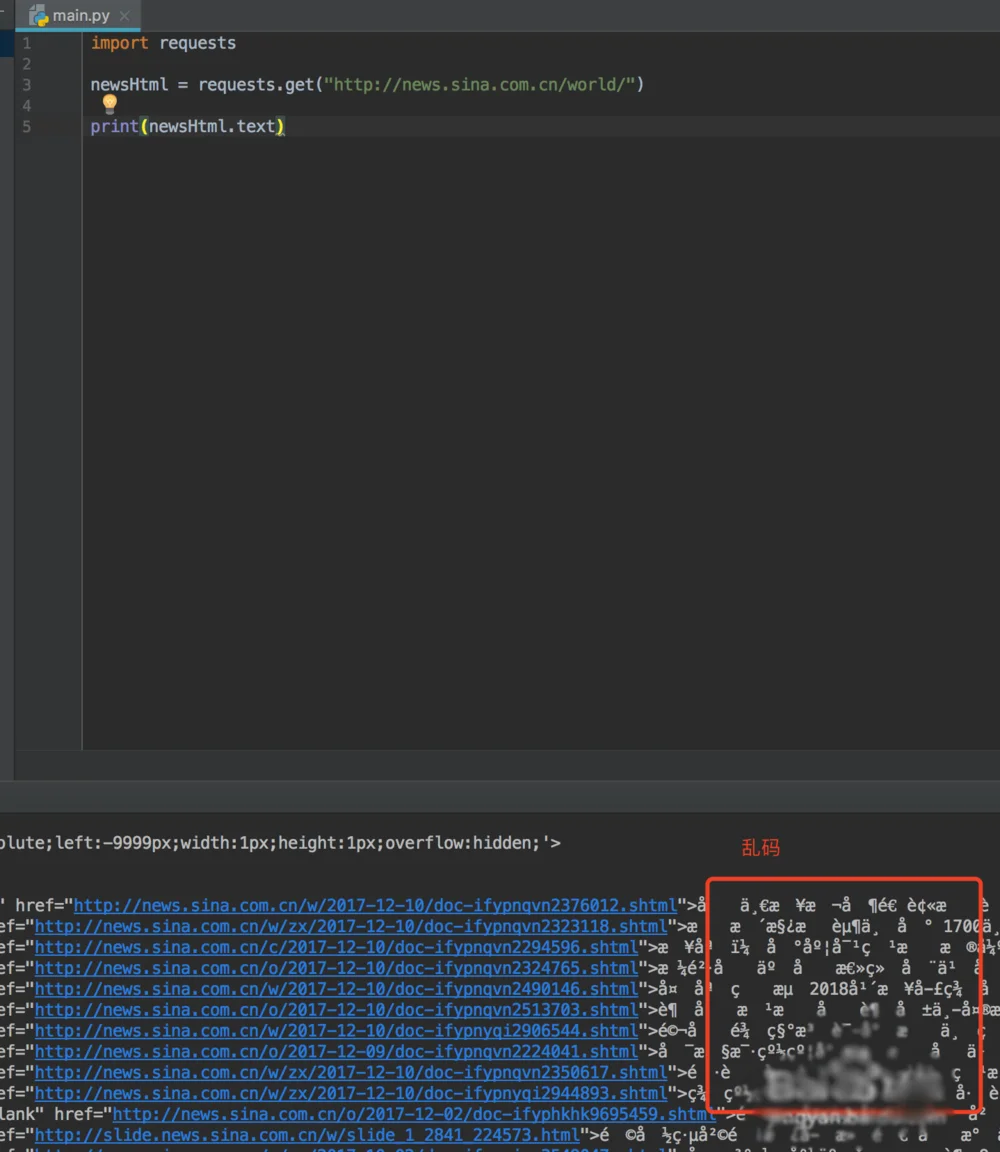
完成requests和bs4两个库的安装后,即可编写代码发起数据请求并获取新浪新闻页面的原始内容。此时直接输出结果,可能会发现中文内容显示为乱码,这是编码格式不匹配导致的常见现象。
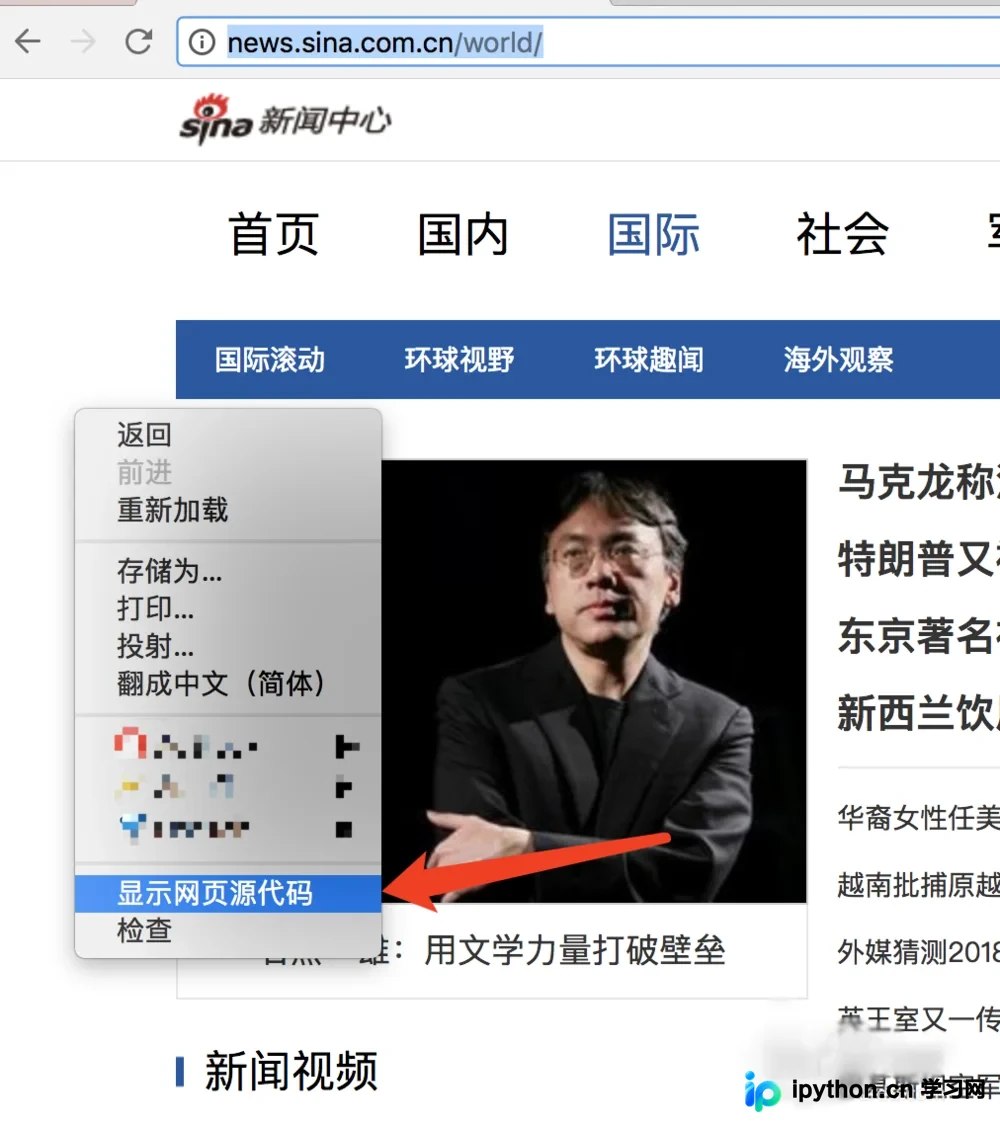
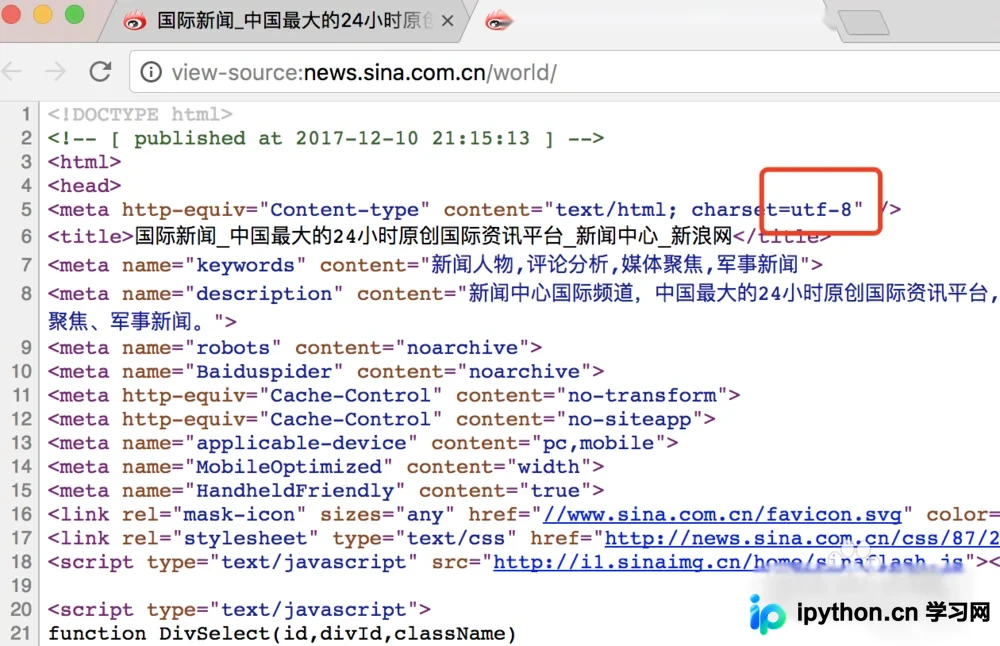
解决乱码问题的方法之一是检查网页的编码声明。用户可在浏览器中打开目标网页,右键点击“查看网页源代码”,在源码头部信息中通常能明确看到编码格式标记,例如utf-8。
在Python代码中输出数据前,需显式指定编码格式(如utf-8)。通过设置正确的编码参数,即可在控制台或文件中查看到正确显示的中文新闻内容,从而解决乱码问题。
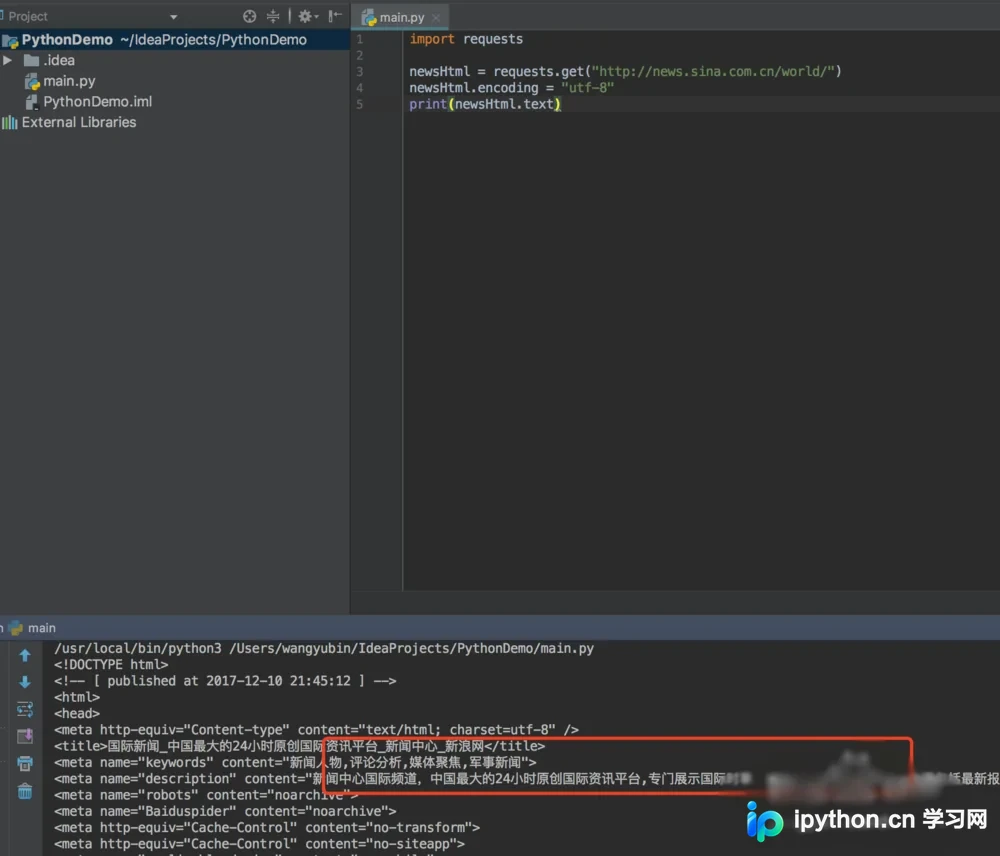
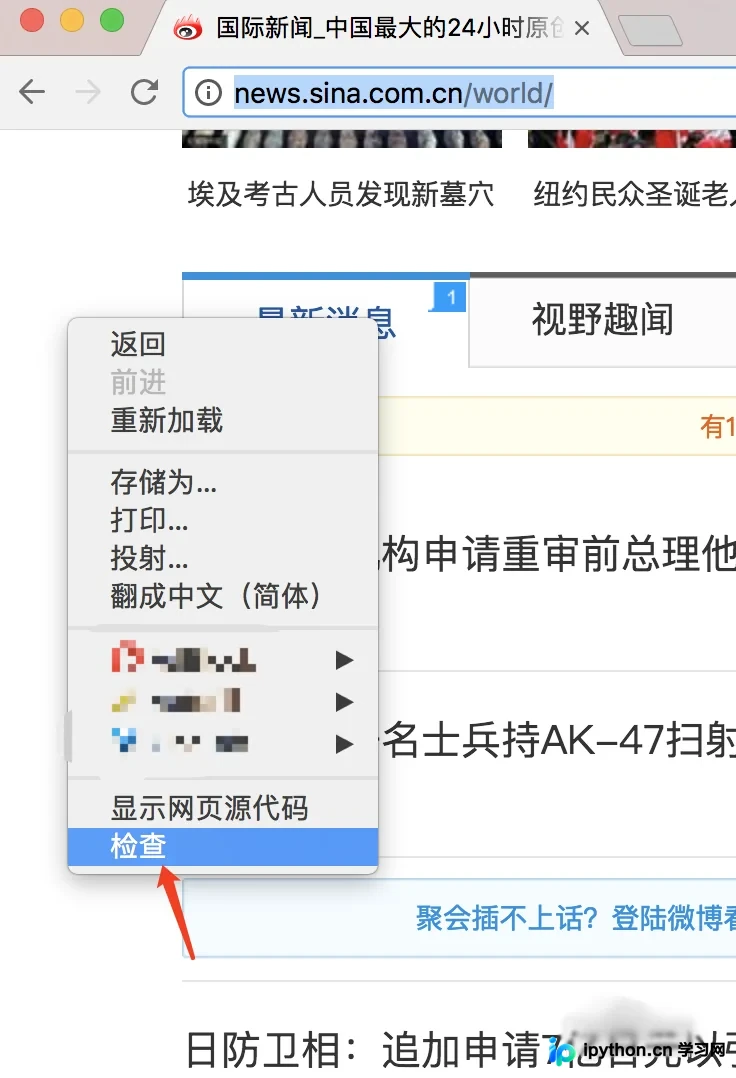
获取原始HTML数据后,下一步是分析数据结构以定位目标信息。用户可在浏览器中右键点击“审查元素”(或按F12打开开发者工具),根据示例图示操作,查找包含新闻内容的HTML标签。若使用Windows系统,同样可通过开发者工具中的Elements面板进行定位。
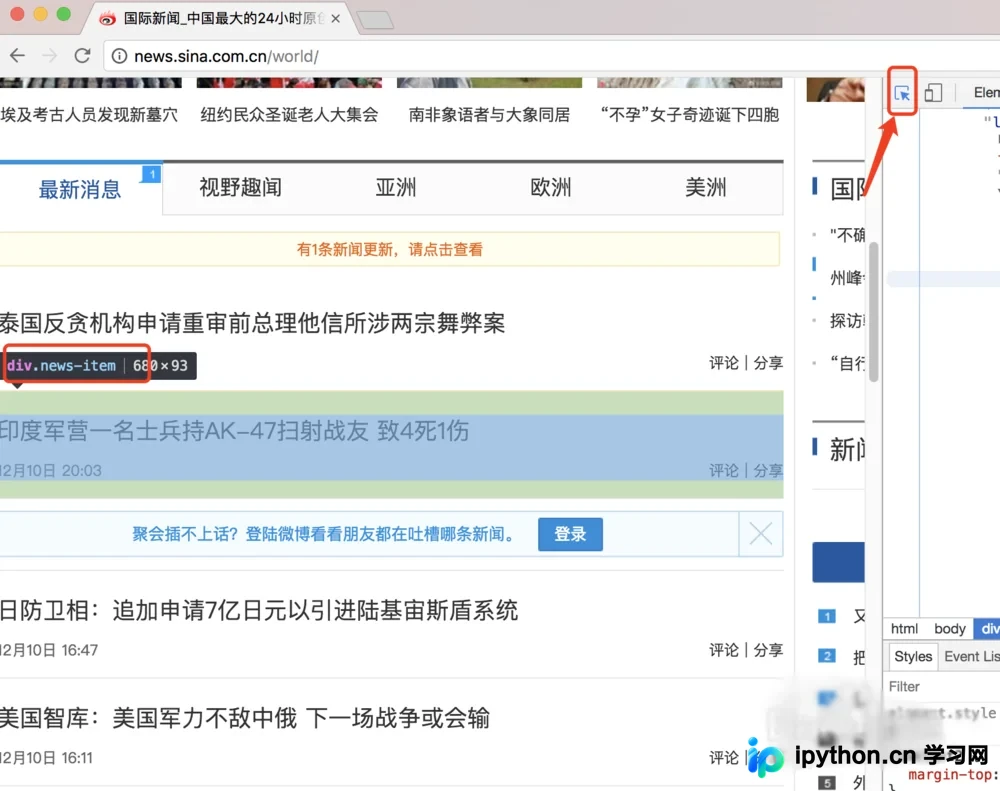
确定目标数据所在的HTML标签结构后,即可利用bs4库对HTML文档进行解析。通过指定标签名称、属性或CSS选择器,可以精准提取出我们需要的数据片段。
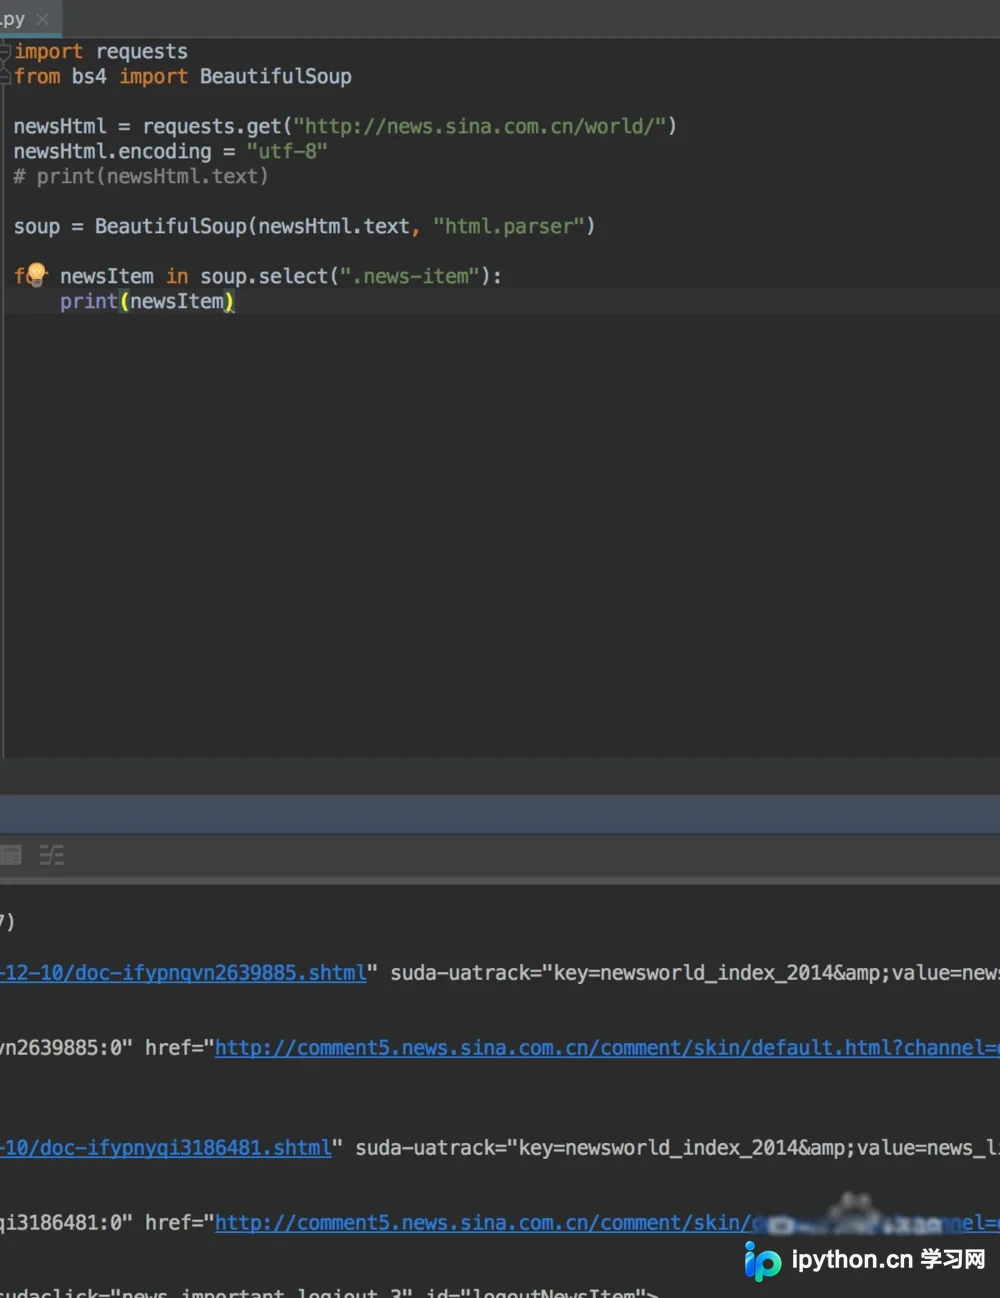
为了获取新闻的具体标题、发布时间及原文链接,需要对HTML元素进行更深入的解析。沿用之前的方法,在浏览器开发者工具中逐个查找标题、时间戳和链接所对应的具体标签及其属性特征。
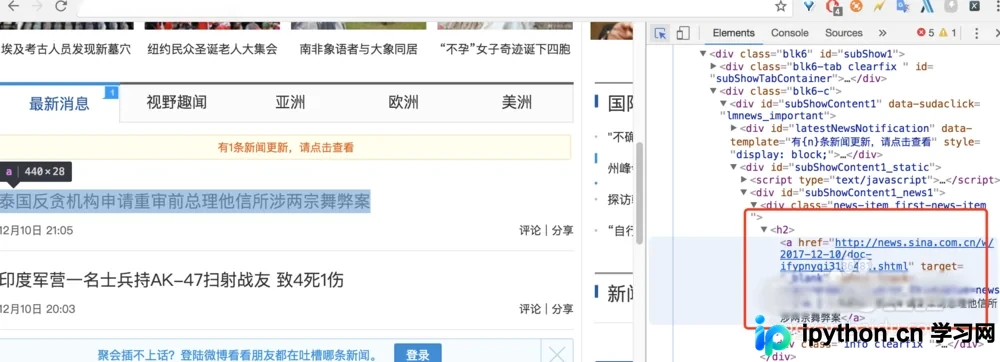
基于对标签结构的分析,编写相应的Python解析代码。利用bs4的查找方法(如find或find_all),提取标题、时间和地址字段,从而完成对新浪新闻关键信息的自动化爬取。
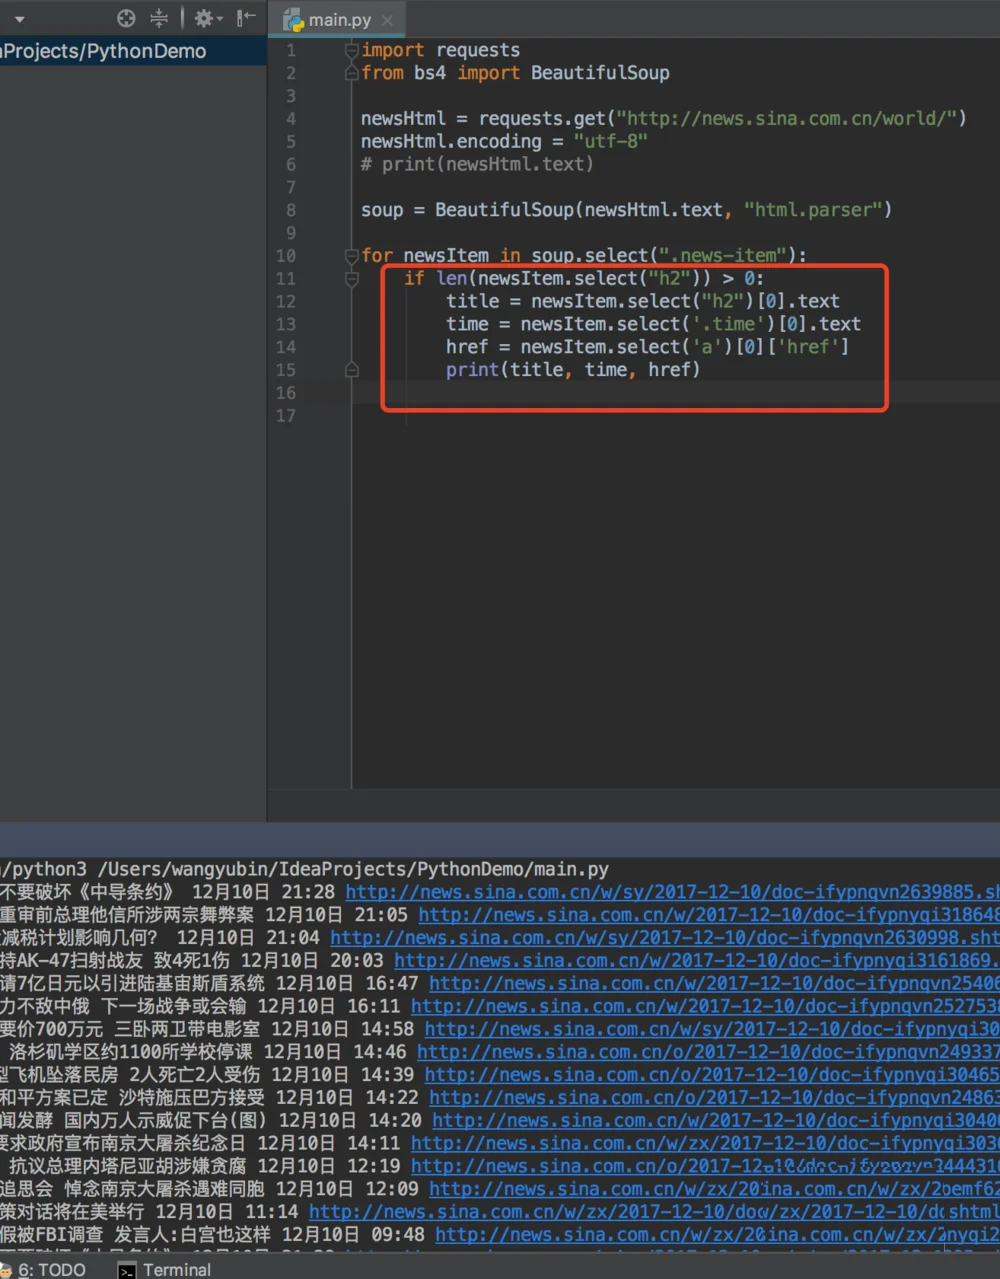
至此,一个基础的Python新闻爬虫示例已讲解完毕。该流程涵盖了从环境配置、请求发送、编码处理到数据解析的完整环节,可作为进一步开发复杂爬虫的基础。
总结:本文系统梳理了使用Python获取新浪新闻内容的完整步骤,包括库的安装、请求处理、乱码解决及数据解析。感谢读者的阅读与支持,希望本教程对您的爬虫开发有所帮助。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















