


Python 3.x 实现基于 XML 数据的 HTTP 请求与多线程压力测试

本文介绍如何使用 Python 3.x 编写基于 XML 数据的 HTTP 请求脚本,适用于 B/S 架构下的 WEB 服务通信测试。文章详细讲解了利用 urllib.request 发起请求、多线程并发处理、类与方法定义等核心技术,并提供了包含配置文件和源码的完整示例,旨在帮助开发者快速实现功能验证及初步的压力测试。
1. 前言
鉴于公司某项目采用 B/S 架构并与 WEB 服务进行通信,且通信数据格式为 XML。在新功能开发阶段,WEB 端与客户端由不同部门独立负责,因此 WEB 端在实现功能时,需自行发起请求以进行测试。为此,本文选用 Python 编写了相应的测试脚本。此外,考虑到该脚本未来可能扩展为具备压力测试功能,因此在基础访问功能之外,还引入了多线程请求机制。
该脚本主要涉及以下 Python 相关知识点:
基于 urllib.request 的 HTTP 访问
多线程技术
类与方法的定义
全局变量的定义与使用
文件的读取与写入操作
……
2. 源码与结果
整个程序由 Python 源码和配置文件组成。由于源码中已包含详细注释,此处直接展示源码内容,如下所示:
# TradeWeb测试脚本
import threading, time, http.client, urllib.request, os
#import matplotlib.pyplot as plt

URL = 'http://127.0.0.1:8888/XXXXXXXXX/httpXmlServlet' # 在配置文件中读取,此处将无效

TOTAL = 0; # 总数
SUCC = 0; # 响应成功数量
FAIL = 0; # 响应失败数量
EXCEPT = 0 # 响应异常数
MAXTIME = 0 # 最大响应时间
MINTIME = 100 # 最小响应时间,初始值为100秒
COUNT_TIME = 0 # 总时间
THREAD_COUNT = 0 # 记录线程数量
CODE_MAP = {200:0, 301:0, 302:0, 304:0} # 状态码信息(部分)
RESULT_FILE = 'tradeWebResult.xml'  # 输出结果文件
REQUEST_DATA_FILE = 'requestData.config'  # 数据文件

DATA = '''请在tradeWebRequestData.config文件中配置'''

TIME_LIST = [] # 记录访问时间

#创建一个threading.Thread的派生类
class RequestThread(threading.Thread):
 #构造函数
 def __init__(self, thread_name):
 threading.Thread.__init__(self)
 self.test_count = 0;

 #线程运行的入口函数
 def run(self):
 global THREAD_COUNT
 THREAD_COUNT += 1
 #print("Start the count of thread:%d" %(THREAD_COUNT))
 self.testPerformace()

 #测试性能方法
 def testPerformace(self):
 global TOTAL
 global SUCC
 global FAIL
 global EXCEPT
 global DATA
 global COUNT_TIME
 global CODE_MAP
 global URL
 try:
  st = time.time() #记录开始时间

  start_time
  cookies = urllib.request.HTTPCookieProcessor()
  opener = urllib.request.build_opener(cookies)

  resp = urllib.request.Request(url=URL,
     headers={'Content-Type':'text/xml', 'Connection':'Keep-Alive'},
     data=DATA.encode('gbk'))

  respResult = opener.open(resp)

  # 记录状态码 START
  code = respResult.getcode()
  if code == 200:
  SUCC += 1
  else:
  FAIL += 1

  if code in CODE_MAP.keys():
  CODE_MAP[code] += 1
  else:
  CODE_MAP[code] = 1

  # print(request.status)
  # 记录状态码 END

  html = respResult.read().decode('gbk')
  print(html)

  time_span = time.time() - st # 计算访问时间

  # 记录访问时间
  TIME_LIST.append(round(time_span * 1000))

  # print('%-13s: %f ' %(self.name, time_span))

  self.maxtime(time_span)
  self.mintime(time_span)

  self.writeToFile(html)

  # info = respResult.info() # 响应头信息
  # url = respResult.geturl() # URL地址
  # print(info);
  # print(url)

  COUNT_TIME += time_span
  TOTAL += 1
 except Exception as e:
  print(e)
  TOTAL += 1
  EXCEPT += 1

 # 设置最大时间,如果传入的时间大于当前最大时间
 def maxtime(self, ts):
 global MAXTIME
 #print("time:%f" %(ts))
 if ts > MAXTIME:
  MAXTIME = ts

 # 设置最小时间,如果传入的时间小于当前最小时间
 def mintime(self, ts):
 global MINTIME
 #print("time:%f" %(ts))
 if ts < MINTIME and ts > 0.000000000000000001:
  MINTIME = ts

 # 写入文件
 def writeToFile(self, html):
 f = open(RESULT_FILE, 'w')
 f.write(html)
 f.write('\r\n')
 f.close();

# 读取XML数据信息
def loadData():
 global URL
 global DATA

 f = open(REQUEST_DATA_FILE, 'r')
 URL = "".join(f.readline())
 DATA = "".join(f.readlines())

 # print(DATA)

 f.close()


if __name__ == "__main__":
 # print("============测试开始============")
 print("")
 # 开始时间
 start_time = time.time()
 # 并发的线程数
 thread_count = 1

 loadData() # 加载请求数据

 i = 0
 while i < thread_count:
 t = RequestThread("Thread" + str(i))
 t.start()
 i += 1

 t = 0
 while TOTAL < thread_count and t < 60:
 # print("total:%d, succ:%d, fail:%d, except:%d\n" %(TOTAL,SUCC,FAIL,EXCEPT))
 print("正在请求 ",URL)
 t += 1
 time.sleep(1)

 # 打印信息
 print()
 print("请求", URL, "的统计信息:")
 print(" 总请求数 = %d,成功 = %d,失败 = %d,异常 = %d" %(TOTAL, SUCC, FAIL, EXCEPT))
 print()
 print("往返程的估计时间(以毫秒为单位):")
 print(" 合计 =", int(COUNT_TIME * 1000), "ms", end = '')
 print(" 最大 =", round(MAXTIME * 1000), "ms", end = '')
 print(" 最小 =", round(MINTIME * 1000), "ms", end = '')
 print(" 平均 =", round((COUNT_TIME / thread_count) * 1000), "ms")
 print()
 print("响应的状态码与次数信息(状态码:次数):")
 print(" ", CODE_MAP)
 print()
 print("输出页面请查看", RESULT_FILE, "文件(建议使用浏览器或XML专业工具打开)")
 print()
 # os.system("pause")

 print(TIME_LIST)
 input()
配置文件主要用于方便地修改访问路径等参数,其中 SESSION_ID 是通过 Fiddler 抓包获取的。配置文件源文件如下(为保护公司隐私,数据已做模糊处理,但格式与原始数据一致):
http://127.0.0.1:8888/XXXXXXXXX/httpXmlServlet

<?xml version=“1.0” encoding = “GB2312”?>
<COM>
<REQ name="commodity_query">
<USER_ID>0001</USER_ID>
<COMMODITY_ID>0000</COMMODITY_ID>
<SESSION_ID>4918081208706966071</SESSION_ID>
</REQ>
</COM>
测试结果如下所示:
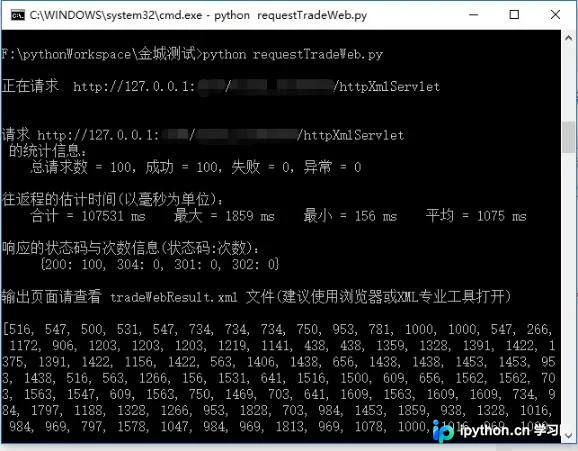
出于公司保密要求,地址信息已做模糊处理,此外输出的 tradeWebResult.xml 结果页面也未在此展示。
以上内容仅为个人在学习和使用 Python 过程中的记录,程序设计中可能存在不当之处,如有更好的建议,欢迎指正。
注:此代码的开发环境为 Python 3.5 + Windows,未在 Python 2.x 环境下进行测试。
以上这篇 Python 3.x 基于 XML 数据的 HTTP 请求方法就是小编分享给大家的全部内容了,希望能给大家一个参考,也希望大家多多支持本站。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















