



用 ctypes 调 C 函数时,字符串参数看起来最简单,实际却最容易在 Python 3 里踩坑:C 端写的是 char *,Python 里顺手传一个 str,马上就会报 ArgumentError: wrong type。问题不在共享库本身,而在于 ctypes 对参数类型的匹配非常严格:c_char_p 要的是字节串,不是 Unicode 字符串。下面就按“为什么会错、正确写法是什么、哪些情况该换成宽字符”的顺序梳理,方便你在看到函数声明时直接判断该传 bytes 还是 str。
为什么直接传 str 会报错
当你为函数声明参数类型:
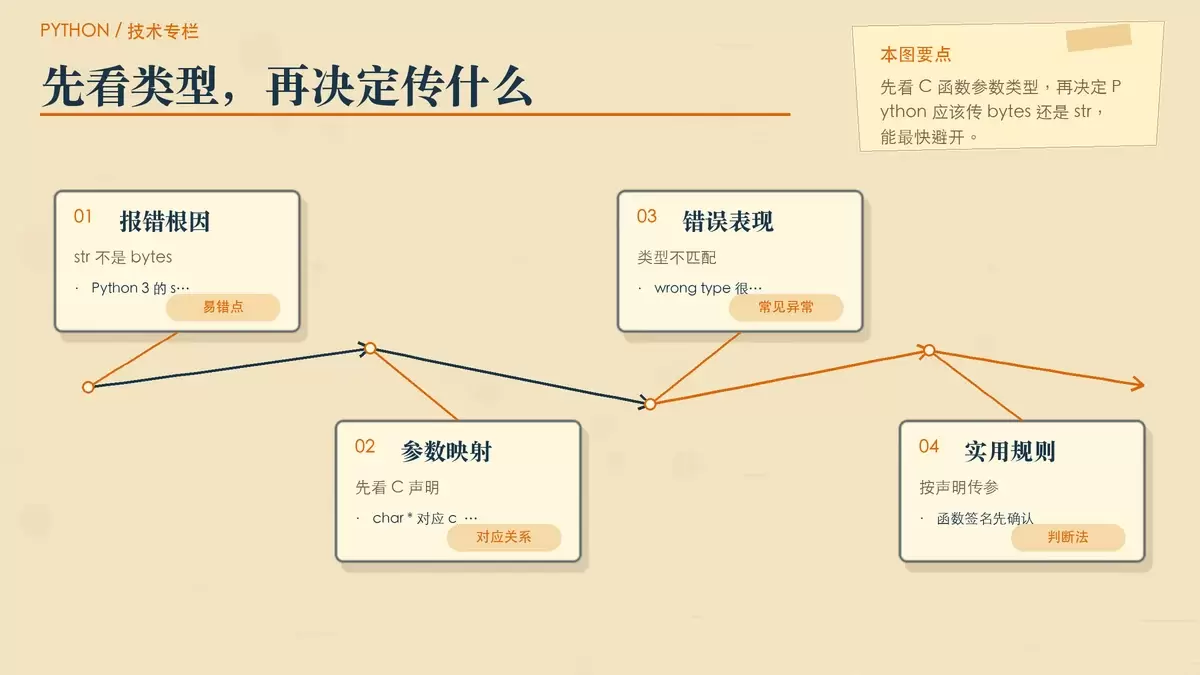
hello.argtypes = [ctypes.c_char_p]ctypes 的意思就已经很明确了:这个位置要接收一个 C 风格字符串指针,也就是指向以 \0 结尾的字节序列。对应到 Python 3,最合适的类型是 bytes,而不是默认的 str。
因此,像下面这种写法会触发类型错误:
hello("Test")原因不是内容有问题,而是类型不匹配。Python 3 的 "Test" 是 Unicode 字符串,c_char_p 却期望原始字节数据,所以常见报错会是:
ctypes.ArgumentError: argument 1: <class 'TypeError'>: wrong type可以把它记成一条最实用的对应关系:
c_char_p  <->  bytes
c_wchar_p <->  str
正确写法:显式传入 bytes
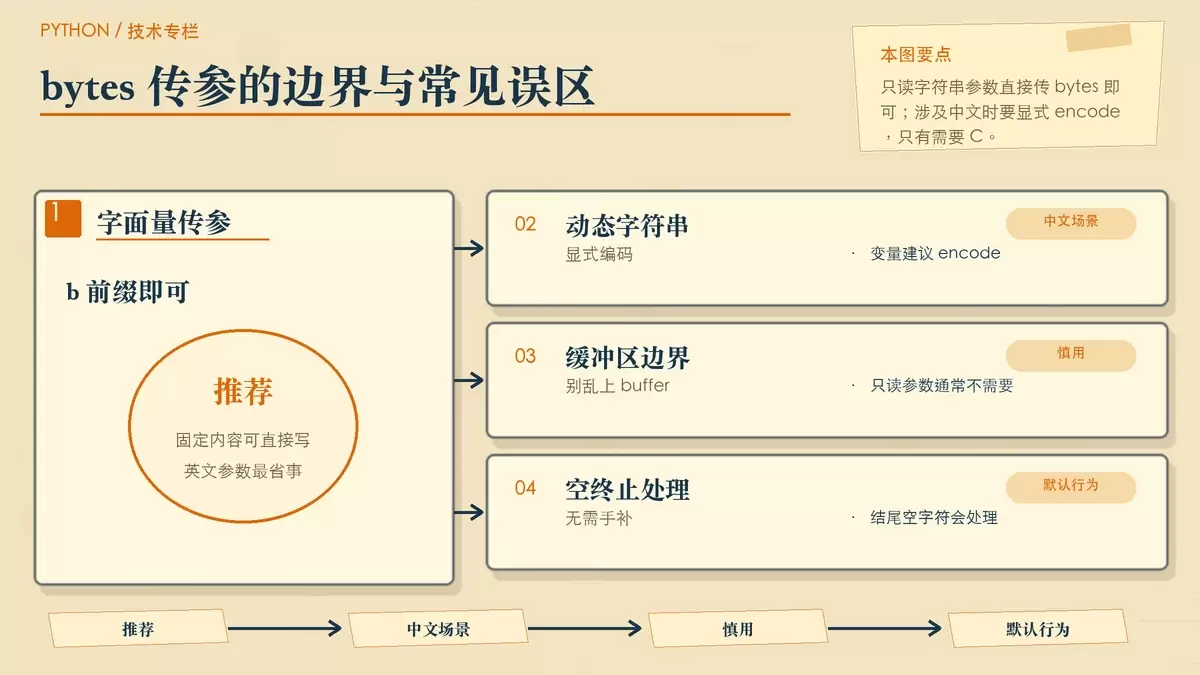
如果 C 函数参数就是普通的 char *,最直接的做法就是把 Python 字符串显式转成字节串。静态字面量可以直接写成 b"...",动态内容则用 .encode()。
import ctypes

lib = ctypes.cdll.LoadLibrary('./test.so')
hello = lib.hello
hello.argtypes = [ctypes.c_char_p]
hello.restype = None# 明确声明返回类型(void)

# ✅ 正确:传入 bytes 对象
hello(b"Test")# 输出: Hello

# ✅ 等价写法(推荐用于动态字符串)
name = "张三"
hello(name.encode('utf-8'))# 确保编码与C端预期一致(通常为UTF-8或ASCII)
这里有两个判断标准很重要。
固定内容用 b 前缀
如果传入的是固定英文内容,b"Test" 这种写法最直接,也最不容易引入额外编码问题。
动态字符串用 encode()
只要字符串来自变量、用户输入或包含中文,优先使用:
name.encode('utf-8')这样可读性更好,也能明确告诉后续维护者:这里是在把 Python 的 Unicode 文本转换成 C 端可接受的字节序列。
几个容易混淆的细节
除了“别把 str 直接传给 c_char_p”之外,实际使用中还有几个常见误区。
1. 不要把 str 当成 char *
这一点最常见,也最容易忽略。哪怕内容只是 ASCII,Python 里的 str 依旧不是 bytes,类型层面照样不匹配。
2. 不要误用 create_string_buffer
create_string_buffer 适用于“需要一块可变字符缓冲区,由 C 端写回内容”的场景。若你的函数只是读取传入的字符串,比如 void hello(char *name) 这种只读参数,直接传 bytes 就够了。
另外,库路径和函数参数不要混在一起。像 lib_name 这类 SO 文件路径,是传给 LoadLibrary() 的,不应该编码后再传给 hello()。这是两个完全不同的参数用途。
3. 编码要和 C 端约定一致
如果只传英文,很多时候你不会立刻感觉到编码差异;一旦传中文或其他非 ASCII 字符,编码是否一致就会直接影响结果。Python 端如果写的是:
name.encode('utf-8')那 C 端就要按 UTF-8 的方式理解这段字节数据。否则即便类型通过,内容也可能乱码或解析错误。
4. 一般不需要手动补空终止
把 bytes 传给 c_char_p 时,ctypes 会按 C 风格字符串的要求处理结尾的空字符,你通常不用自己再拼一个 \0。这类手动处理往往只会让代码更乱,不能带来额外收益。
什么时候该改用 c_wchar_p
如果 C 函数本身就不是接收 char *,而是宽字符版本,例如:
// shared.c(需重新编译)
#include <stdio.h>
void hello(wchar_t *name) {
// 注意:需链接 -lstdc++ 或使用wprintf等宽字符IO
printf("Hello (wide)n");
}
那 Python 端的声明也要一起改成:
# Python端
hello.argtypes = [ctypes.c_wchar_p]
hello("Test")# ✅ 此时str可直接传递
这时候直接传 str 才是正确用法,因为 c_wchar_p 对应的就是宽字符字符串。
不过,这条路虽然能让 str 直接传递,代价是 C 端实现和平台兼容性会更复杂。不同平台上 wchar_t 的宽度、宽字符 I/O 行为以及库实现细节并不完全一致,所以跨平台调用时,宽字符方案通常不如 UTF-8 字节串稳妥。
如果没有明确理由要求宽字符接口,实践中仍然建议优先选择:
char * + bytes
utf-8 encode
这也是大多数 Python 与 C 混合调用场景里更通用、更省心的方案。
实用记忆法:先看 C 声明,再决定 Python 传参
判断是否会踩坑,其实只要先看 C 函数签名。
- 如果参数是
char *,Python 端就按c_char_p处理,并传bytes; - 如果参数是
wchar_t *,Python 端就按c_wchar_p处理,并传str。
归根结底,ctypes 的关键不是“字符串长什么样”,而是“底层内存表示是否和 C 函数声明一致”。把这层关系理顺,ArgumentError: wrong type 这类问题基本就能一次避开。















