



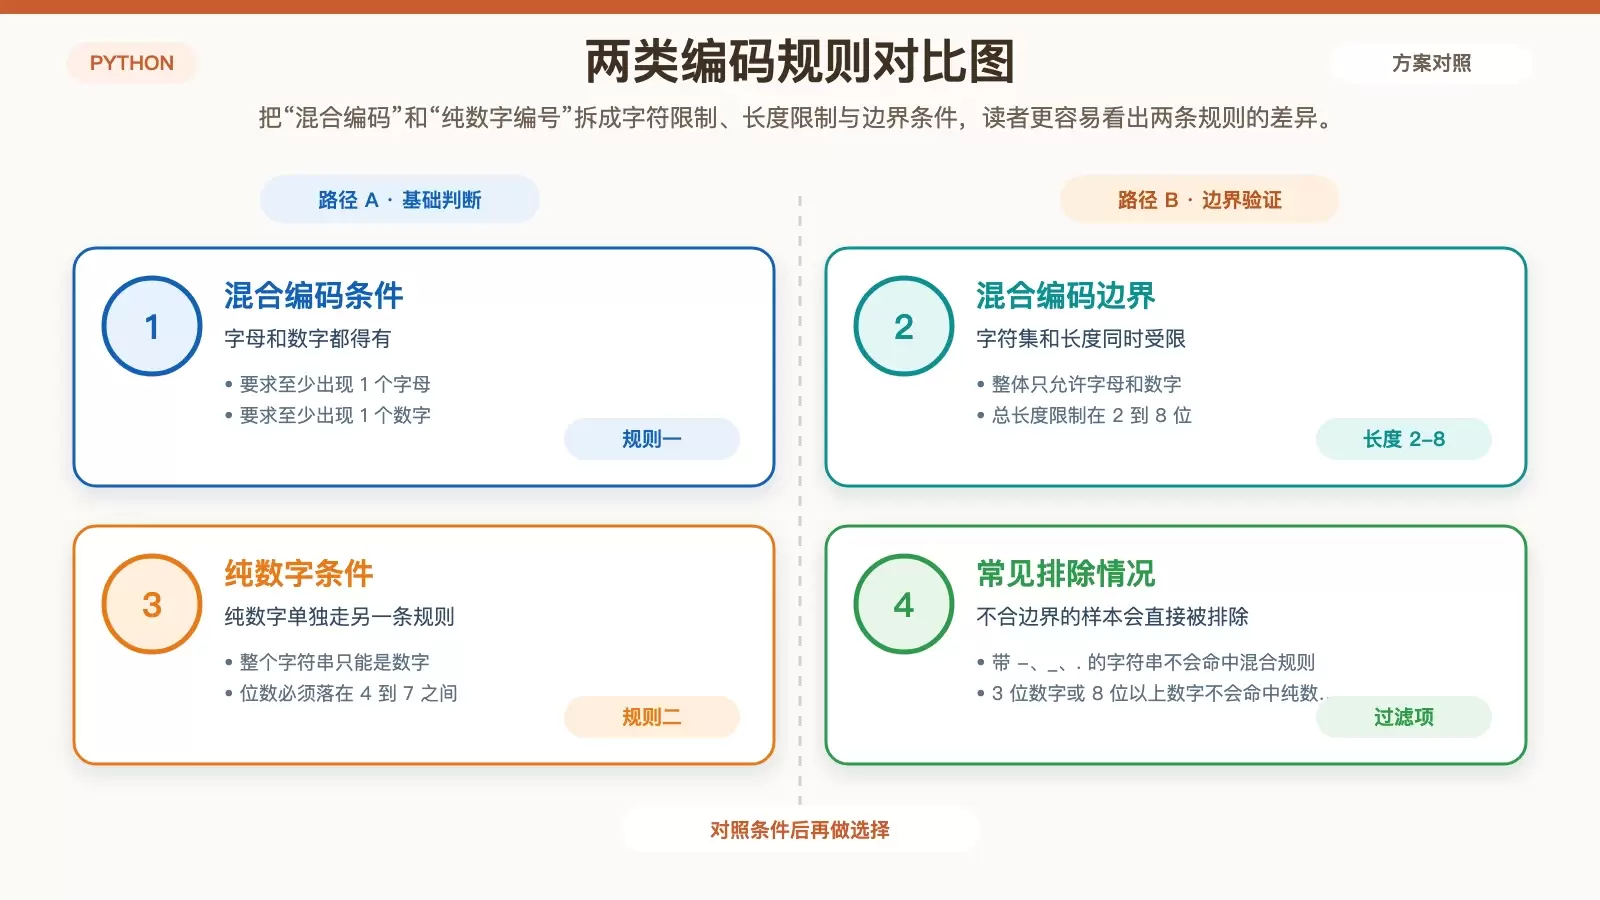
在日志清洗、OCR 结果整理、物料号提取这类场景里,最常见的问题不是“能不能匹配到”,而是“怎样把误匹配压下去”。这篇示例围绕两条很实用的规则展开:一类是长度 2 到 8 位、只含字母和数字且必须同时包含两者的混合编码;另一类是长度 4 到 7 位的纯数字编号。你可以直接照着代码运行,也能根据后面的规则拆解和样本分析,判断自己的数据该改哪一段正则。
完整可运行源码
先看完整代码。原文的正则写法里使用了 d,按 Python 正则语法这里应为 \d 才表示数字;否则会把字母 d 当作普通字符处理。下面保留原有结构,只把这一处语义按示例目标整理为可运行版本。
import re

def process_string(input_string):
    """
    从输入文本中筛选符合规则的单词片段
    匹配规则二选一:
    1. 同时包含字母+数字,仅由字母数字构成,长度2~8位
    2. 纯数字,总位数4~7位
    :param input_string: 输入带空格分隔的文本
    :return: 所有符合规则的字符串列表
    """
    result_list = []
    # 按空格切割文本,拆分出独立单词
    word_parts = input_string.split()

    # 正则1:匹配字母+数字混合编码,长度2~8,无特殊符号
    pattern_mix = re.compile(r'(?=.*[a-zA-Z])(?=.*\d)[a-zA-Z\d]{2,8}$')
    # 正则2:匹配4~7位纯数字
    pattern_num = re.compile(r'^\d{4,7}$')

    # 遍历每一个拆分后的单词,校验规则
    for word in word_parts:
        if pattern_mix.match(word) or pattern_num.match(word):
            result_list.append(word)
    return result_list

# 测试样本集
test_texts = [
    'Aceite p04476',
    'sdighsg',
    's4967xl',
    'v0-4985',
    'shfsf v0-4985',
    '123',
    '1234568956',
    '45825'
]

# 批量提取所有符合规则的编码
total_result = []
for text in test_texts:
    match_words = process_string(text)
    total_result.extend(match_words)

# 输出最终筛选结果
print("所有匹配成功的编码:", total_result)
这段代码到底在做什么
先按空格拆分,再逐个单词校验
process_string() 的核心思路很直接:先用 split() 把整段文本按空格拆开,再对每个单词分别做正则判断。这样做的好处是逻辑清晰,尤其适合处理“句子里夹着几个编码”的文本。
- 文本分割:
input_string.split()会把一句话拆成多个独立片段。 - 双规则并行:只要满足“混合编码”或“纯数字编号”任意一条,就会被收集。
- 返回列表:函数最终返回所有命中的编码,而不是只返回第一个。
批量测试怎么汇总结果
示例里又在外层准备了一个 test_texts 列表,用来模拟多段待检测文本。每次调用 process_string() 后,再用 extend() 把本次命中的结果合并到总列表里,最后统一输出。
这种写法的价值在于:当你处理日志、表单导出、OCR 文本批量校验时,可以很容易把“单条规则判断”扩展到“多条文本批处理”。
两条正则规则怎么理解
规则一:匹配字母数字混合编码
第一条规则如下:
r'(?=.*[a-zA-Z])(?=.*\d)[a-zA-Z\d]{2,8}$'
它用于匹配“同时包含字母和数字、整体只由字母数字构成、长度在 2 到 8 位之间”的编码。
| 正则片段 | 作用说明 |
|---|---|
(?=.*[a-zA-Z]) | 正向预查,要求字符串里至少出现 1 个字母 |
(?=.*\d) | 正向预查,要求字符串里至少出现 1 个数字 |
[a-zA-Z\d]{2,8} | 整段内容只能由字母和数字构成,总长度限定为 2 到 8 位 |
$ | 限制匹配到字符串末尾,避免多余字符混入结果 |
这里最关键的约束有两个:一是“必须同时有字母和数字”,二是“不能出现连字符、下划线、点号这类特殊符号”。所以像 v0-4985 这种带 - 的字符串会被直接过滤。
规则二:匹配 4 到 7 位纯数字编号
第二条规则如下:
r'^\d{4,7}$'
它专门用于匹配纯数字编号,要求整个字符串只能是数字,且长度必须在 4 到 7 位之间。
| 正则片段 | 作用说明 |
|---|---|
^ | 从字符串开头开始匹配 |
\d{4,7} | 只能是数字,位数最少 4 位、最多 7 位 |
$ | 匹配到字符串结尾,确保是完整编号 |
边界很明确:3 位数字不会通过,8 位及以上数字同样不会通过。
测试样本为什么有的通过、有的被过滤
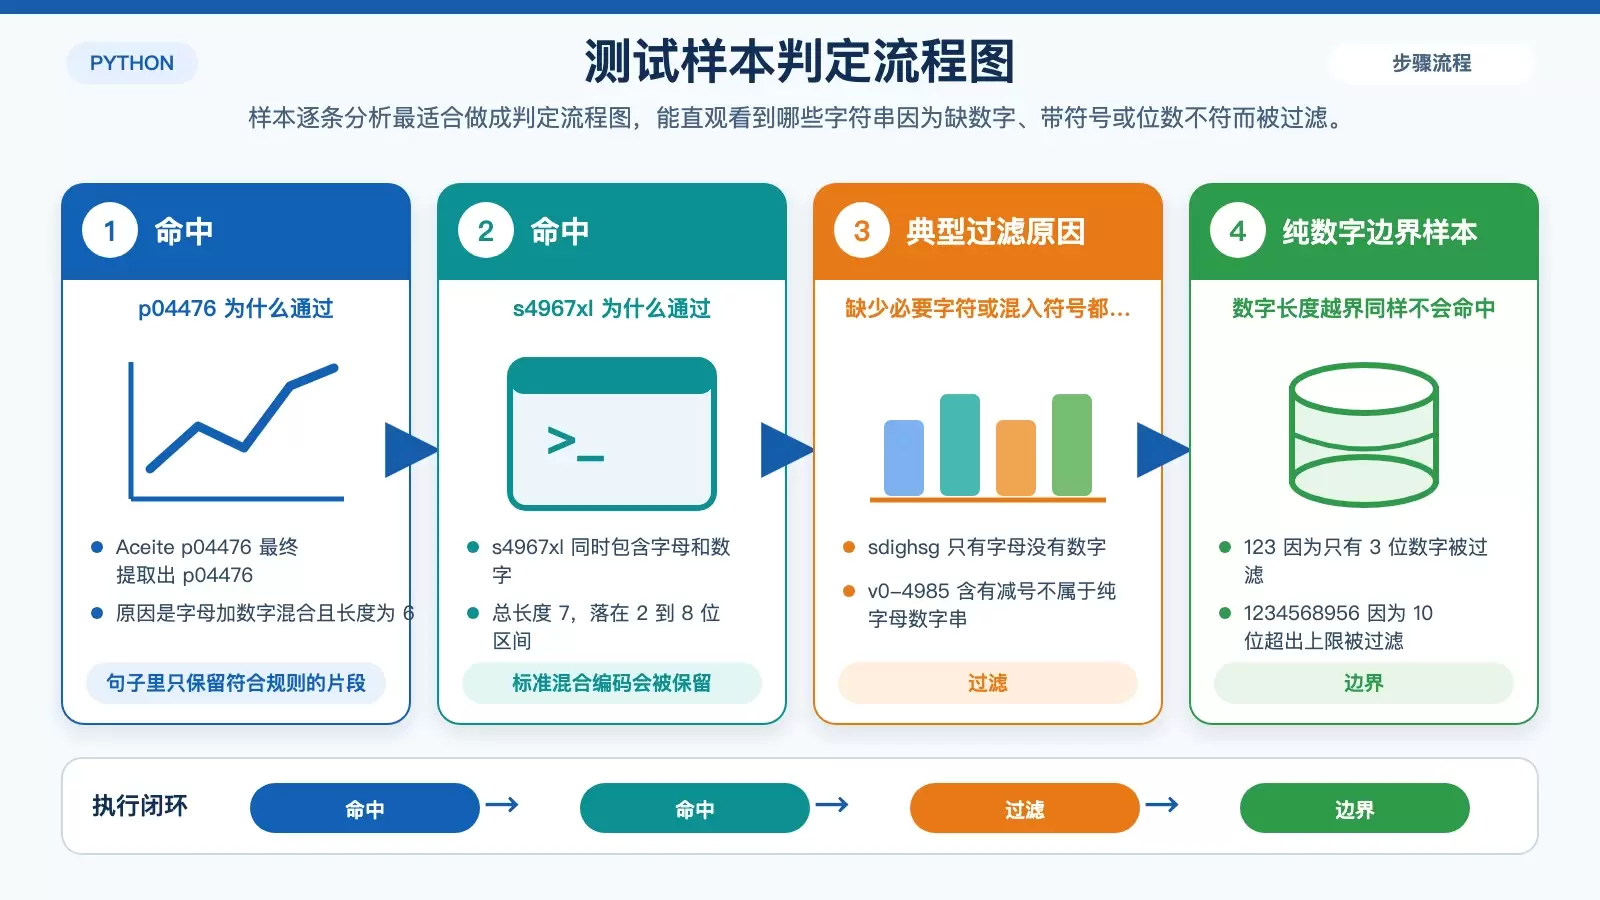
原文提供的样本基本覆盖了常见情况:纯字母、字母数字混合、带特殊符号、位数不达标、位数超限。逐个看更容易理解规则边界。
| 测试文本 | 拆分单词 | 是否匹配 | 匹配原因 / 过滤原因 |
|---|---|---|---|
| Aceite p04476 | Aceite、p04476 | p04476 ✅ | 字母 + 数字混合,长度 6,符合规则一 |
| sdighsg | sdighsg | ❌ | 只有字母,没有数字 |
| s4967xl | s4967xl | ✅ | 字母数字混合,长度 7,符合规则一 |
| v0-4985 | v0-4985 | ❌ | 包含特殊符号 -,不属于纯字母数字串 |
| shfsf v0-4985 | shfsf、v0-4985 | ❌ | 前者只有字母,后者包含减号,两个都不满足条件 |
| 123 | 123 | ❌ | 纯数字但只有 3 位,低于 4 位下限 |
| 1234568956 | 1234568956 | ❌ | 纯数字但长度 10 位,超出 7 位上限 |
| 45825 | 45825 | ✅ | 纯数字 5 位,落在 4 到 7 位区间内,符合规则二 |
程序运行输出
按照上面的规则,最终筛选结果如下:
所有匹配成功的编码: ['p04476', 's4967xl', '45825']
这个输出也正好对应了前面的样本分析:两个混合编码,加上一个 5 位纯数字编号。
需要扩展规则时可以怎么改
支持带横杠的编码
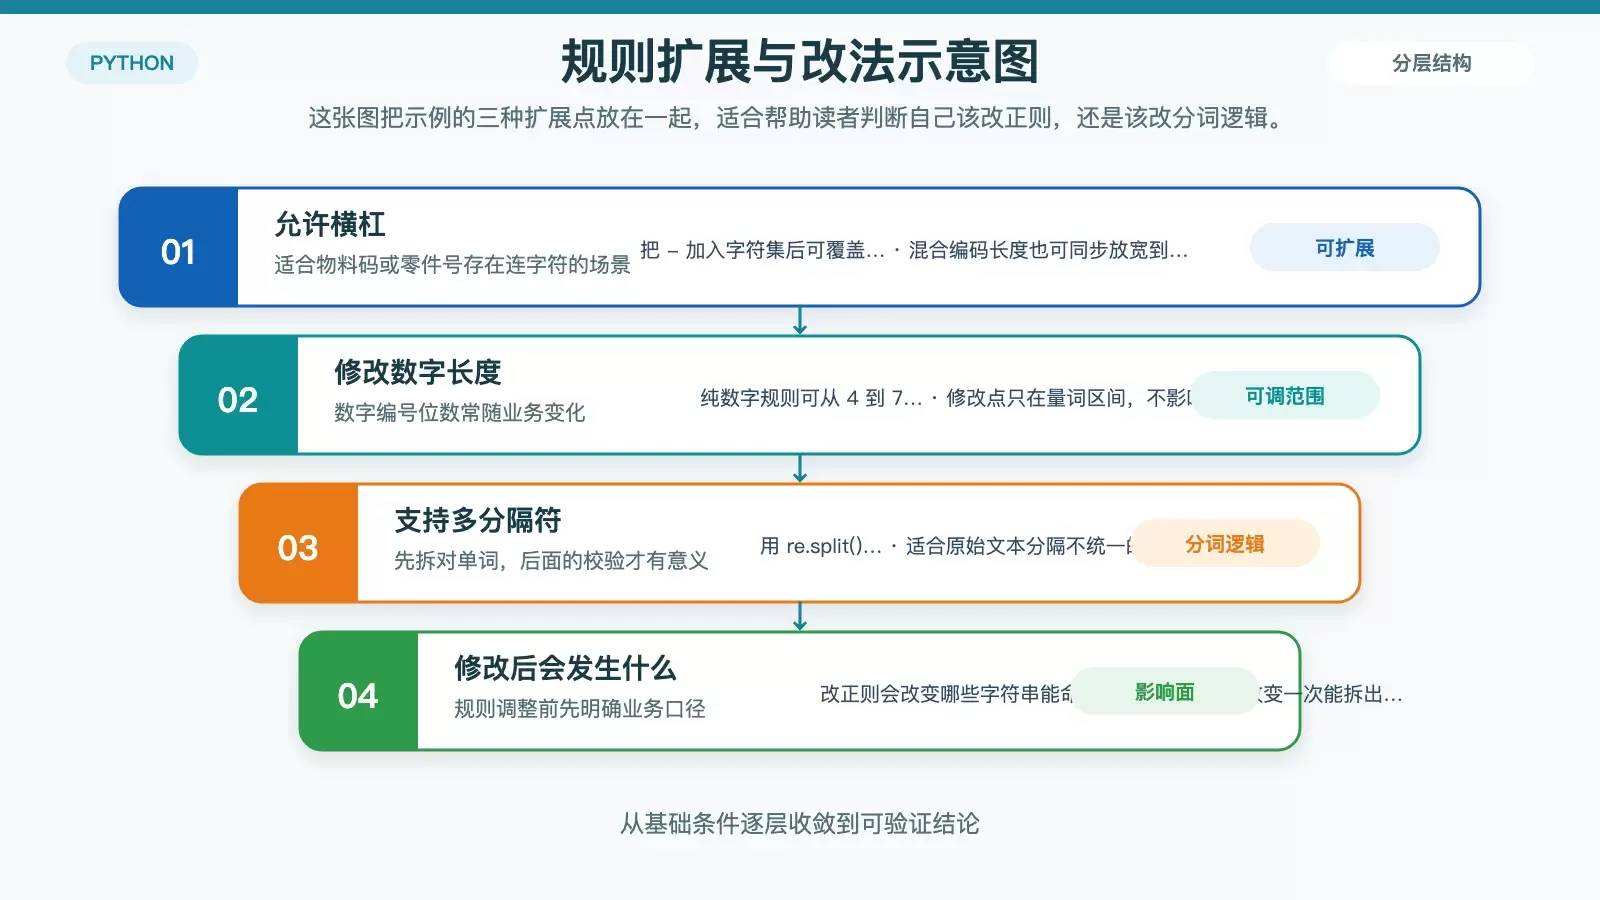
如果你的编码像 v0-4985 这样允许带 -,就可以把连字符加入字符集。原文给出的修改方式如下:
pattern_mix = re.compile(r'(?=.*[a-zA-Z])(?=.*d)[a-zA-Zd-]{2,10}$')
如果按 Python 正则的数字写法整理,对应应写为:
pattern_mix = re.compile(r'(?=.*[a-zA-Z])(?=.*\d)[a-zA-Z\d-]{2,10}$')
修改纯数字长度范围
如果业务规则要求匹配 3 到 10 位纯数字,原文示例如下:
pattern_num = re.compile(r'^d{3,10}$')
同样按可运行写法整理后,应为:
pattern_num = re.compile(r'^\d{3,10}$')
兼容逗号或顿号等分隔符
当输入文本不只是空格分词,而是可能混有逗号、空格等分隔符时,可以把 split() 换成 re.split():
# 同时按空格、逗号分割
word_parts = re.split(r'[ ,]', input_string)
这样能让筛选逻辑更适合真实数据清洗,而不是只适配格式很整齐的样本。
适用场景与知识点总结
这类提取逻辑适合哪些场景
- 工业文本中的零件号、物料编码提取
- 日志文本里的设备编号、订单短号筛选
- OCR 识别结果中的有效编码过滤
- 表单原始文本的批量清洗与字段提取
最后记住这几个关键点
re.compile()适合预编译规则,重复调用时更方便也更高效。match()从字符串开头开始匹配,适合这类“校验整个单词”的场景。- 正向预查
(?=...)很适合表达“必须同时满足多个存在条件”。 split()和re.split()的选择,决定了你的输入能兼容哪些分隔形式。- 这类规则的核心不是正则写得多复杂,而是先把“允许什么、禁止什么、长度是多少”定清楚。















