


Python爬虫实战:从5行代码到爬取3000+上市公司数据

本文通过Python爬虫实战,展示如何从简单的5行代码逐步完善,最终实现爬取3000多家上市公司信息。文章涵盖环境配置、异常处理、灵活性优化及多进程加速等技巧,帮助初学者快速掌握爬虫开发流程。
前言
学习Python爬虫的门槛并不高,仅需几行代码即可实现数据抓取,这通常被视为掌握Python语言最便捷的切入点。
在编写爬虫的初期,建议将注意力集中在最核心的环节,即成功获取数据。至于下载速度、存储格式或代码结构等次要因素,可以暂时忽略。这种简短且易于理解的代码风格有助于降低入门难度,从而增强学习者的自信心。
基本环境配置
- Python3
- Windows
- pandas、csv
爬取目标网站
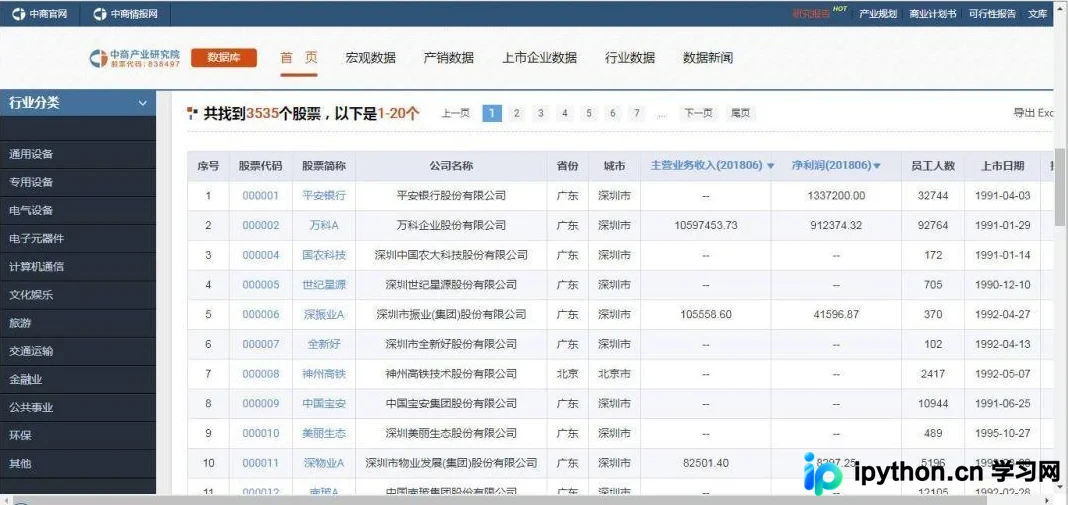
实现代码
import pandas as pdimport csvfor i in range(1,178): # 爬取全部页 tb = pd.read_html('http://s.askci.com/stock/a/?reportTime=2017-12-31&pageNum=%s' % (str(i)))[3] tb.to_csv(r'1.csv', mode='a', encoding='utf_8_sig', header=1, index=0)
超过3000家上市公司的详细信息,最终被整理并保存在Excel文件中。
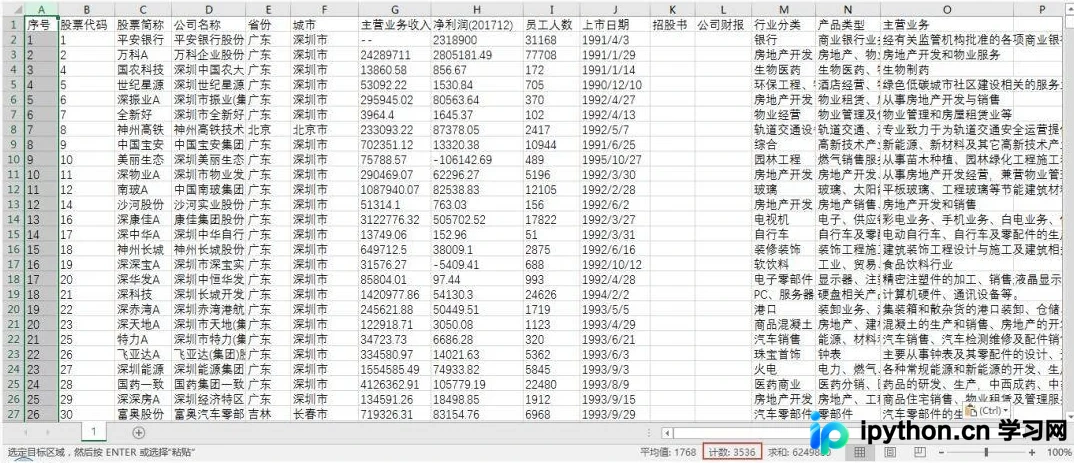
在建立了初步的信心后,我开始对代码进行优化和完善。由于最初的5行代码功能过于单一,我从以下几个维度进行了改进:
增加异常处理
在爬取上百页网页的过程中,可能会因各种网络或页面问题导致抓取中断。因此,我引入了try-except和if语句来处理潜在异常,从而提升代码的健壮性。
增加代码灵活性
初始版本的代码固定了URL参数,导致只能抓取特定内容。考虑到实际需求的多变性,通过修改URL请求参数,可以增强代码的灵活性,从而支持抓取更多样化的数据。
修改存储方式
虽然初版代码选择了最熟悉的Excel格式进行存储,但为了跳出舒适区并学习新技术,我将数据存储目标改为MySQL数据库,以此练习MySQL的使用。
加快爬取速度
初版代码采用单进程方式,爬取效率较低。鉴于网页数量庞大,我将其修改为多进程爬取模式,以显著提升抓取速度。
经过上述几项改进,代码规模从最初的5行扩展至几十行。
import requestsimport pandas as pdfrom bs4 import BeautifulSoupfrom lxml import etreeimport timeimport pymysqlfrom sqlalchemy import create_enginefrom urllib.parse import urlencode # 编码 URL 字符串start_time = time.time() #计算程序运行时间def get_one_page(i): try: headers = { 'User-Agent': 'Mozilla/5.0 (Windows NT 6.1; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/66.0.3359.181 Safari/537.36' } paras = { 'reportTime': '2017-12-31', #可以改报告日期,比如2018-6-30获得的就是该季度的信息 'pageNum': i #页码 } url = 'http://s.askci.com/stock/a/?' + urlencode(paras) response = requests.get(url,headers = headers) if response.status_code == 200: return response.text return None except RequestException: print('爬取失败')def parse_one_page(html): soup = BeautifulSoup(html,'lxml') content = soup.select('#myTable04')[0] #[0]将返回的list改为bs4类型 tbl = pd.read_html(content.prettify(),header = 0)[0] # prettify()优化代码,[0]从pd.read_html返回的list中提取出DataFrame tbl.rename(columns = {'序号':'serial_number', '股票代码':'stock_code', '股票简称':'stock_abbre', '公司名称':'company_name', '省份':'province', '城市':'city', '主营业务收入(201712)':'main_bussiness_income', '净利润(201712)':'net_profit', '员工人数':'employees', '上市日期':'listing_date', '招股书':'zhaogushu', '公司财报':'financial_report', '行业分类':'industry_classification', '产品类型':'industry_type', '主营业务':'main_business'},inplace = True) return tbldef generate_mysql(): conn = pymysql.connect( host='localhost', user='root', password='******', port=3306, charset = 'utf8', db = 'wade') cursor = conn.cursor() sql = 'CREATE TABLE IF NOT EXISTS listed_company (serial_number INT(20) NOT NULL,stock_code INT(20) ,stock_abbre VARCHAR(20) ,company_name VARCHAR(20) ,province VARCHAR(20) ,city VARCHAR(20) ,main_bussiness_income VARCHAR(20) ,net_profit VARCHAR(20) ,employees INT(20) ,listing_date DATETIME(0) ,zhaogushu VARCHAR(20) ,financial_report VARCHAR(20) , industry_classification VARCHAR(20) ,industry_type VARCHAR(100) ,main_business VARCHAR(200) ,PRIMARY KEY (serial_number))' cursor.execute(sql) conn.close()def write_to_sql(tbl, db = 'wade'): engine = create_engine('mysql+pymysql://root:******@localhost:3306/{0}?charset=utf8'.format(db)) try: tbl.to_sql('listed_company2',con = engine,if_exists='append',index=False) # append表示在原有表基础上增加,但该表要有表头 except Exception as e: print(e)def main(page): generate_mysql() for i in range(1,page): html = get_one_page(i) tbl = parse_one_page(html) write_to_sql(tbl)# # 单进程if __name__ == '__main__': main(178) endtime = time.time()-start_time print('程序运行了%.2f秒' %endtime)# 多进程from multiprocessing import Poolif __name__ == '__main__': pool = Pool(4) pool.map(main, [i for i in range(1,178)]) #共有178页 endtime = time.time()-start_time print('程序运行了%.2f秒' %(time.time()-start_time))
结语
这一优化过程显得十分自然,因为每次修改都针对一个具体小点,逐步学习并整合。如果一开始就要求直接写出这几十行代码,初学者很可能因此放弃。
由此可见,入门爬虫是有章可循的,关键在于通过小步快跑来建立自信心。
总结
以上就是本文的全部内容,希望这些内容能为您的学习或工作提供参考价值。感谢大家对本站的支持。如需了解更多相关信息,请查阅以下相关链接。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















