


Python调用Tesseract实现OCR图文识别:从环境配置到代码实战

本文详解利用Python结合Tesseract引擎进行图文识别(OCR)的完整流程。涵盖OCR技术简介、Tesseract在Windows下的安装与环境变量配置,重点解决语言包加载报错问题。通过具体命令与Python代码示例,演示如何调用pytesseract库识别中英文图像,并验证识别结果,为开发者提供实用的OCR落地方案。
什么是OCR?
简介
OCR即光学字符识别(Optical Character Recognition),该技术通过扫描等光学输入方式,将票据、报刊、书籍、文稿及其他印刷品的文字转化为图像信息,随后利用文字识别技术将图像信息转换为计算机可处理的文本数据。它广泛应用于银行票据、大量文字资料、档案卷宗及文案录入处理等领域,特别适合银行、税务等行业对大量票据表格进行自动扫描识别及长期存储。与一般文本处理不同,OCR技术的评测通常依据最终识别率、识别速度、版面理解正确率及版面还原满意度四个方面;而对于表格及票据,则主要以识别率或整张通过率及识别速度作为实用标准。
解析
应用OCR识别技术于银行票据光盘缩微系统,可自动提取票据要素,从而减轻操作员工作量,减少重复劳动。特别是在与银行事后监督系统结合后,能够替代人工完成事后监督工作。计算机可自动识别票据上的日期、账号、金额等要素,并与业务系统中的数据进行比对,完成传统的事后监督操作。若配备印章验证系统,还能自动将凭证图像中的印章与系统中预留的印鉴进行比对,实现印章真伪的自动识别。
OCR识别技术不仅能自动判断、拆分、识别和还原各种通用型印刷体表格,在表格理解方面取得了令人满意的实用成果,还能自动分析文稿的版面布局,实现自动分栏,并判断标题、横栏、图像、表格等属性及识别顺序,最终将识别结果还原为与扫描文稿版面布局一致的新文本。表格自动录入技术可自动识别特定表格中的印刷或打印汉字、字母、数字,甚至支持手写体汉字、字母、数字及多种手写符号,并按表格格式输出,显著提高了表格录入效率,节省大量人力。同时,该技术支持将表格识别结果直接还原为PTF、PDF、HTML等格式文档,并能对嵌入横排文本、竖排文本及表格文本进行自动排版分析。利用当前先进的OCR技术,可直接从凭证影像中提取金额、账号等重要数据,替代人工录入,并与条码识别/流水识别紧密结合,实现建立事后副本账、完成事后监督的工作。OCR处理通常使用性能较好的PC机,程序启动后会自动扫描数据库中的凭证影像,发现需OCR处理而未处理的影像时,提取至本地进行处理。
OCR手写体与印刷体识别技术能够识别不同人书写的千差万别的手写体汉字和数字。在本系统中,该技术用于识别凭证影像中储户填写的信息,如大写金额、小写金额、账号、存期、日期、证件号等,从而替代手工录入。此外,系统会将OCR识别得出的金额与流水识别所得的金额进行核对,若核对成功,则判定OCR识别成功。这种处理机制旨在避免误判。
通过对银行产生的实际凭证进行大量测试,在实际开发过程中,根据银行的实际需求,OCR技术在票据和表格识别能力以及手写体自动识别能力上不断提升。目前,处理速度可达每分钟60至80张票据,存折识别率已达到85%以上,存单、凭条的识别率达到90%以上。值得注意的是,85%以上的识别率即可减少80%以上的数据录入员工作量。
在档案领域,OCR技术使档案扫描成果达到全文可识别,将档案数字化发展提升到了一个新阶段,使原本扫描生成的图片更易于检索,为数字档案馆的数据查询提供了技术支持,成为档案数字化发展中不可或缺的一环。
以上内容参考自百度百科。
相关工具:Tesseract
Tesseract概述
Tesseract是一个OCR库,目前由Google赞助(Google是一家以OCR和机器学习技术闻名于世的公司)。Tesseract被公认为目前最优秀、最精确的开源OCR系统。
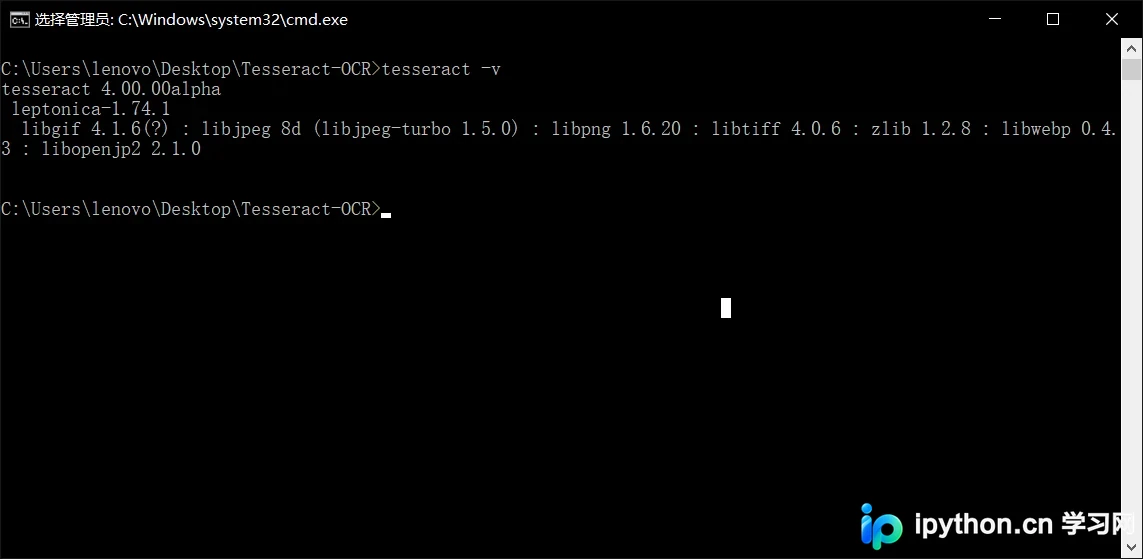
Tesseract的Windows安装包下载地址为:http://digi.bib.uni-mannheim.de/tesseract/tesseract-ocr-setup-4.00.00dev.exe,下载后双击直接安装即可。安装完成后,需要将Tesseract添加到系统环境变量中。在CMD中输入tesseract -v,若显示相应界面,则表示Tesseract安装完成且已成功添加到系统变量中。
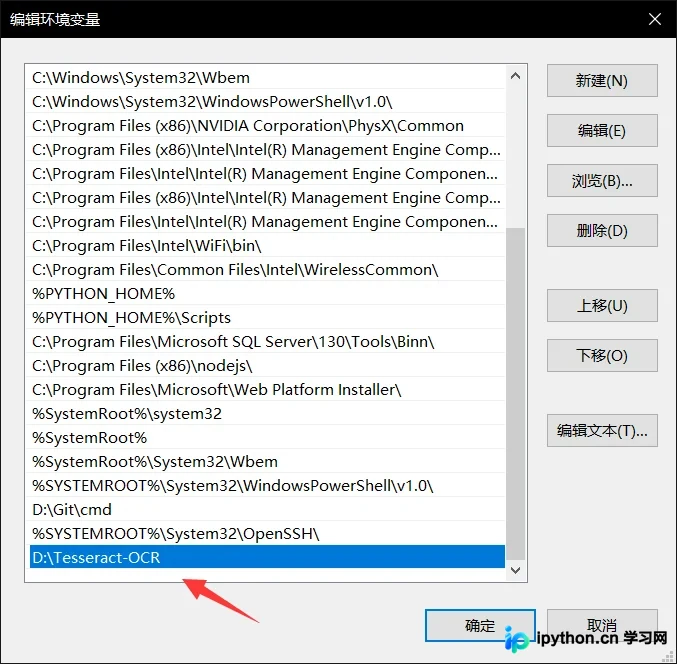
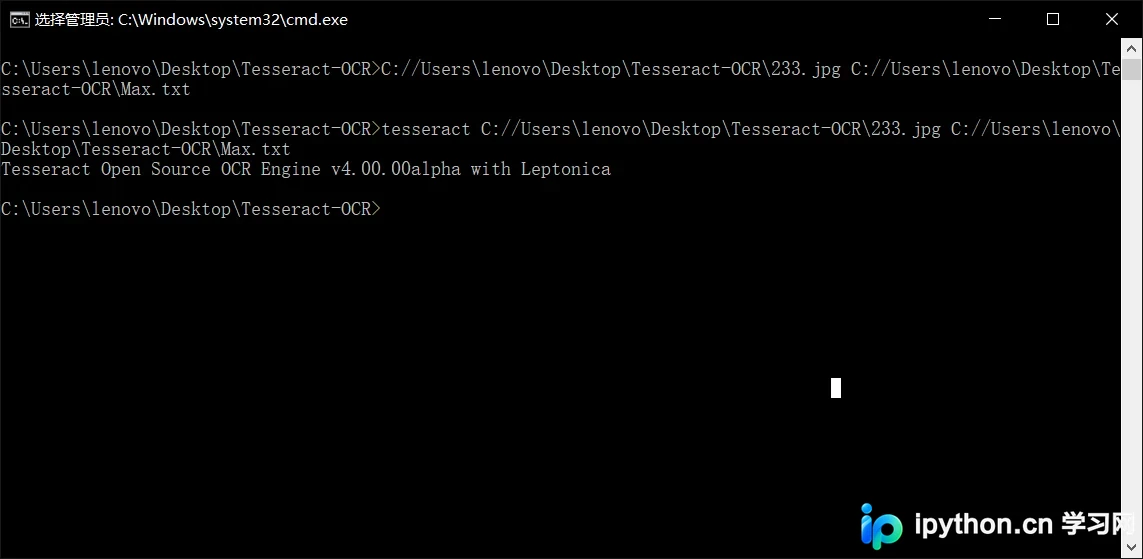
配置完成后,在命令行输入tesseract -v,若出现如下所示结果,说明环境变量配置成功。
命令使用示例:tesseract C://Users\lenovo\Desktop\Tesseract-OCR\233.jpg C://Users\lenovo\Desktop\Tesseract-OCR\Max.txt,该命令旨在将233.jpg中的识别文字写入到Max.txt文件中。若执行时报错,原因是什么?
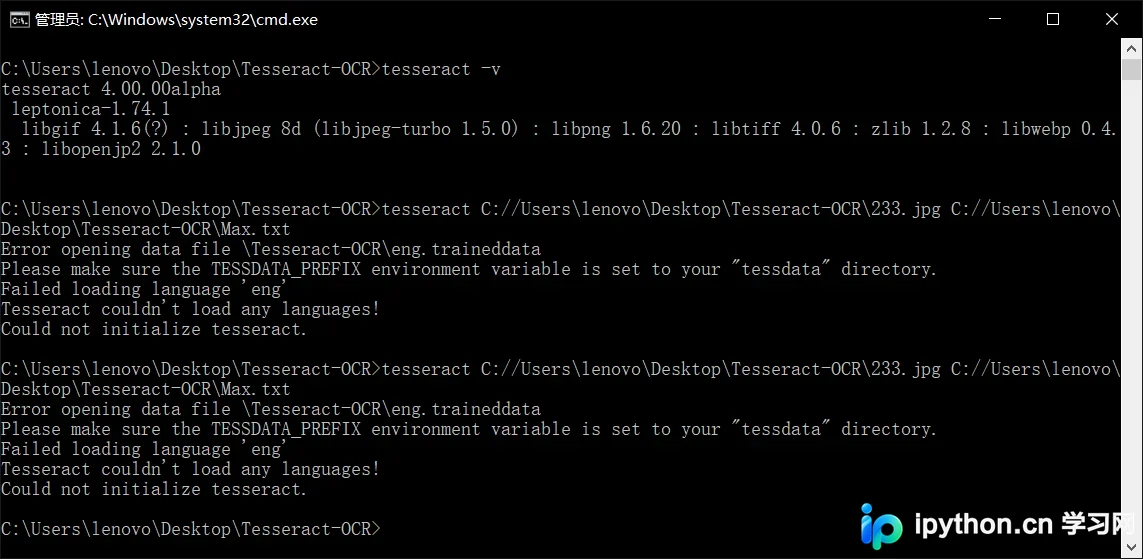
随后查阅相关资料得知,上述报错意味着无法加载'eng'语言包。解决方法是将tessdata文件夹的父目录路径设置为TESSDATA_PREFIX环境变量的值。具体操作为:在环境变量中新建一个系统变量,变量名称为TESSDATA_PREFIX。tessdata是存放语言包的文件夹,通常位于Tesseract的安装目录下,即tesseract的安装目录即为tessdata的父目录。将TESSDATA_PREFIX的值设置为该路径即可解决问题。
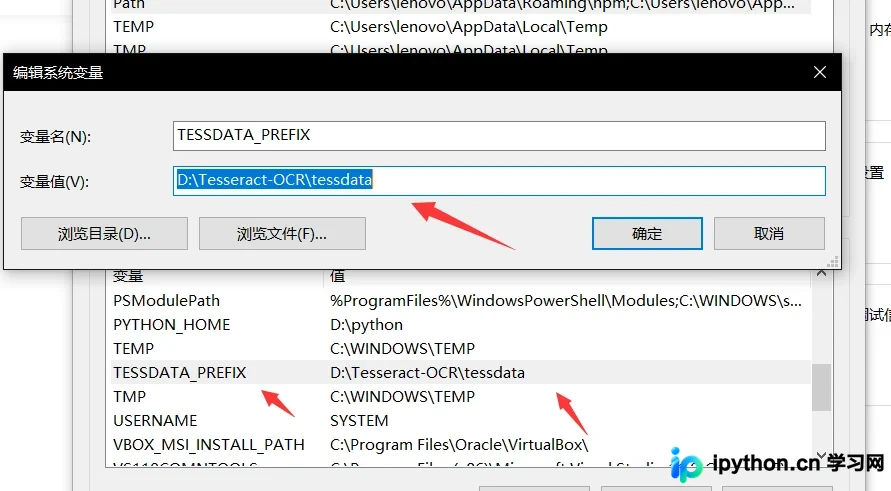
更改环境变量后,重启计算机即可正常运行。
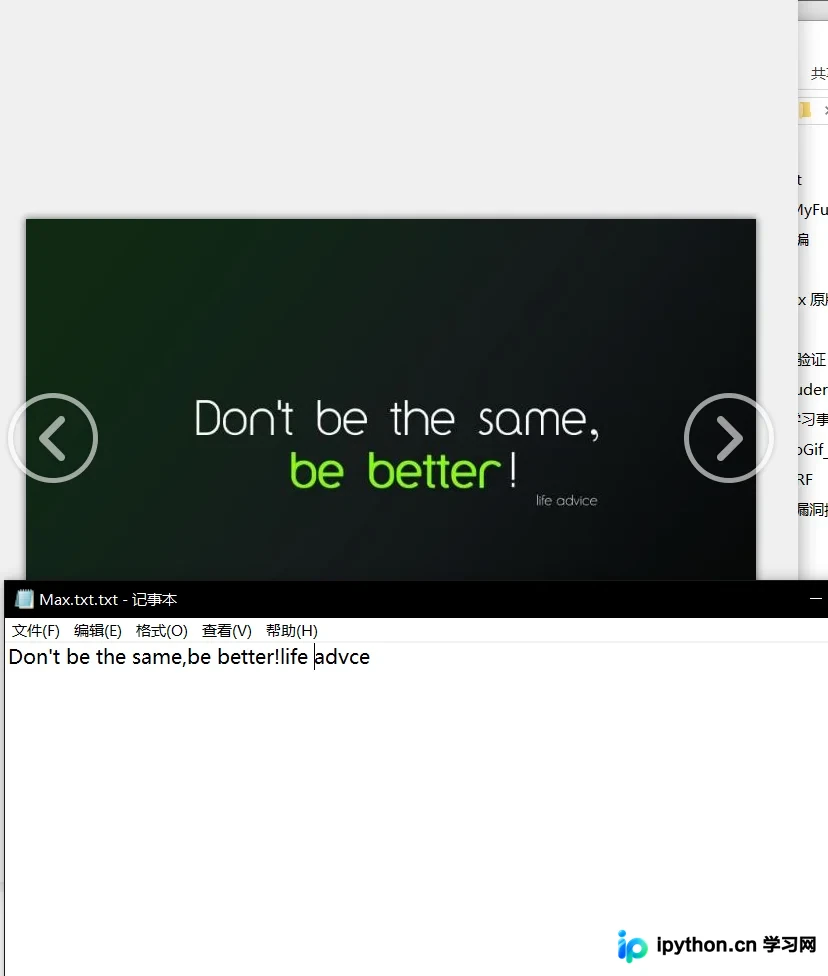
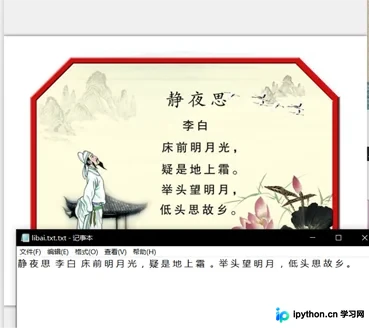
规整的中文同样可以被识别。
具体命令如下:tesseract C://Users\lenovo\Desktop\Tesseract-OCR\libai.png C://Users\lenovo\Desktop\Tesseract-OCR\libai.txt -l chi_sim
接下来我们开始使用Python编写识别小脚本。在此过程中,我们需要一个pytesseract库,可通过pip install pytesseract进行安装。安装完毕后,即可使用Python调用Tesseract。此外,我们还需要安装一个Python的图片处理模块,建议安装pillow。
输入以下代码,可实现与上述Tesseract命令行相同的效果:
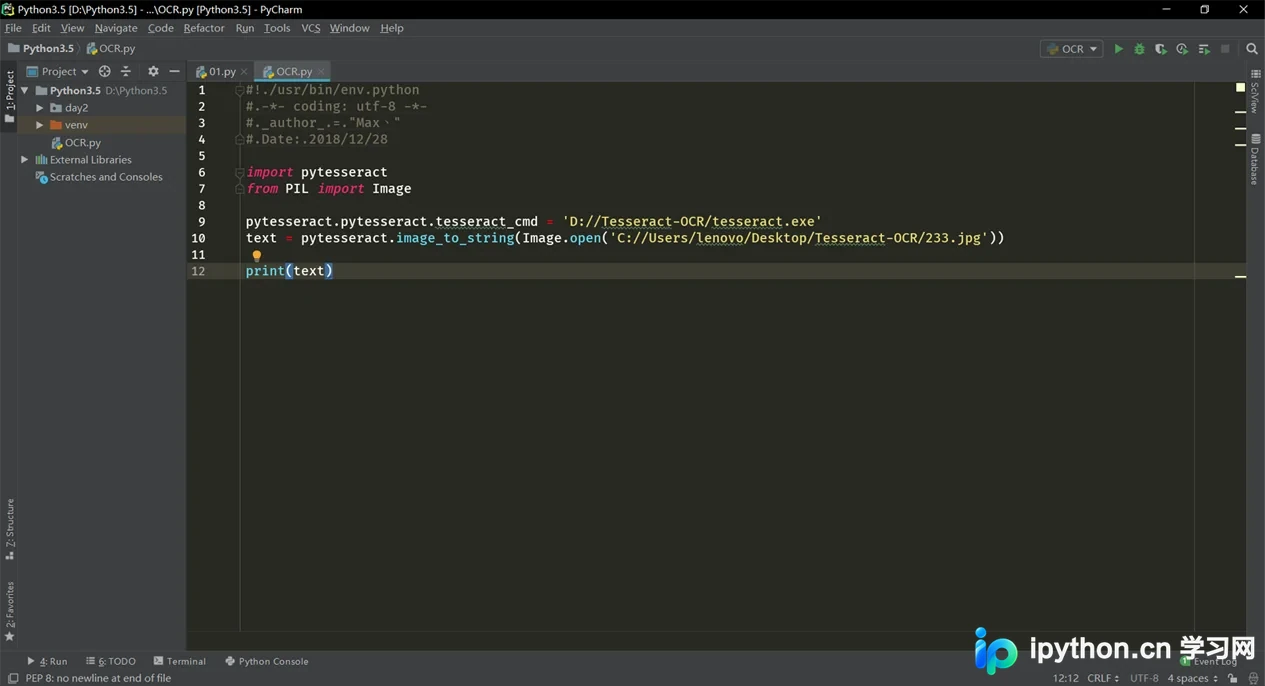
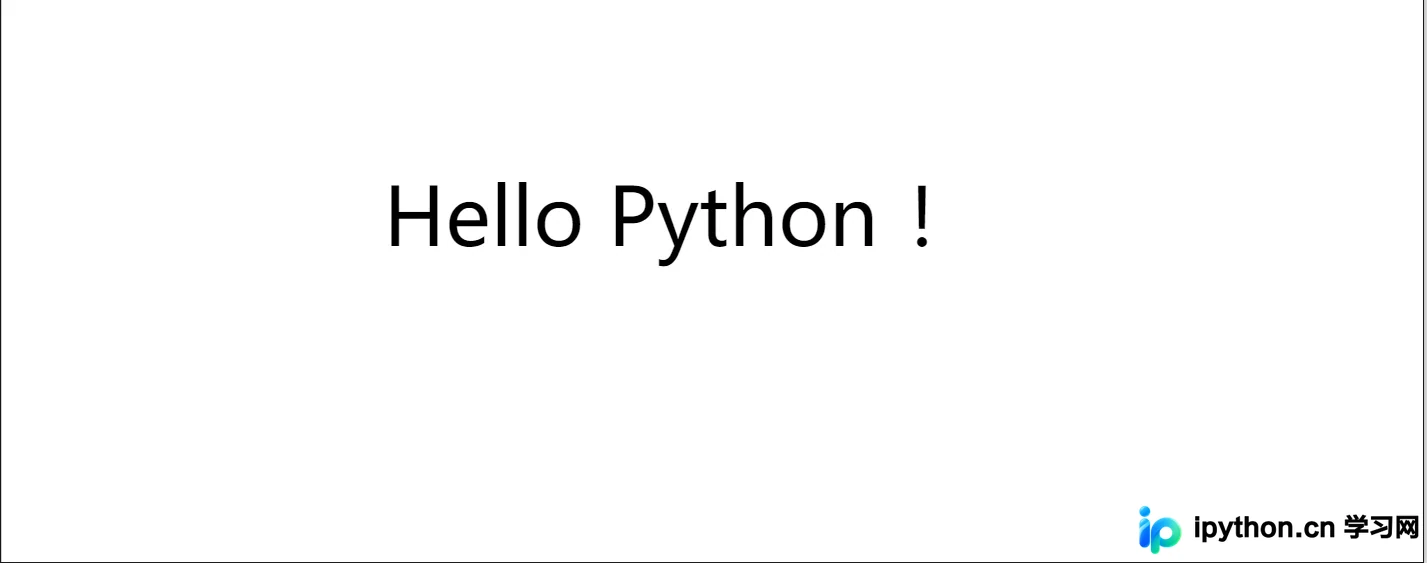
我们的图片内容如下:
运行程序:
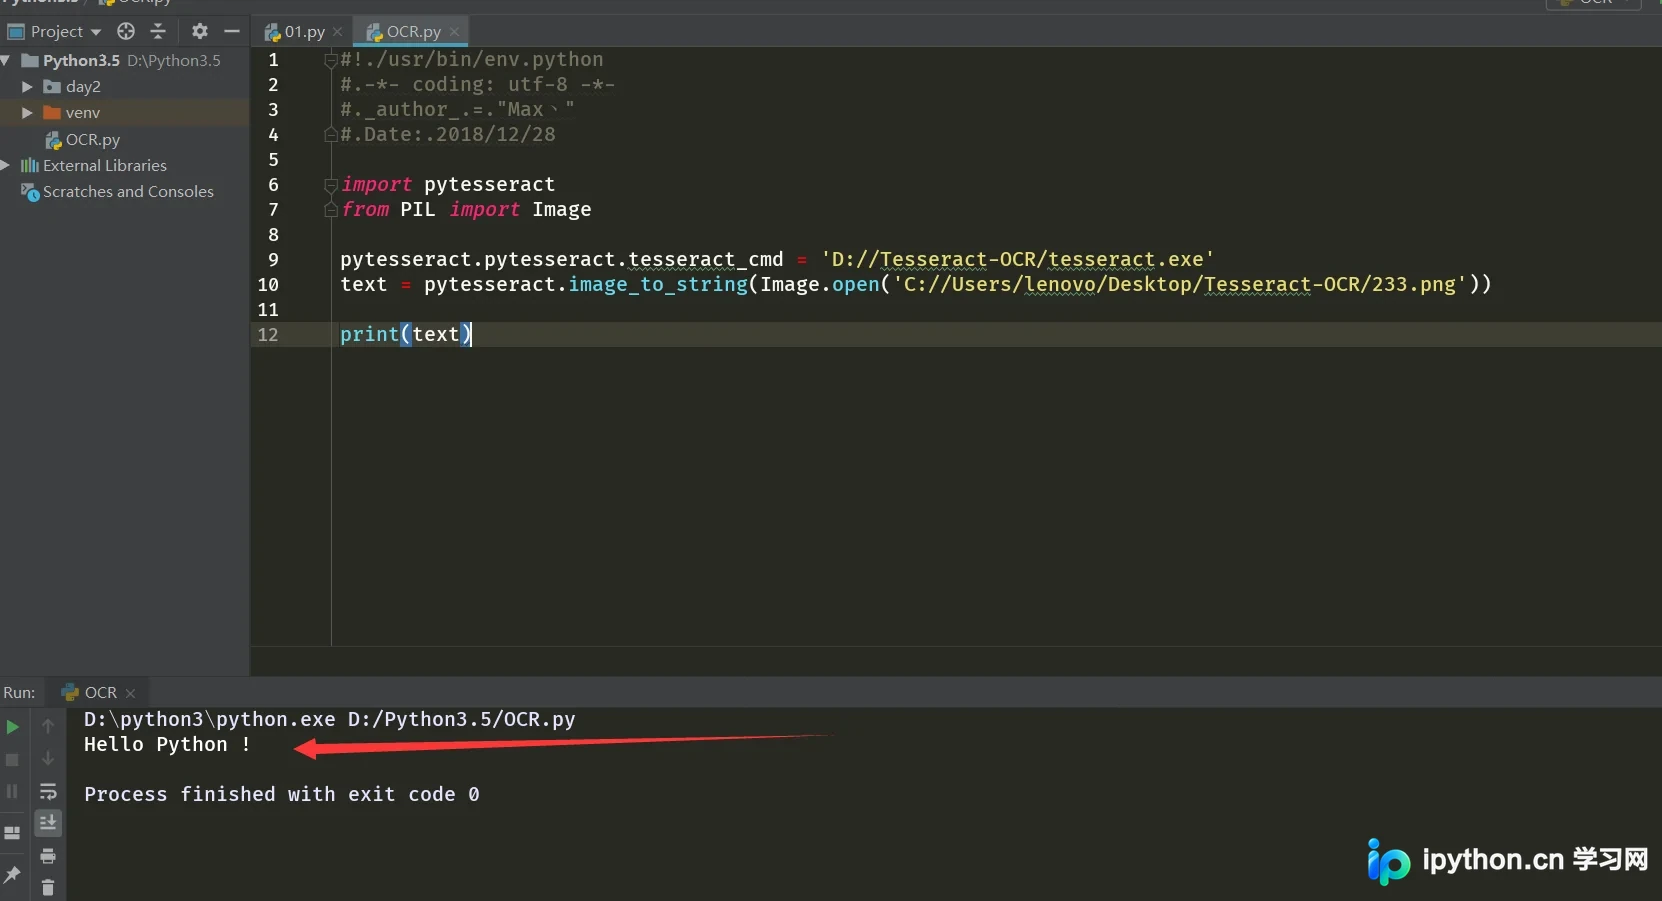
识别结果:
以上就是本文的全部内容,希望对大家的学习有所帮助,也希望大家多多支持本站。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















