



在 Go 项目里,很多人第一次看到 template.Must,都会顺手把这种写法推广到更多场景。但 Must 不是“少写几行错误处理”的通用捷径,而是一种很明确的态度:这个操作如果失败,程序就不该继续跑下去。判断它该不该用,关键不在于你嫌不嫌麻烦,而在于错误是否真的不可恢复。
下面结合标准库写法和常见封装场景,梳理 Must 函数为什么存在、适合放在哪些位置,以及哪些地方最好坚持返回 error。看完后,你可以更快判断:这里该 panic,还是该把错误交给调用方处理。
Must 函数到底是什么
在 Go 语言中,Must 是一种常见的封装模式:把一个原本会返回 (value, error) 的操作包起来,一旦出现错误就直接 panic。标准库中的 template.Must 就是最典型的例子:
func Must(t *Template, err error) *Template {
    if err != nil {
        panic(err)
    }
    return t
}
这种设计有两个直接信号。第一,调用点会变得非常简洁;第二,函数名已经提前告诉调用者:这里的失败不打算恢复,出错就是程序配置、初始化或环境存在严重问题。
因此,Must 的价值不只是省去 if err != nil,更重要的是把“失败即终止”的意图写进 API。只要名字里带了 Must,团队其他人读代码时就应该知道,这不是普通工具函数,而是带有强约束的调用入口。
为什么会需要 Must 写法
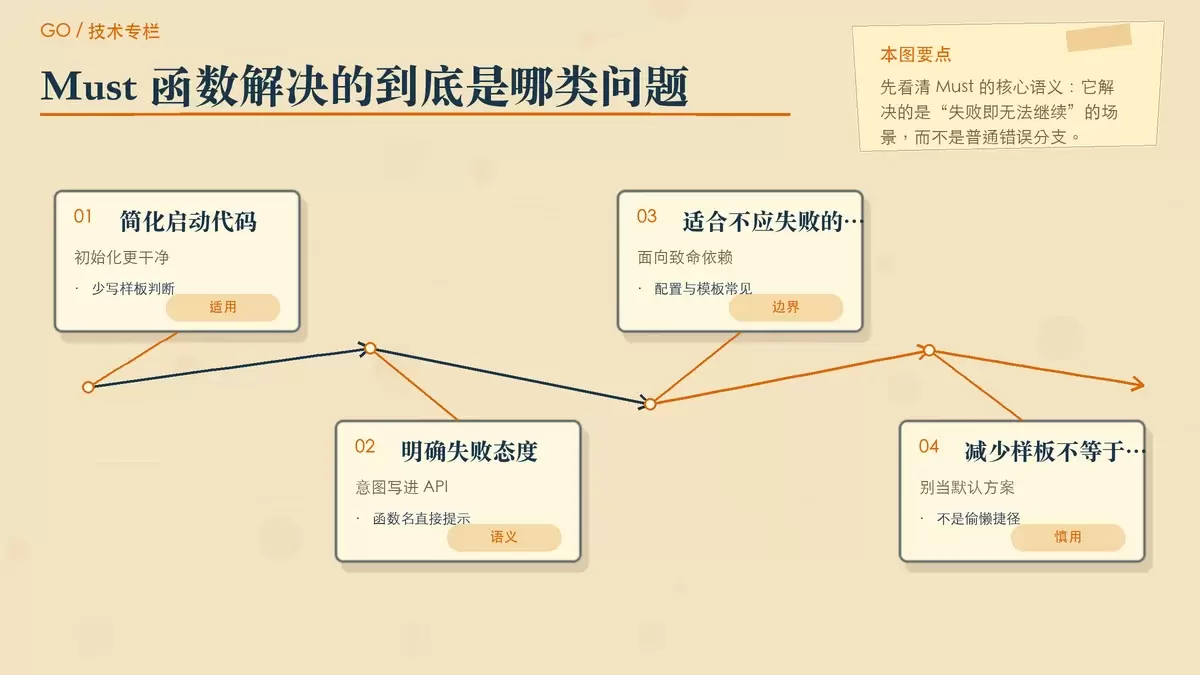
简化启动阶段的代码
程序初始化时,常见操作包括加载配置、解析模板、读取必要文件、准备静态数据。如果这些步骤失败,服务往往连最基本的工作条件都不具备。这时候与其在多层调用里传递错误,不如尽早终止,让问题暴露得更直接。
明确表达“这里本不该失败”
有些错误在语义上虽然存在,但在设计预期里不应发生。比如内置模板写错、随程序发布的配置文件缺失、测试数据格式不合法,这类问题通常属于开发或部署阶段失误,而不是运行期正常分支。用 Must 命名,可以把这种预期明确传递出去。
减少样板式错误处理
如果某个失败分支无论如何都只能终止程序,那么一层层写返回值、再由上层统一退出,未必比直接 panic 更清晰。Must 在这种场景下能减少噪音,让主流程更集中。
更稳妥的使用方式
1. 只放在初始化阶段
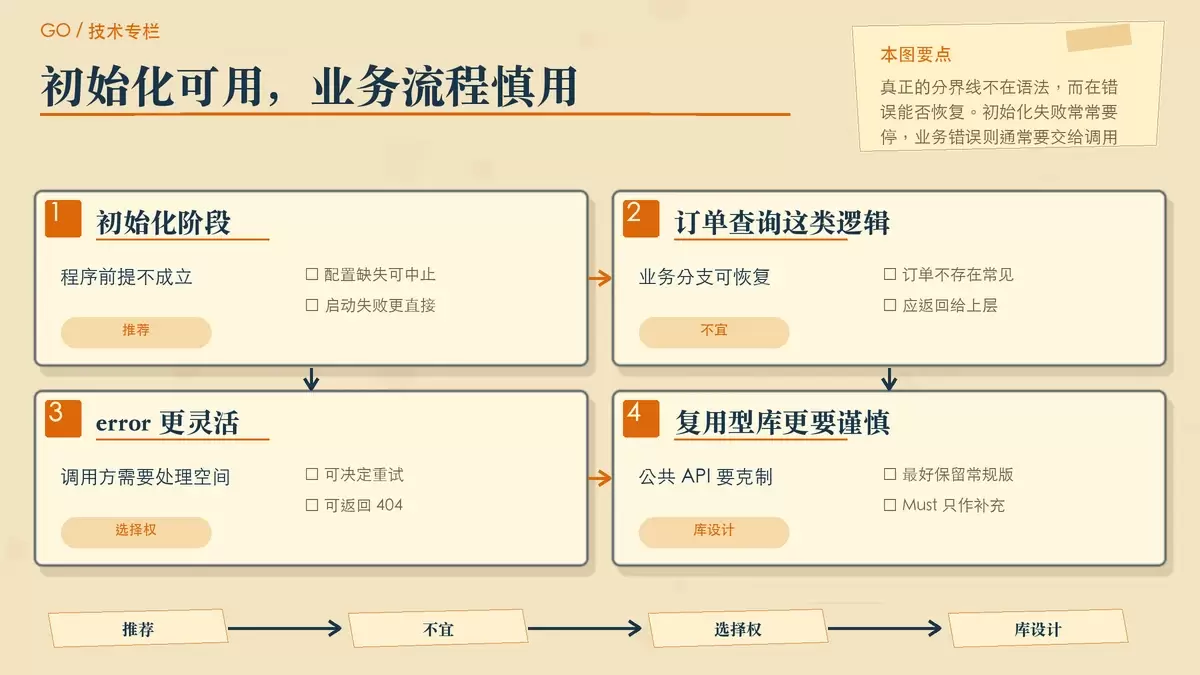
这是最核心的一条。Must 最适合出现在包级变量初始化、程序启动装配、注册步骤或测试准备阶段,因为这里的错误通常是致命且不可恢复的。
// 初始化时加载配置
var config = MustLoadConfig("config.yaml")

func MustLoadConfig(path string) *Config {
    data, err := ioutil.ReadFile(path)
    if err != nil {
        panic("加载配置失败: " + err.Error())
    }
    // 解析配置...
    return config
}这段代码表达得很直接:config.yaml 读不到,程序就没有继续运行的意义。这里用 MustLoadConfig 是合理的,因为它服务的是启动阶段,而不是面向外部请求的动态流程。
2. panic 信息要能直接定位问题
Must 既然选择了失败即中断,那错误信息就不能含糊。最差的写法是只抛一个笼统的 panic,让排查时还要回头猜是哪个环节出的问题。比较实用的做法,是在消息里带上操作类型、输入对象,必要时再拼接底层错误。
func MustParseJSON(data []byte) interface{} {
    var result interface{}
    if err := json.Unmarshal(data, &result); err != nil {
        panic("JSON解析失败: " + err.Error())
    }
    return result
}
像 JSON解析失败 这样的前缀虽然简单,但至少比直接抛底层错误更清楚。实际项目里,如果数据来源固定,也可以补充文件名、配置项名称或调用上下文,方便第一时间定位。
3. 可以基于标准库结果封装自己的 Must 版本
很多标准库或常用库函数都返回 (value, error)。如果这些调用确实只会出现在启动阶段,封装一个团队内部统一的 Must 入口是可行的,这样调用点会更整洁,错误信息格式也更容易统一。
func MustReadFile(path string) []byte {
    data, err := ioutil.ReadFile(path)
    if err != nil {
        panic("读取文件失败: " + err.Error())
    }
    return data
}
这种封装的前提不是“任何文件读取都值得 Must”,而是你要确认它读取的是程序运行前提所必需的内容。否则,同样一个函数名会误导别人把它带进运行期逻辑。
哪些场景不该用 Must
业务逻辑里的错误通常是可处理的
订单不存在、用户输入不合法、远程接口超时、库存不足,这些都属于业务分支的一部分。它们也许常见,也许麻烦,但本质上都不是“程序必须立刻崩溃”的理由。如果在这些地方使用 Must,会把本可恢复的流程硬生生变成进程级故障。
// 不推荐: 在业务逻辑中使用Must
func ProcessOrder(orderID string) {
    order := MustGetOrder(orderID) // 如果订单不存在会panic
    // 处理订单...
}

// 推荐: 返回错误,让调用者决定如何处理
func GetOrder(orderID string) (*Order, error) {
    // 查找订单...
    if order == nil {
        return nil, fmt.Errorf("订单不存在: %s", orderID)
    }
    return order, nil
}
这里的差别不只是代码风格。返回 error 意味着调用方可以决定是重试、记录日志、返回 404,还是走降级逻辑;而 MustGetOrder 会直接剥夺这种选择权。
公共库 API 要慎用
如果你写的是给别人复用的库,而不是只在自家服务启动阶段调用的内部工具,那么默认提供会 panic 的入口通常不是好主意。库使用者往往希望自己决定错误策略。即便要提供 MustXxx,也最好同时保留常规的 Xxx(...)(..., error) 版本,并把语义区分写清楚。
测试里怎么用,以及最后的判断标准
测试代码是 Must 的另一个高频使用场景。原因很简单:测试准备一旦失败,继续执行也没有意义,这时用 Must 可以让测试主体更聚焦。
func TestSomething(t *testing.T) {
    config := MustLoadConfig("test_config.yaml")
    // 测试逻辑...
}相比在测试里反复写一长串错误判断,Must 往往更利落。不过要注意,测试场景下的 panic 信息同样要可读,否则失败报告依然难排查。
回到最初的问题:什么时候该用 Must?一个实用判断标准是,假如这一步失败,调用方是否存在明确、合理、可接受的恢复路径。只要答案是“有”,就应优先返回 error;只有当失败意味着程序前提不成立、继续执行没有意义时,Must 才是合适的选择。
实际使用时,可以把原则收敛成几条:
- 初始化阶段使用,运行期业务流程谨慎回避。
- panic 信息写清楚,至少能说明是哪一步失败。
- 内部封装可以做,但不要把
Must当成偷懒的默认写法。 - 测试代码中可以积极使用,因为失败通常就该立即中止。
- 必要时可在顶层通过
recover兜底,但这不意味着可以随意扩大Must的使用范围。
Must 不是为了替代 Go 的错误处理,而是为少数“失败即不可继续”的场景提供更直接的表达。用得克制,它会让代码更清晰;用得泛滥,代价通常是更脆弱的运行时行为。















