



AI 应用的门槛,已经不再只是训练模型本身。对 Go 开发者来说,更常见也更有价值的工作,是把大模型接进现有服务、补齐知识检索链路、处理高并发调用,并把这些能力稳定地交付出去。本文按“为什么是 Go、要先懂哪些概念、项目里怎么落地”的顺序展开,帮助你判断哪些技术值得优先投入,哪些能力会直接影响系统效果和可维护性。
为什么 Go 在 AI 应用层越来越重要
AI 不是 Python 的专属地盘。训练环节固然仍以 Python 生态为主,但一旦进入服务化、系统集成和基础设施建设,Go 的优势会变得很实际:并发能力强、内存管理高效、语法简洁,适合把模型能力包装成稳定的线上服务。
这和当前很多 AI 业务的运行方式刚好契合。无论是调用云端大模型,还是串起检索、缓存、数据库、队列和业务接口,系统往往都要处理大量网络请求、并发任务和异常重试。在这些场景里,Go 特别适合承担几类职责:
- 高性能 AI 服务后端:对接模型 API,向业务端提供统一接口。
- 数据处理管道:负责清洗、切分、嵌入、索引等中间流程。
- 模型部署与服务化:把本地模型或外部模型包装成可观测、可扩展的服务。
- RAG 与智能体编排层:把检索、推理、工具调用整合成完整应用。
换句话说,Go 开发者未必要从“造模型”开始,但完全可以在 AI 应用真正上线的关键环节里扮演核心角色。
先理解两块基础:大模型与 RAG
大模型是入口,但不是全部
大型语言模型(LLM)是当前 AI 应用的核心引擎,像 GPT、Gemini 都属于这一类。对 Go 开发者来说,最常见的接入方式通常有两种。
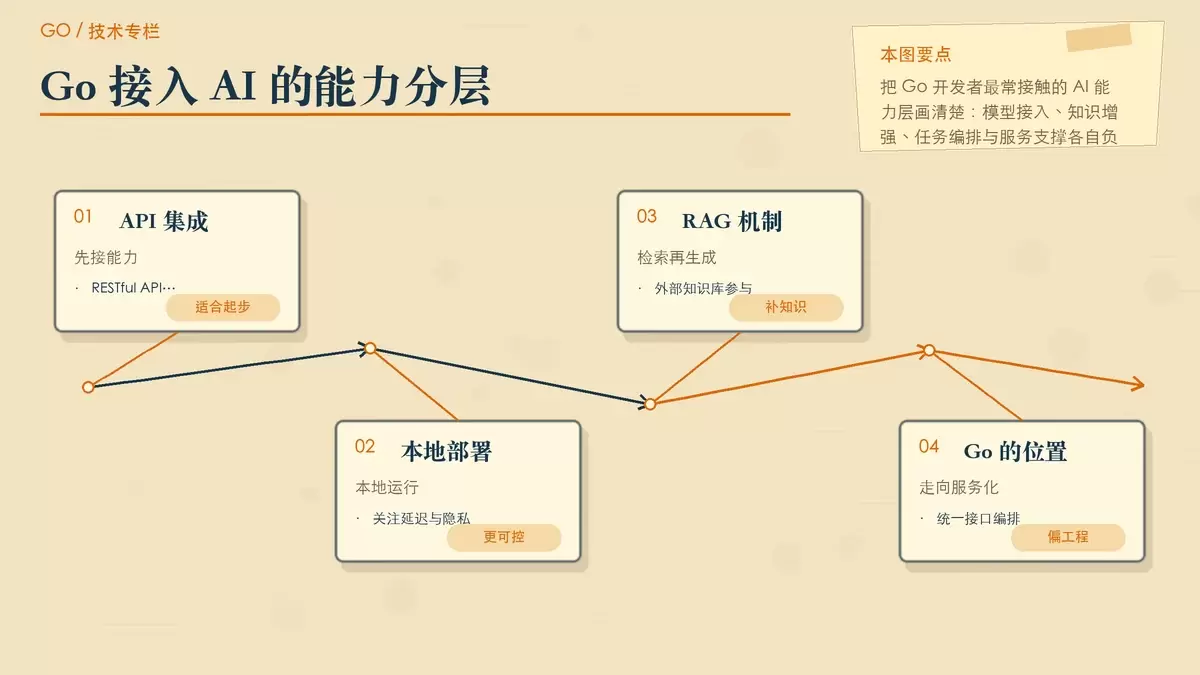
第一种是 API 集成。 这是上手最快、工程成本最低的方式,适合先把模型能力接进已有系统:
// 调用OpenAI API的示例
func callOpenAI(apiKey, prompt string) (string, error) {
    requestBody := OpenAIRequest{
        Model: "gpt-3.5-turbo",
        Messages: []Message{{Role: "user", Content: prompt}},
        Temperature: 0.7,
    }
    // 发送HTTP请求并处理响应
}
这种方式的优点是部署简单、模型更新快,适合验证想法和快速交付。但它也意味着你要考虑网络延迟、调用成本、限流和外部依赖。
第二种是本地模型部署。 如果业务对数据安全、响应延迟或离线可用性要求更高,本地运行量化模型会更合适,例如借助 go-llama.cpp 这样的库完成集成。它的维护复杂度更高,但能换来更强的可控性。
实际判断时可以这样看:如果目标是快速接入能力,先走 API;如果目标是更低延迟、更高隐私或更强自主控制,再考虑本地部署。
RAG 解决的是“模型不知道”与“模型乱说”
只靠大模型本身,往往很难回答带有实时性、私有知识或领域细节的问题,这也是很多业务系统迟迟无法真正落地的原因。检索增强生成(RAG)就是为这个问题准备的。
RAG 的核心思路很直接:先从外部知识库里找出和问题最相关的内容,再把这些内容一并交给大模型生成答案。这样做的价值主要有两点:
- 缓解知识滞后,让模型能利用最新或私有资料。
- 减少幻觉,让回答建立在可检索的依据之上。
在 Go 里实现一套 RAG 系统,通常会涉及下面几个关键组件:
- 向量数据库:例如 Weaviate,用来存储和检索文档向量。
- 嵌入模型:把文本转换成向量表示,便于相似度匹配。
- 检索链:负责把“召回资料”和“生成答案”串起来。
如果不想从头拼装整个流程,可以借助 LangChainGo 这类框架简化开发:
// 使用LangChainGo构建RAG系统
retriever := vectorstores.ToRetriever(vectorStore, 3)
qaChain := chains.NewRetrievalQAFromLLM(llm, retriever)

result, err := chains.Call(context.Background(), qaChain, map[string]any{
    "query": "你的问题",
})
这类抽象的价值不只是少写代码,更在于它把检索、问答和链式调用整理成相对清晰的工程结构,便于后续替换模型、调整召回数量或增加日志和监控。
一个很典型的应用场景是电商售前对话服务。商品知识、活动规则、售后说明都在不断变化,如果只靠模型记忆,很容易答非所问。通过 RAG,把知识库检索和生成过程结合起来,再配合角色链拆分,把复杂 Prompt 分成前置校验、核心推理、输出优化等步骤,系统会更模块化,也更容易维护。
从会回答到会做事:智能体与提示词工程
智能体的重点是规划、执行和工具使用
如果说聊天机器人只是“回答问题”,那智能体(Agent)更像是“为了完成目标而行动”。它不只是生成一段文本,还会围绕任务进行规划、调用工具、读取信息,并根据结果继续推进。
一个成熟的 AI 智能体通常具备几类能力:
- 任务规划:把目标拆成多个步骤。
- 工具调用:访问数据库、搜索接口、业务系统或外部服务。
- 状态记忆:保留上下文,支持多轮交互和持续执行。
- 环境交互:根据外部反馈调整后续动作。
目前常见的智能体框架包括:
- LangChain:LLM 应用开发里最常见的一套框架,包含完整 Agent 模块。
- CrewAI:强调多智能体协作,适合模拟团队分工。
- AutoGPT:更突出从目标到执行的自主推进能力。
对 Go 开发者来说,LangChainGo 的意义在于,它让你可以继续用熟悉的语言把这些能力编排进系统,而不是把“业务后端”和“AI 流程”割裂成两套栈。智能体一旦能调用数据库、业务接口甚至外部系统,AI 应用的边界就会从“回答问题”扩展到“代替用户完成部分任务”。
提示词工程决定输出质量的下限
很多项目效果不稳定,并不是模型不够强,而是输入给模型的信息组织得不够好。提示词工程的本质,是让模型准确理解任务边界、上下文和输出要求。
几种常见且实用的基础技巧包括:
- 角色设定:明确模型应该扮演什么角色。
- 上下文提供:把必要背景补足,避免模型凭空补全。
- 格式指定:明确输出结构,减少结果不可用的情况。
- 示例引导:提供少量样例,也就是 few-shot learning。
在业务系统里,这些技巧往往不是“写一段漂亮的话”那么简单,而是要被拆进不同节点中。例如电商客服场景里,先做内容相关性判断,再做商品信息推理,最后再约束输出方式,就是很典型的多阶段提示设计:
// 内容审查提示词
systemPrompt := `
请仔细检查用户输入文本,判断是否与电商咨询相关。
只输出Y或N,分别代表是或不是相关咨询问题。
`

// 推理回答提示词
systemPrompt = `
请仔细阅读用户咨询问题,结合商品信息进行回答。
分步骤判断和回答...
`
这种做法的好处,是把原本混在一段 Prompt 里的多种职责拆开,让每一步都有清晰输入和输出。后续无论是调试准确率、增加兜底逻辑,还是替换模型,都更容易定位问题。
再往前一步,像思维链(Chain-of-Thought)这样的高级技巧,可以在复杂问题上提升推理表现。不过在工程实践里,重点不只是“让模型多想一步”,而是评估这种提示方式是否真的能带来更稳定的结果,以及是否会增加时延和成本。
Go 项目里怎么把 AI 能力落到工程实践
项目结构先按职责拆开
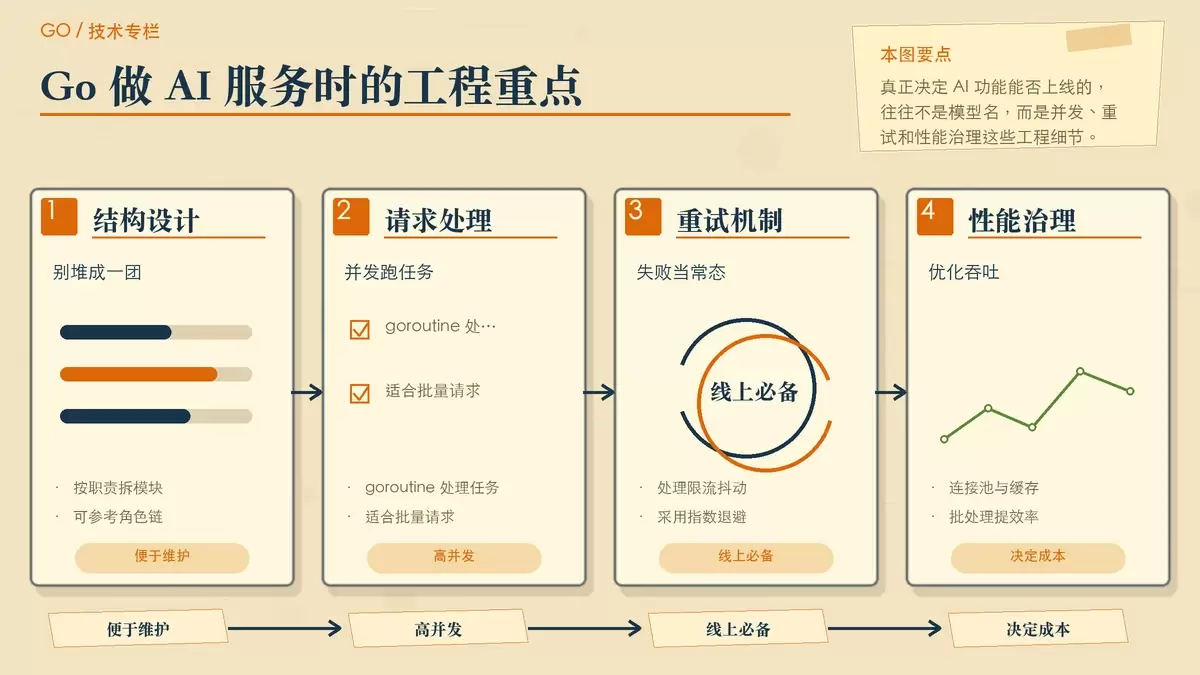
AI 项目很容易在迭代中变成“所有逻辑都堆在调用模型前后的一团代码”。因此,结构设计要尽早按职责拆分。一个可行的思路,就是参考角色链模式,把输入校验、检索、推理、输出整理等流程拆成多个模块,让每个模块只负责一类任务。
这样做的直接收益是:更容易测试、更容易替换组件,也更适合多人协作。
并发处理是 Go 的天然优势
AI 应用经常要同时处理大量请求,比如批量问答、异步摘要、多个检索任务并行执行。Go 的 goroutine 和同步原语在这里非常顺手:
// 使用goroutine并发处理多个AI请求
func processBatch(queries []string) []string {
    results := make([]string, len(queries))
    var wg sync.WaitGroup

    for i, query := range queries {
        wg.Add(1)
        go func(idx int, q string) {
            defer wg.Done()
            results[idx] = processSingleQuery(q)
        }(i, query)
    }

    wg.Wait()
    return results
}
这种模式适合把多个独立请求并发跑起来,缩短整体等待时间。但在实际系统中,还要继续考虑并发数限制、超时控制和下游 API 的配额,否则吞吐上去了,失败率也可能一起上升。
错误处理和重试机制不能省
AI 服务调用并不稳定。问题可能来自网络抖动、接口限流、服务端繁忙,或者模型供应商的临时波动。对线上系统来说,光能调通远远不够,必须把失败当成常态来设计。
因此,指数退避重试机制往往是基础配置。它能避免请求在短时间内集中重试,把临时故障进一步放大。配合超时、熔断、日志和告警,才能把模型调用真正纳入可运营的服务治理体系。
性能优化通常集中在三件事
当 AI 能力开始进入真实业务流量,性能问题很快就会出现。Go 项目里最常见的优化方向通常有三类:
- 连接池:统一管理数据库和外部 API 连接,减少频繁建立连接的开销。
- 缓存层:缓存高频查询结果,降低重复调用成本。
- 批处理:合并多个请求,提高吞吐和资源利用率。
这些优化并不“炫技”,但它们往往决定了一个 AI 功能是只能做演示,还是能在生产环境长期运行。
Go 开发者的学习路径与下一步判断
如果你准备系统进入 AI 方向,与其一开始追逐所有新框架,不如按清晰路径推进。一个更务实的顺序是:
- 掌握基础:先补齐机器学习基本概念,以及 Go 里的 AI 工具和生态分布。
- 实践 API 集成:从调用大模型 API 开始,理解请求、上下文、提示词和返回结果的基本交互方式。
- 深入学习 RAG:把向量数据库、嵌入和检索链真正串起来,理解为什么“有知识”不等于“会回答”。
- 探索智能体开发:学习 LangChainGo 等框架,尝试让模型调用工具和完成任务。
- 参与实际项目:在客服、搜索、知识库、流程自动化等场景里验证效果和边界。
这条路径背后的逻辑很明确:先掌握调用模型的基本方式,再解决知识增强问题,然后进入更复杂的任务编排与自治执行。这样更容易把“概念理解”转化成“工程能力”。
从趋势上看,Go 在 AI 领域最有潜力的位置,依旧是基础设施和应用落地层。随着业务对高性能、高并发、可维护系统的要求越来越高,Go 的价值不会减弱,反而会在模型接入、服务编排和生产部署上变得更突出。
对 Go 开发者来说,真正值得关注的不是“要不要学 AI”,而是“自己应该切入 AI 的哪一层”。如果你的强项本来就在服务端、系统架构和工程稳定性,那么现在就是把这些能力迁移到 AI 应用中的合适时机。















