



很多 Go 开发者对 sync.Map 的印象,还停留在“读多写少才合适,一旦频繁写入新 Key 就该换回 RWMutex + map”的阶段。这个经验在旧版本里确实成立,但放到 Go 1.26 已经不够用了。本文结合 Go 1.26 标准库源码与 Benchmark 数据,拆开看它到底改了什么、为什么并发写不再是硬伤,以及在什么场景下你仍然该保留对原生 map 的偏好。
Go 1.26 为什么改写了大家对 sync.Map 的旧印象
在 Go 1.23 及更早版本中,sync.Map 最常被诟病的问题,就是写入一个不在现有读表中的新 Key 时,可能触发 dirtyLocked(),需要重新遍历 read 表并做全量浅拷贝。这个过程既带来 O(N) 级复制成本,也会放大锁竞争,所以“新增 Key 多就容易掉速”并不是误解,而是旧实现下的真实特征。
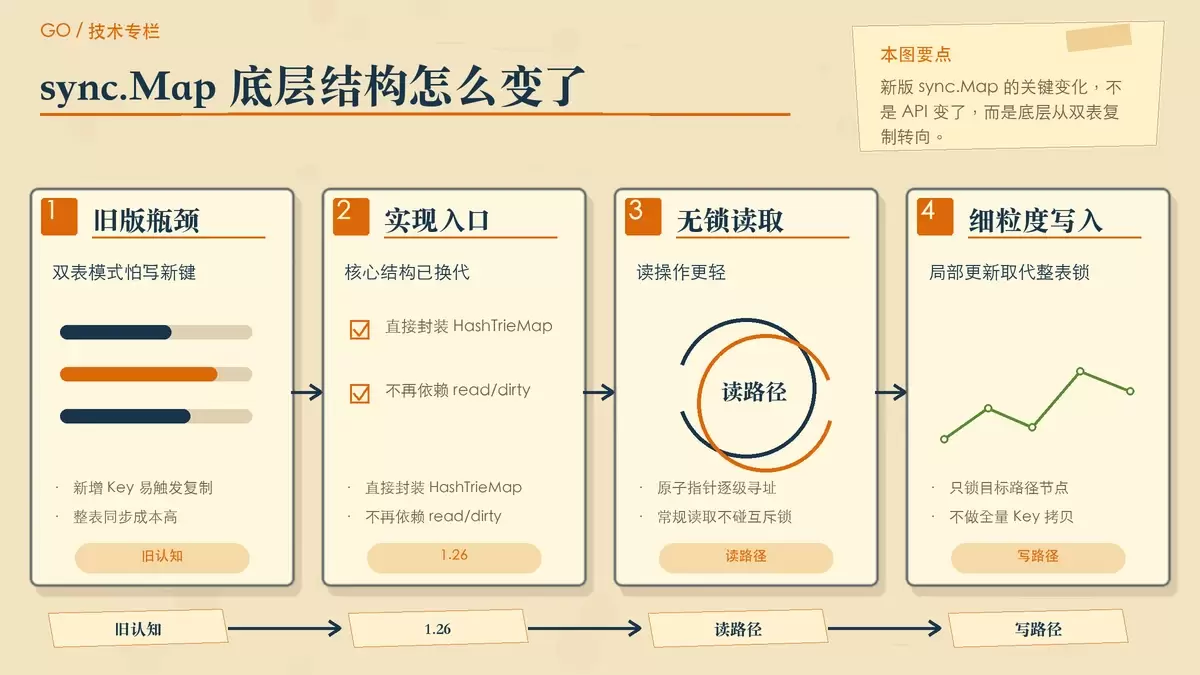
Go 1.24 到 Go 1.26 这段时间里,官方对这套机制进行了重构。到了 Go 1.26,sync.Map 已经不再依赖经典的 readOnly / dirty 双表协作模式,而是直接封装新的底层结构:
// Go 1.26 源码路径:src/sync/map.go (L38-L42)
type Map struct {
    _ noCopy

    m isync.HashTrieMap[any, any] // 直接封装底层 HashTrieMap
}
这意味着讨论 Go 1.26 的 sync.Map 时,已经不能再简单套用旧版本的经验结论。过去那个最敏感的问题,核心就在于“写新 Key 会不会拖累整张表”;而新版实现正是从这里下手,把旧瓶颈直接拆掉了。
底层换成 Hash-Trie 后,读写路径发生了什么变化
顺着标准库继续往下看,在 src/internal/sync/hashtriemap.go 里,可以看到新实现基于并发哈希前缀树,也就是 HashTrieMap:
// Go 1.26 源码路径:src/internal/sync/hashtriemap.go (L21-L28 & L541-L547)
type HashTrieMap[K comparable, V any] struct {
    root atomic.Pointer[indirect[K, V]] // 指向 16 分叉根节点
}

type indirect[K comparable, V any] struct {
    dead     atomic.Bool
    mu       Mutex // 仅保护当前节点的子分叉变更(细粒度锁)
    children [16]atomic.Pointer[node[K, V]] // 16 个子节点原子指针
}
这套结构带来的变化,可以直接对应到并发读写的两条关键路径。
读操作基本走原子寻址,不碰互斥锁
读取时,调用方沿着 16 分叉树逐级定位节点,主要依赖类似 slot.Load() 这样的原子指针读取。换句话说,常规读路径不需要像以前那样顾虑整表级别的同步切换,锁冲突自然也会少很多。
写新 Key 只锁局部节点,不再复制整张表
更关键的是写路径。插入一个全新的 Key 时,Go 1.26 不再把问题升级成“同步整张 Map 的状态”,也不需要做任何全量 Key 浅拷贝。它只会在目标路径上的 indirect 节点加锁,例如通过 i.mu.Lock() 保护当前局部结构变更。
这就是为什么旧版本中“写新 Key 是 sync.Map 软肋”的判断,在新版本里已经失去了前提。瓶颈从全局复制和整表锁,变成了局部节点更新,锁粒度明显缩小,并发扩展性也随之改变。
基准测试说明了什么:纯写新 Key 也不再天然吃亏
源码变化是否真的转化成实际收益,还得看基准测试。文中给出的测试环境是多核 CPU、8 线程并发,并且分别覆盖了两个典型场景:100% 纯写入全新 Key,以及 80% 读 + 20% 写的混合负载。
先看纯写新 Key 的测试代码:
// 场景一:纯并发写入无限新 Key
func BenchmarkSyncMap_PureWriteNewKeys(b *testing.B) {
    var sm sync.Map
    var counter int64
    b.RunParallel(func(pb *testing.PB) {
        for pb.Next() {
            k := int(atomic.AddInt64(&counter, 1))
            sm.Store(k, k) // 并发写入全量全新 Key
        }
    })
}
执行命令如下:
go test -bench=. -benchmem对应结果为:
goarch: amd64
cpu: Intel(R) Core(TM) i7-9700KF CPU @ 3.60GHz

100% 极端纯并发写入无限新 Key:
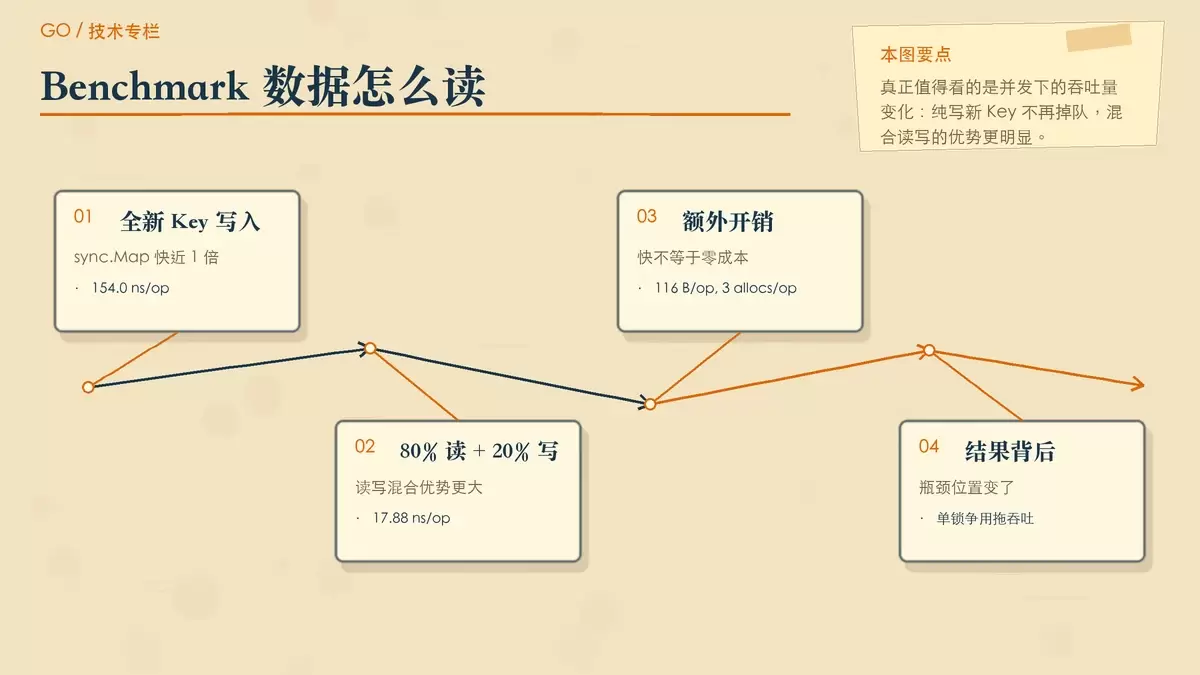
BenchmarkSyncMap_PureWriteNewKeys-8       7669268    154.0 ns/op    116 B/op    3 allocs/op
BenchmarkRWMutexMap_PureWriteNewKeys-8    5005837    304.7 ns/op     60 B/op    0 allocs/op

80% 读 + 20% 写真实高并发混合场景:
BenchmarkSyncMap_MixedReadWrite-8       86082942     17.88 ns/op     12 B/op    0 allocs/op
BenchmarkRWMutexMap_MixedReadWrite-8    16439073     75.02 ns/op      0 B/op    0 allocs/op
极端纯写场景:sync.Map 反而快了近 1 倍
最值得注意的是第一组数据。面对 100% 并发写入全新 Key,sync.Map 的成绩是 154.0 ns/op,而 RWMutex + map 是 304.7 ns/op。也就是说,在这个过去最容易被判定为“不适合 sync.Map”的场景里,新版实现反而快了近 1 倍。
这并不代表 sync.Map 没有成本。数据也清楚写着,它在该场景下有 116 B/op、3 allocs/op,而 RWMutex + map 是 60 B/op、0 allocs/op。但在多核并发下,真正拖累吞吐量的往往不是这点额外分配,而是单个 RWMutex 背后的全局锁争用。
混合读写场景:无锁读和细粒度锁优势更明显
在 80% 读 + 20% 写的现实型负载里,这种差距进一步拉开。sync.Map 单次操作耗时 17.88 ns/op,而 RWMutex + map 是 75.02 ns/op,前者大约是后者的 4.2 倍。
这组结果和底层结构是对得上的:读路径不需要互斥锁,写路径只在局部节点上同步,所以线程数上来之后,HashTrieMap 的扩展性比单锁模型更容易发挥出来。
sync.Map 还有哪些成本没有消失
说 Go 1.26 改写了 sync.Map 的旧结论,不等于它从此在任何场景都通吃。至少有两类成本,重构之后仍然存在。
接口装箱依旧存在
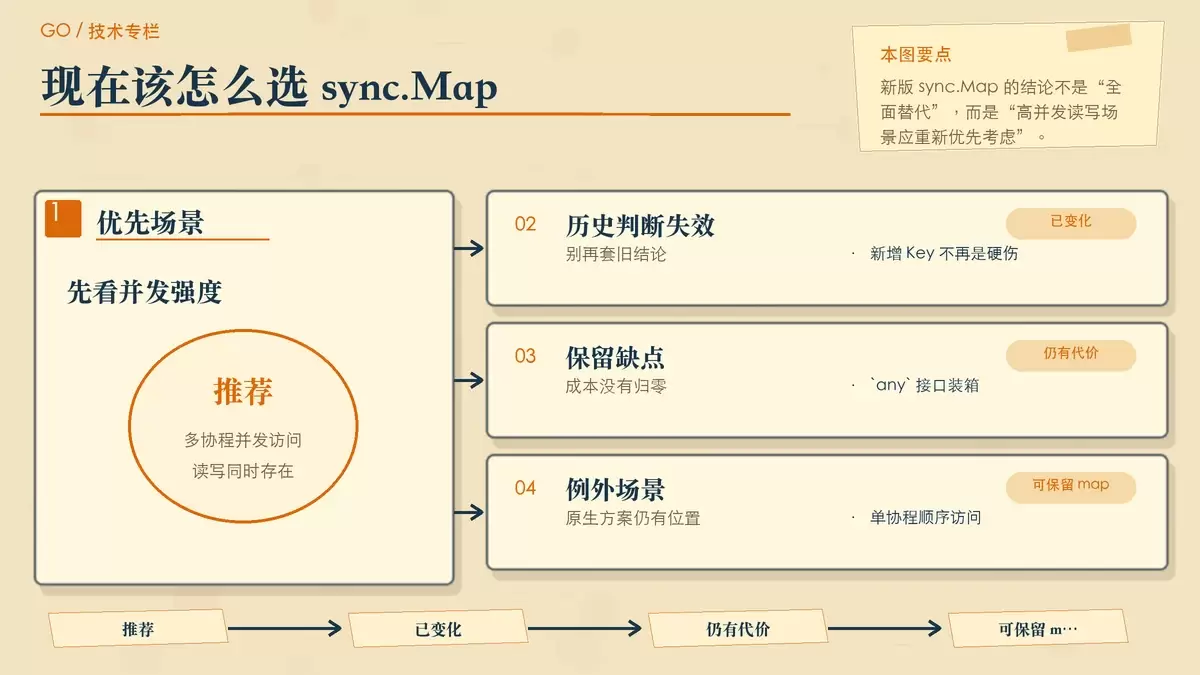
sync.Map 对外暴露的接口仍然是基于 any 的形式,文中提到的是 Map[any, any](src/sync/map.go L47)。如果你存的是 int、小结构体等基础值类型,仍然要经过接口转换。对极端追求低分配、低抽象开销的场景来说,这不是可以忽略的细节。
节点和指针结构会带来额外内存成本
Hash-Trie 的优势在于并发组织方式,但它不是连续内存块。相比原生 map 的存储局部性,树节点、链路和指针追踪会带来更高的单元素空间占用,也可能增加缓存不命中的概率。
因此,如果你的程序并不是多协程高并发访问,而是单协程顺序读写,或者对内存占用格外敏感,那么原生 map 依然有它稳定、直接的一面。
Go 1.26 下该怎么重新判断选型
把源码和测试数据放在一起看,结论其实很明确:在 Go 1.26 中,“sync.Map 不能频繁写新 Key”已经不再是可靠的工程经验,至少不能再当成默认前提。
更实际的判断方式可以收敛成两条:
- 如果你的场景是多协程高并发读写,而且包含不少新增 Key,那么新版
sync.Map值得优先进入候选。基于 Hash-Trie 的无锁读和细粒度锁,它的综合吞吐量与扩展性已经显著强于传统的RWMutex + map。 - 如果你的场景更接近单协程顺序访问、对内存占用非常敏感,或者你就是要尽量避免
any带来的接口装箱成本,那么原生map,以及按需设计的分片锁方案,仍然有保留空间。
换句话说,Go 1.26 不是让所有人无条件抛弃 map + lock,而是把 sync.Map 从“只适合特定读多写少场景”的工具,重新拉回到了更广泛的高并发选型范围里。以后再看到“新增 Key 一多就别用 sync.Map”这类说法,先确认对方讲的是不是旧版本实现,再决定要不要照单全收。















