



在 Go 项目里,int 和 int64 看起来只差几个字符,实际牵涉到平台位宽、标准库接口、数据库字段映射以及跨端传输精度。很多代码里“能跑”的写法,一旦换到 32 位环境、接数据库或过 JSON,就可能出现额外转换甚至溢出问题。下面按“默认怎么选、哪些场景必须固定宽度、有哪些坑要提前避开”三件事展开,帮你把这类选择题变成一套可直接落地的判断规则。
先看清 Go 的整型家族
Go 提供的整型类型并不少,既有固定宽度的有符号、无符号整数,也有与平台相关的类型:
// 有符号整型
int8    // -128 到 127
int16   // -32768 到 32767
int32   // -2147483648 到 2147483647
int64   // -9223372036854775808 到 9223372036854775807

// 无符号整型
uint8   // 0 到 255
uint16  // 0 到 65535
uint32  // 0 到 4294967295
uint64  // 0 到 18446744073709551615

// 平台相关类型
int     // 32位系统是int32,64位系统是int64
uint    // 32位系统是uint32,64位系统是uint64
uintptr // 用于存储指针的整数类型这里最需要先记住的是:int 不是固定 32 位,也不是固定 64 位,它和运行平台绑定。在 32 位系统上,int 是 4 字节;在 64 位系统上,int 是 8 字节。相比之下,int64 始终是固定的 8 字节。
这也是很多争论的起点:既然现在大多数线上服务跑在 64 位环境,是否可以直接把所有整数都写成 int64?答案并不是绝对否定,但也绝不是“一把梭”。真正的关键,不在于统一写法是否省心,而在于你的值到底是服务于本地计算,还是需要跨平台、跨进程、跨存储边界保持一致。
int 和 int64,到底怎么选
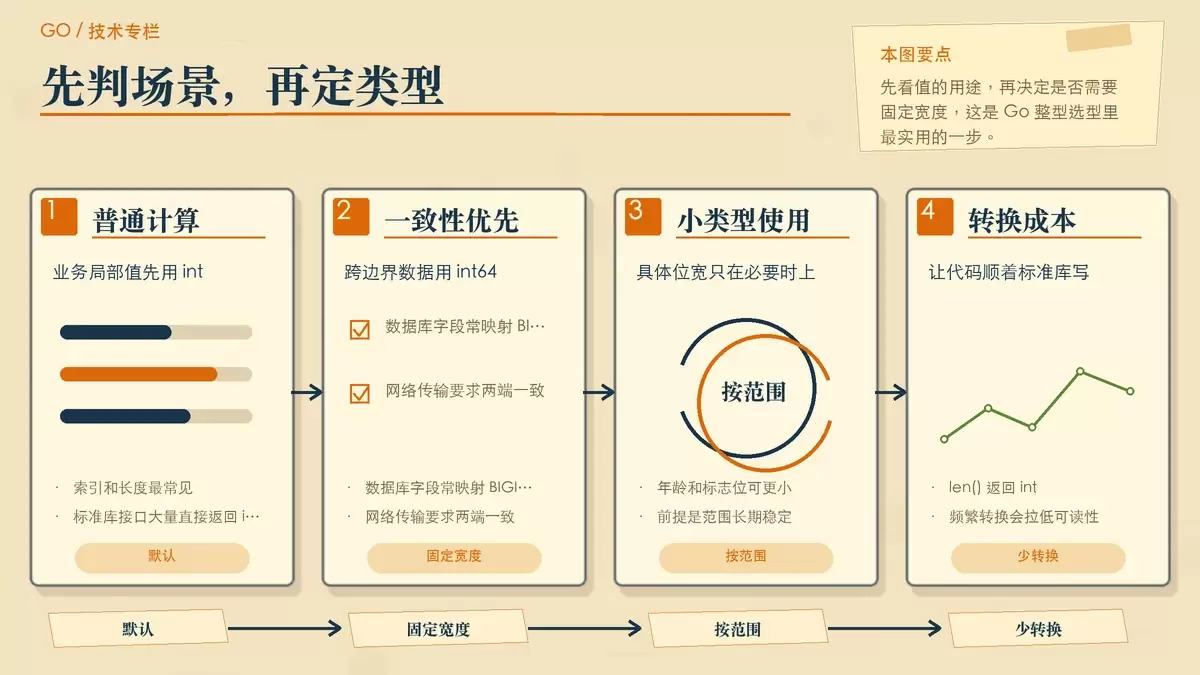
一般业务代码,默认优先用 int
如果整数只是用于普通业务计算,比如数组索引、循环计数器、订单数量、列表长度,优先用 int 通常是更自然的选择。
// 数组索引
for i := 0; i < 10; i++ {
    fmt.Println(i)
}

// 订单数量
orderCount := 100
这么选主要有三个原因。
- Go 标准库大量接口直接使用
int。 int是平台上最顺手的通用整型,日常代码最少折腾。- 能减少显式类型转换,让代码更短也更符合 Go 的习惯。
最典型的例子就是 len()。它返回的就是 int:
s := []string{"a", "b", "c"}
length := len(s) // 返回int类型
fmt.Println(length)
如果你在这种局部逻辑里强行把结果放进 int64,反而会立刻遇到类型不匹配:
// ❌ 编译错误:类型不匹配
var length int64 = len(s)

// ✅ 需要显式转换
var length int64 = int64(len(s))这类转换单看一次不算麻烦,但一旦出现在切片长度、索引计算、循环边界、标准库调用之间,代码会很快变得别扭。对于只在当前进程内部使用、又不涉及大范围数值的变量,int 往往就是最省事的答案。
需要固定范围和跨平台一致性时,用 int64
一旦整数要穿过“边界”,优先级就变了。这里的边界包括数据库、网络传输、序列化、日志落盘、跨平台运行等。只要你希望这个值不因为平台不同而变化,就应该直接选固定宽度类型,最常见的就是 int64。
典型场景包括:
- 数据库 ID 字段
- 时间戳
- 跨网络传输的数值
- 可能超过 21 亿的大数值
// 数据库主键ID,用int64更稳妥
type User struct {
    ID int64 `db:"id"`
    Name string
}

// 时间戳,通常用int64
timestamp := time.Now().Unix() // 返回int64

// 处理大数值
bigNumber := int64(9223372036854775807)
尤其是数据库场景,很多表的 BIGINT 字段天然就对应 Go 的 int64。如果模型里写成 int,你可能在当前 64 位机器上暂时感觉不到问题,但从类型表达上,它已经不再准确,也会在驱动映射、扫描赋值、接口约束上增加不必要的不确定性。
时间戳同理。像 time.Now().Unix() 这类 API 已经明确返回 int64,本身就说明这类值的语义偏向“固定宽度、可传输、可存储”,而不是“随平台变化的本地整数”。
已知范围很明确时,再考虑更具体的类型
如果你非常清楚一个字段的数值范围,那么选择最小够用的类型确实可以节省内存。在处理大量对象、长切片或高吞吐数据结构时,这种优化是有实际意义的。
// 年龄,不会超过255,用uint8足够
type Person struct {
    Age uint8
}

// 分数,0-100,用uint8
score := uint8(95)

// 状态码,用int32
statusCode := int32(200)
但这里有个前提:只有在范围确定且确实存在规模收益时,这样做才值得。因为 Go 在很多算术和接口场景里并不会替你自动打通不同整数类型,小类型带来的节省,有时会被频繁的转换抵消掉阅读性和维护性上的成本。
换句话说,uint8、int32 这些类型不是不能用,而是不适合当作日常默认值。它们更像是“表达约束”或“服务于结构优化”的工具,而不是通用替代品。
放到实际场景里看,会更容易判断
Web 后端接口开发
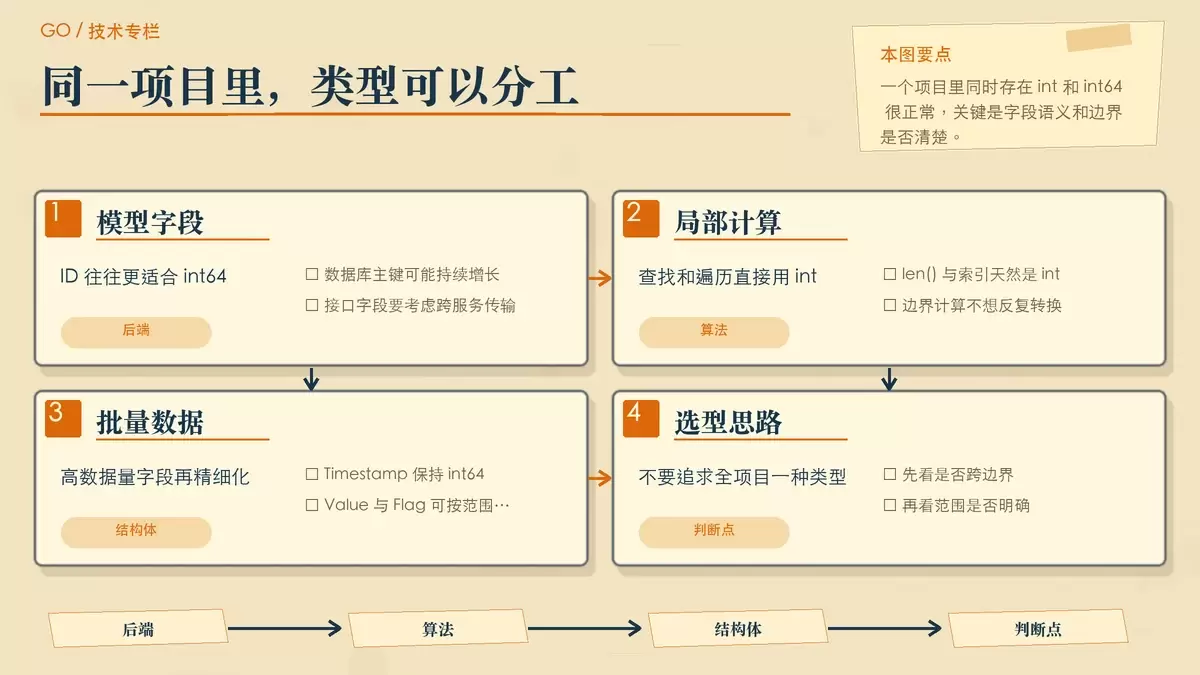
在 Web 后端里,整数往往同时出现在数据库模型、请求参数、业务处理和 JSON 返回结果中。这类代码最适合按字段语义来拆分选择,而不是全都统一一种类型。
// 推荐做法
type User struct {
    ID   int64  `json:"id"`   // 数据库ID用int64
    Age  int    `json:"age"`  // 年龄用int足够
    Score int   `json:"score"` // 分数用int
}
这里 ID 用 int64,通常比 int 更稳妥,原因很直接:
- 数据库自增 ID 可能超过 2147483647
- 数据要跨语言、跨服务传递时,需要固定宽度
- 模型字段与数据库类型对应更清晰
而像年龄、分数这类普通业务值,如果只是做常规运算和展示,int 已经够用,代码也更顺手。
算法和数据结构实现
算法题、工具函数、基础数据结构,往往是 int 最舒服的主场。原因不是它“更大”或“更快”,而是它和索引、长度、切片边界天然一致。
// 二分查找
func binarySearch(arr []int, target int) int {
    left, right := 0, len(arr)-1
    for left <= right {
        mid := left + (right-left)/2
        if arr[mid] == target {
            return mid
        } else if arr[mid] < target {
            left = mid + 1
        } else {
            right = mid - 1
        }
    }
    return -1
}
这类逻辑里使用 int 的好处很明确:
len()返回int- 数组和切片索引使用
int - 边界计算不需要到处转换类型
如果这里硬换成 int64,每次拿长度、做索引、访问元素时都要来回转换,几乎得不到收益,却会让实现变得更啰嗦。
大量数据与性能敏感结构
当你处理的是上百万条记录、采样点或内存驻留对象时,整数类型的选择才真正会影响结构体体积和整体占用。这时最合适的做法,通常不是“统一 int64”,而是根据字段职责分别选型。
// 处理大量数据时,选择合适的类型
type DataPoint struct {
    Timestamp int64 // 时间戳用int64
    Value     int32 // 数值范围明确用int32
    Flag      uint8 // 标志位用uint8
}这个例子里,Timestamp 用 int64 是因为它要表达固定格式的时间值;Value 用 int32,前提是业务确认范围足够;Flag 用 uint8,则是在明确字段很小的情况下节约空间。这样的收益只有在数据规模大时才明显,但一旦规模上来,结构设计是否克制会直接影响内存占用和缓存命中。
几个最常见的坑,最好提前避开
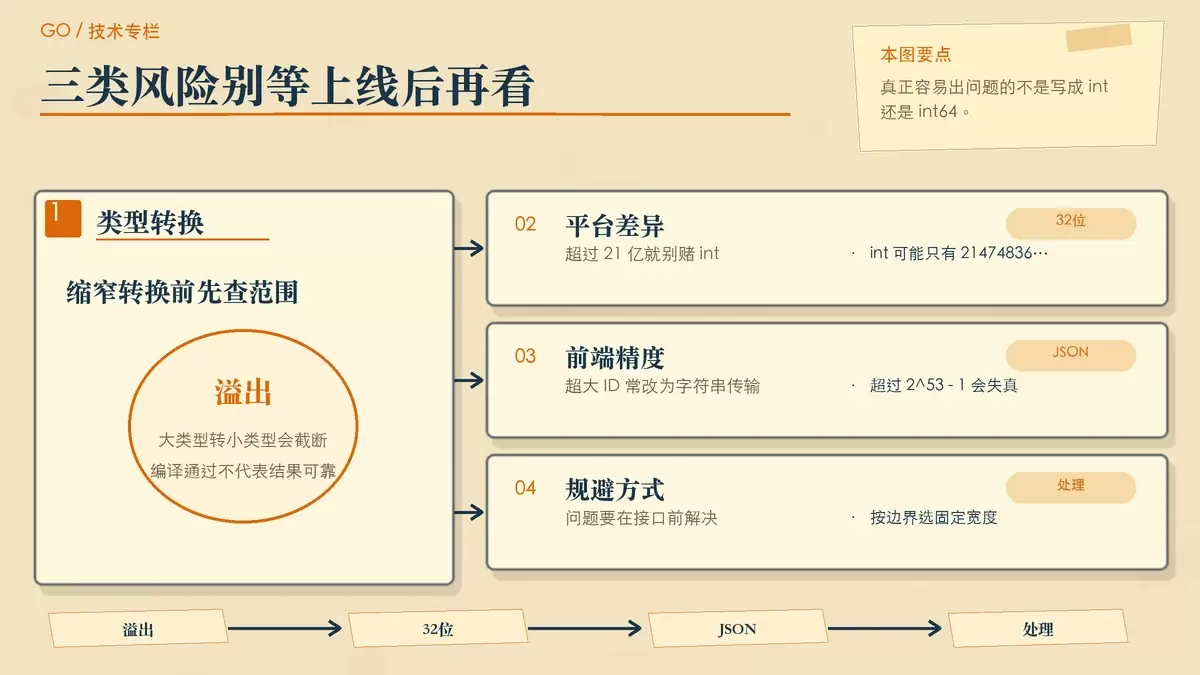
大类型转小类型,可能直接溢出
从宽类型转换到窄类型时,风险一直都在,Go 也不会自动替你兜底。
var big int64 = 1234567890123
var small int8 = int8(big) // 溢出!结果不可预期
fmt.Println(small) // 输出什么?不确定!
这类问题常见于数据库字段缩小、协议字段压缩、结构体重构之后的强制转换。处理方法也很简单:转换之前先检查范围,别把“能编译”当作“没风险”。如果字段确实可能超界,就不要为了省空间而改用更小的类型。
int 在 32 位系统上不是无限安全
虽然今天大多数服务端都部署在 64 位系统上,但只要代码存在跨平台运行的可能,int 的平台相关特性就必须纳入考虑。
// 32位系统上,int最大是2147483647
var count int = 2147483647
count++ // 32位系统上会溢出!
如果你的计数值、累计量、业务编号有机会超过 2147483647,就不要继续依赖 int。这种场景里,直接换成 int64 才是更明确的表达。
JSON 里的 int64,还要留意前端精度
int64 在 Go 里没问题,不代表它到了 JSON 和 JavaScript 里也一定安全。只要数值超过 2^53 - 1,也就是约 9007 万亿,JavaScript 的 Number 就可能无法精确表示。
// 这种情况JavaScript可能会丢失精度(数值超过9007万亿时)
type User struct {
    ID int64 `json:"id"`
}

// 解决方法:用string传输
type User struct {
    ID int64  `json:"-"`
    IDStr string `json:"id"`
}
这也是为什么很多后端服务即使数据库字段是 BIGINT,在对外接口里仍会把 ID 作为字符串返回。这里的问题不在 Go,而在消费端的数值表示能力。如果你的接口要给浏览器、Node.js 或其他 JavaScript 环境使用,这一步需要提前确认。
一套够用的选择建议
如果不想每次都从头判断,可以直接按下面这套规则落地:
| 场景 | 推荐类型 | 理由 |
|---|---|---|
| 数组索引、循环计数器 | int | 与标准库一致,写法自然 |
| 普通业务数值(用户年龄、分数等) | int | 范围通常足够,使用方便 |
| 数据库 ID、主键 | int64 | 跨平台一致,避免范围隐患 |
| 时间戳 | int64 | 标准接口就是固定宽度 |
| 跨网络传输的数值 | int64 | 便于协议和存储保持一致 |
| 可能超过 21 亿的数值 | int64 | 避免 32 位环境下溢出 |
| 范围很小且规模很大的字段 | uint8/int8 | 可节省内存,但别过度优化 |
把这张表再压缩成一句话,其实就是:
- 默认写业务代码,用
int - 数据库、时间戳、跨平台数据,用
int64 - 只有在范围明确且收益明显时,才下探到
int8、uint8、int32这类具体类型
Go 的类型选择并不鼓励炫技,它更强调场景和表达是否匹配。能让调用方少做转换、能让字段语义更清楚、能让跨边界的数据更稳定,这样的类型选择通常就是对的。放到日常工程里,最实用的结论也很简单:绝大多数局部计算用 int,需要固定宽度时再用 int64。















