



在 Go 并发开发里,很多问题并不是“把数据发给谁”,而是“什么时候大家才能继续干活”。比如缓存尚未预热、资源暂时不可用、系统需要统一暂停一批 worker,这类需求如果用忙轮询实现,CPU 会被白白消耗;如果全部交给 channel,又常常会在广播通知和共享状态判断上变得绕。本文围绕 sync.Cond 的典型用法展开,先讲它解决的具体问题,再拆解固定使用模式,最后结合几个高频场景说明它何时值得优先选择。
什么是 sync.Cond
sync.Cond 是 Go 标准库提供的条件变量,用来协调一组 goroutine:当条件不满足时先挂起等待,等其他 goroutine 修改状态后再被唤醒继续执行。它通常和互斥锁一起使用,底层依赖共享状态加锁检查,因此很适合“围绕一个状态做等待和通知”的并发模型。
它的核心能力只有三个,但分别对应了最常见的等待控制动作:
Wait():当前 goroutine 进入等待,并在等待期间释放锁;被唤醒后会重新获取锁再继续执行。Signal():唤醒一个正在等待的 goroutine。Broadcast():唤醒全部等待中的 goroutine。
从职责上看,sync.Cond 不负责传递业务数据,它更像一个围绕共享条件运转的“等待闸门”。当你的问题核心是“状态到了没有”,它往往比单纯传消息更贴切。
为什么这类场景更适合 sync.Cond
忙轮询的问题不在代码短,而在一直空转
不少人最先写出的等待逻辑类似下面这样:
// 不推荐的方式:忙轮询
for !condition {
    // 空转,浪费CPU
}
// 条件满足后继续执行
这段代码的问题很直接:当 condition 一直不满足时,goroutine 会持续抢占 CPU 时间片,反复检查同一个条件。逻辑上它确实“在等”,但系统层面它并没有休眠,而是在不停做无效工作。等待时间越长,浪费越明显。
这类写法在低并发测试里不一定马上暴露问题,但一旦等待者变多,CPU 使用率会迅速抬高,调度开销也会随之增加。
channel 很强,但不一定适合“共享条件等待”
Go 的 channel 很适合传值、串联生产消费关系,或者构建简单的协程协作模型。但如果多个 goroutine 等待的是同一个共享状态,比如“系统从暂停切回运行”“资源池重新有空闲资源”“缓冲区由空变为非空”,用 channel 来拼出完整语义往往并不轻巧。
尤其在以下情况里,channel 会开始显得别扭:
- 多个 goroutine 需要等待同一个条件成立;
- 需要一次性广播通知全部等待者;
- 判断条件依赖共享状态,而不是某一条消息本身;
- 唤醒后还要重新检查状态是否真的满足。
sync.Cond 的优势在于“等待状态变化”
把这类问题交给 sync.Cond,模型会更自然:
- 不空转:等待中的 goroutine 会真正挂起,不继续消耗 CPU。
- 通知直接:条件变化后可以按需用
Signal()或Broadcast()唤醒。 - 状态驱动:等待与唤醒都围绕同一份共享状态展开,代码结构更稳定。
因此,sync.Cond 并不是 channel 的替代品,而是针对“等待条件成立”这一类问题的专门工具。
正确使用 sync.Cond 的固定模式
sync.Cond 的代码形式看起来不复杂,但它有一套比较固定的使用模式,偏离这个模式就很容易出错。
// 等待方
cond.L.Lock()
for !condition {
    cond.Wait() // Wait()内部会释放锁,并在唤醒后重新获取锁
}
// 此时条件已满足,可以安全地操作共享资源
cond.L.Unlock()

// 通知方
cond.L.Lock()
condition = true // 修改共享状态
cond.Signal()    // 或 cond.Broadcast()
cond.L.Unlock()
第一条:调用 Wait() 之前必须已经持锁
Wait() 不是随时都能调用。进入等待前,当前 goroutine 必须先持有 cond.L 对应的锁。这样 sync.Cond 才能保证“检查条件、进入等待、被唤醒后重新检查条件”这一整套过程是受保护的。
Wait() 内部会先释放这把锁,让其他 goroutine 有机会修改共享状态;等被唤醒后,它又会重新拿回这把锁,再让后续代码继续执行。
第二条:一定要用 for 检查条件,不要写成 if
很多错误都出在这里。等待逻辑必须写成:
for !condition {
    cond.Wait()
}
而不是:
if !condition {
    cond.Wait()
}
原因在于 goroutine 即使被唤醒了,也不代表它此刻就一定满足继续执行的条件。可能是发生了虚假唤醒,也可能是多个等待者同时被唤醒,但真正可用的状态只够其中一部分使用。用 for 重新检查条件,才能把这类并发竞争收回来。
第三条:先改状态,再发通知
通知方的顺序同样重要。应当先更新共享状态,再调用 Signal() 或 Broadcast()。如果顺序反过来,等待方被叫醒后可能看到的还是旧状态,结果又会重新睡回去,甚至引入难以排查的时序问题。
这也是为什么 sync.Cond 总是和锁绑在一起使用:它要保证状态变更与通知动作之间的关系是明确的。
实战示例:短信发送系统的暂停与恢复
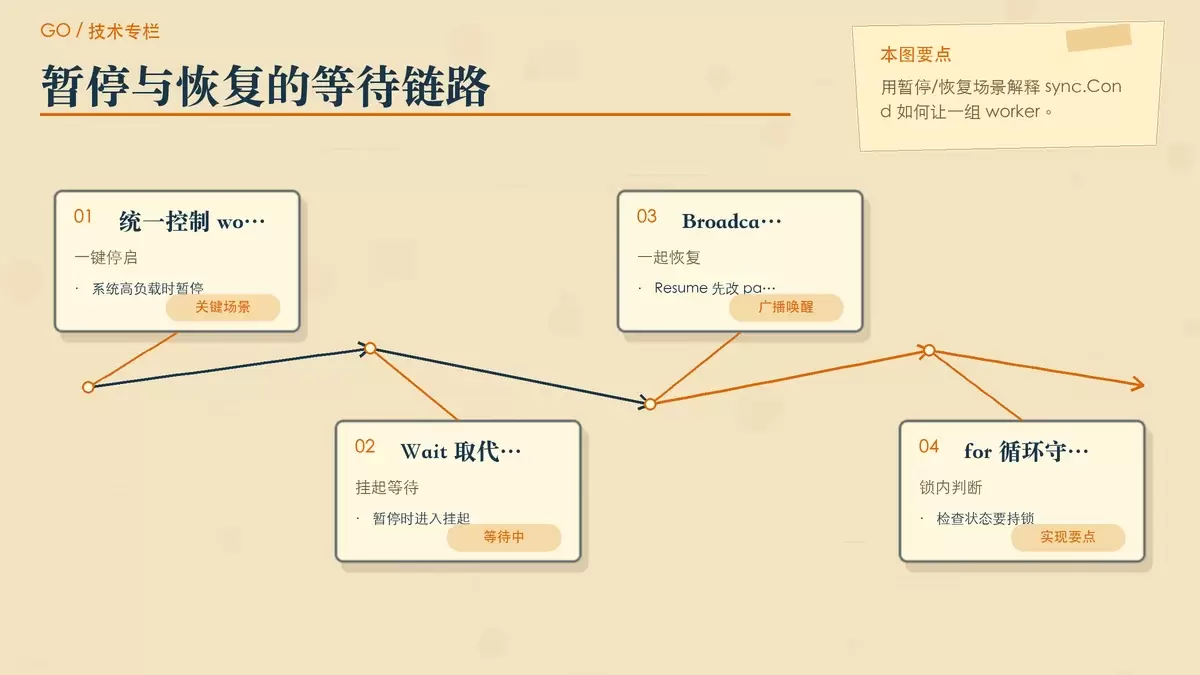
一个很典型的业务场景是“统一暂停和统一恢复”。假设有一批发送短信的 worker 正在工作,当系统负载过高或外部依赖异常时,需要马上让它们停下来;问题解除后,再把所有 worker 一起恢复。
为什么忙轮询不适合这个场景
先看一个常见但不合适的写法:
// worker代码片段
for {
    if paused {
        continue // 疯狂循环,CPU飙升
    }
    // 发送短信...
}
这里的 paused 确实能表达“暂停”状态,但一旦暂停发生,worker 会在 continue 这条分支上反复空转。worker 越多,CPU 被浪费得越明显。对于本来就处在高负载下的系统,这种实现等于进一步放大问题。
用 sync.Cond 改造后的实现
type SMSManager struct {
    mu     sync.Mutex
    cond   *sync.Cond
    paused bool
}

func NewSMSManager() *SMSManager {
    sm := &SMSManager{}
    sm.cond = sync.NewCond(&sm.mu)
    return sm
}

func (sm *SMSManager) Pause() {
    sm.mu.Lock()
    sm.paused = true
    sm.mu.Unlock()
}

func (sm *SMSManager) Resume() {
    sm.mu.Lock()
    sm.paused = false
    sm.cond.Broadcast() // 唤醒所有等待的goroutine
    sm.mu.Unlock()
}

func (sm *SMSManager) Worker(id int) {
    for {
        sm.mu.Lock()
        for sm.paused {
            sm.cond.Wait() // 等待时释放锁,唤醒时重新获取
        }
        sm.mu.Unlock()

        // 发送短信...
    }
}
这段实现的关键点有两个。
第一,worker 并不是在 paused == true 时忙等,而是在持锁检查后进入 Wait()。这意味着暂停期间它们会真正休眠,不继续消耗 CPU。
第二,Resume() 里使用的是 Broadcast(),因为这里要恢复的是“一批等待中的 worker”,不是只放行一个。共享状态 paused = false 设置完成后,再统一广播,所有等待者都会醒来并重新检查条件,确认系统已经恢复后继续工作。
对于这种“同一个开关影响多个 goroutine”的需求,sync.Cond 的表达会比 channel 更顺手,也更接近业务本身。
另外两个高频场景:有界队列与资源池
生产者-消费者:适合做有界队列
sync.Cond 很适合生产者-消费者模型,尤其是你不只是想“传数据”,还想控制缓冲区上下界的时候。
type BoundedQueue struct {
    items   []interface{}
    cond    *sync.Cond
    maxSize int
}

func (q *BoundedQueue) Put(item interface{}) {
    q.cond.L.Lock()
    for len(q.items) >= q.maxSize {
        q.cond.Wait() // 队列已满,等待
    }
    q.items = append(q.items, item)
    q.cond.Signal() // 唤醒一个消费者
    q.cond.L.Unlock()
}

func (q *BoundedQueue) Get() interface{} {
    q.cond.L.Lock()
    for len(q.items) == 0 {
        q.cond.Wait() // 队列为空,等待
    }
    item := q.items[0]
    q.items = q.items[1:]
    q.cond.Signal() // 唤醒一个生产者
    q.cond.L.Unlock()
    return item
}
这里的重点不是替代 channel,而是把“队列已满”和“队列为空”这两种状态等待明确建模出来。生产者在满队列时挂起,消费者在空队列时挂起,一旦状态改变,再唤醒对应的一侧继续处理。对于需要额外调度策略的队列,这种方式会更灵活。
资源池管理:资源不足时等待,而不是抢空转
管理数据库连接、工作线程或其他有限资源时,也经常会遇到“资源暂时没有,但稍后会归还”的情况。此时等待方最需要的是阻塞等待,而不是自己反复探测。
type ResourcePool struct {
    resources chan interface{}
    cond      *sync.Cond
    maxSize   int
}

func (p *ResourcePool) Get() interface{} {
    p.cond.L.Lock()
    for len(p.resources) == 0 {
        p.cond.Wait() // 等待资源可用
    }
    resource := <-p.resources
    p.cond.L.Unlock()
    return resource
}
这个例子体现的是同一类思想:请求资源的 goroutine 先检查共享状态,资源为空就等待;一旦有资源释放回来,再通知等待者继续获取。它的核心收益仍然是避免无意义的竞争和空转。
怎么选:sync.Cond 还是 channel
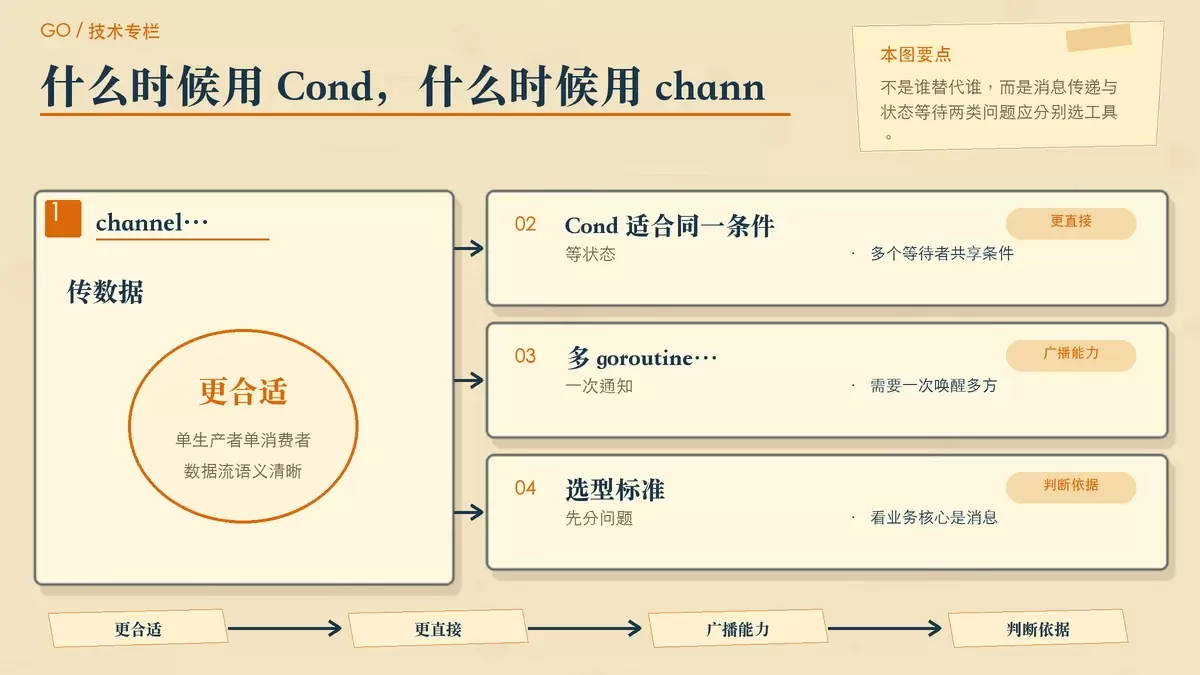
实际开发里,这两者并不是谁“更高级”的关系,而是解决问题的切入点不同。
| 场景 | 推荐方式 | 理由 |
|---|---|---|
| 单个生产者和单个消费者 | Channel | 代码更简洁,语义更清晰 |
| 多个消费者等待同一个条件 | sync.Cond | 更高效,避免创建多个channel |
| 需要广播通知多个goroutine | sync.Cond | 直接使用Broadcast(),避免复杂channel操作 |
| 状态驱动的事件等待 | sync.Cond | 更灵活,适合复杂的条件判断 |
可以把选择标准压缩成一句话:需要传数据,优先看 channel;只需要围绕共享状态做等待和通知,优先考虑 sync.Cond。
如果你的业务重点是消息流转,channel 往往更自然;如果重点是“某个条件何时成立”,并且可能有多个等待者,sync.Cond 通常会更直接。
使用时最该记住的几个判断
sync.Cond 在 Go 并发工具里不算最常被提起的那个,但它非常适合处理状态驱动的等待问题。只要场景中出现“多个 goroutine 围绕同一共享条件等待”“需要统一唤醒”“希望等待期间不浪费 CPU”这些信号,就值得优先考虑它。
真正落地时,最重要的是守住三条规则:Wait() 前先持锁、等待条件必须用 for 检查、通知前先修改共享状态。把这三个动作写对,sync.Cond 就能在暂停恢复、队列调度、资源池管理这类场景里发挥出很高的效率和可读性。















