



很多 Go 开发者都用过 gofmt、IDE 报错提示和各种 linter,却不一定清楚它们是如何“看懂”代码的。关键入口通常就是 go/ast:先把源码解析成结构化语法树,再围绕节点做检查、生成或转换。看完这篇,你可以快速判断 AST 在 Go 工具链里的位置,也能知道自己写一个简单分析器时该从哪里下手。
什么是抽象语法树
当编译器读取 Go 代码时,它不会只把源码当作一串普通文本处理,而是先解析出语法结构。这个结构化结果就是抽象语法树,也就是 AST。
可以把 AST 理解成代码的“结构图”。它保留函数声明、变量定义、表达式、赋值关系这类真正影响程序含义的部分,弱化空白、排版等不影响语义的细节。对于工具开发来说,这意味着你不必自己靠字符串规则硬拆代码,而是可以直接在语法层面定位目标。
例如代码 x = a + b,在 AST 中通常不会被视作一整行文本,而会拆成赋值节点、标识符节点和表达式节点。这样一来,工具就能知道“这是一次赋值”,以及“右侧是一个加法表达式”,而不是只看到几个字符拼在一起。
也正因为如此,AST 才能成为格式化、静态检查、代码生成和编辑器能力的共同基础。
`ast` 包能做什么
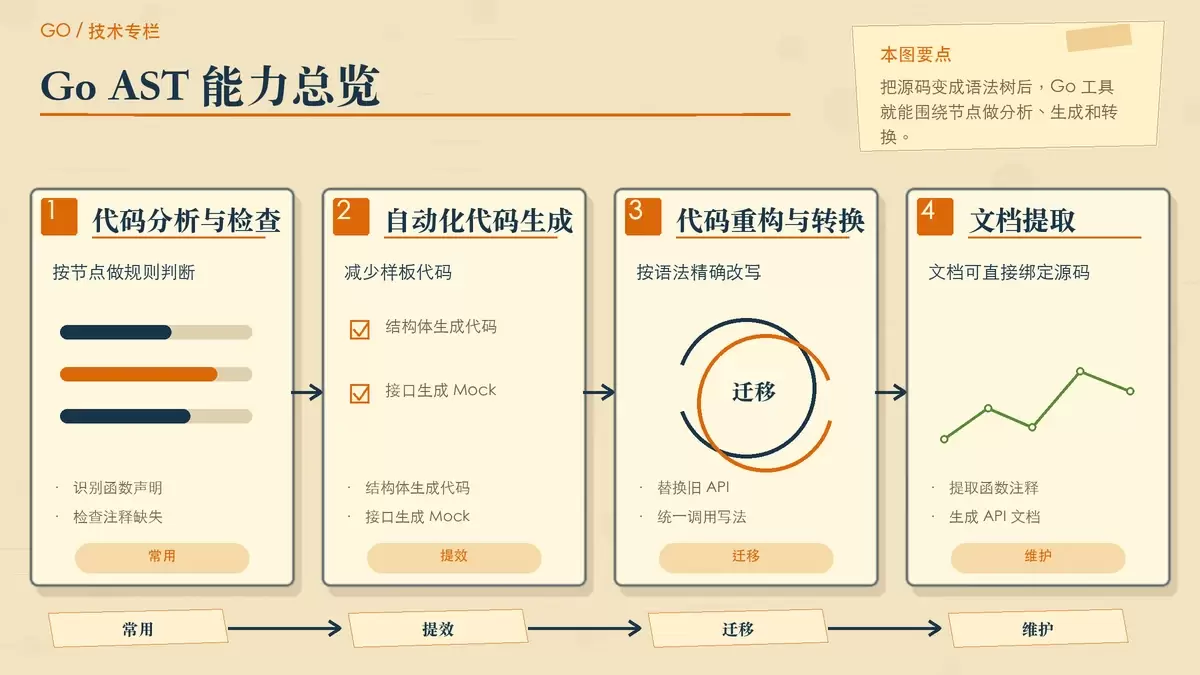
代码分析与检查
AST 最直接的用途,就是扫描代码结构并做规则判断。比如检查所有函数是否带有注释:
ast.Inspect(file, func(n ast.Node) bool {
    if fn, ok := n.(*ast.FuncDecl); ok {
        if fn.Doc == nil {
            fmt.Printf("函数 %s 缺少注释n", fn.Name.Name)
        }
    }
    return true
})
这类检查很适合团队规范落地。相比正则或文本匹配,AST 能明确识别“函数声明”节点,误报会少很多。
再进一步,AST 还能用来发现潜在 bug。原文提到的典型场景是“错误未处理”:在 Go 里忽略 error 是常见问题,很多团队会基于 AST 写自定义 linter,专门检查这类风险。文中给出的经验是,这样的规则曾帮助团队减少了 30% 的线上错误。
自动化代码生成
如果你已经有了结构定义,AST 还可以帮你反向生成代码。常见场景包括:
- 根据结构体自动生成 JSON 序列化和反序列化逻辑
- 根据接口定义自动生成 Mock 代码
- 围绕既有类型批量生成辅助方法
Go 里的 stringer 就是很有代表性的例子。它会读取类型定义,再生成枚举值对应的字符串转换函数。开发者不需要手写重复样板,工具可以直接按语法信息产出稳定结果。
代码重构与转换
当项目要迁移旧 API、批量替换调用方式,或者统一某种写法时,AST 的价值会非常明显。因为你操作的不是纯文本,而是可识别的语法节点,所以可以更精确地修改目标结构。
这类思路也体现在 gofmt 上。虽然它的目标是格式化,但本质上也是围绕代码结构输出统一风格的结果。换句话说,格式化不是简单“排版”,而是基于语法理解后的标准化输出。
文档提取
AST 还适合做文档提取。通过遍历函数声明节点,可以拿到每个函数的注释、名称以及相关结构信息,再据此生成 API 文档或内部索引。
对需要维护公共库、服务接口或团队内部组件的项目来说,这种做法很实用:文档来源直接绑定源码,更新成本更低,也更不容易脱节。
如何开始使用 `ast` 包
基本流程
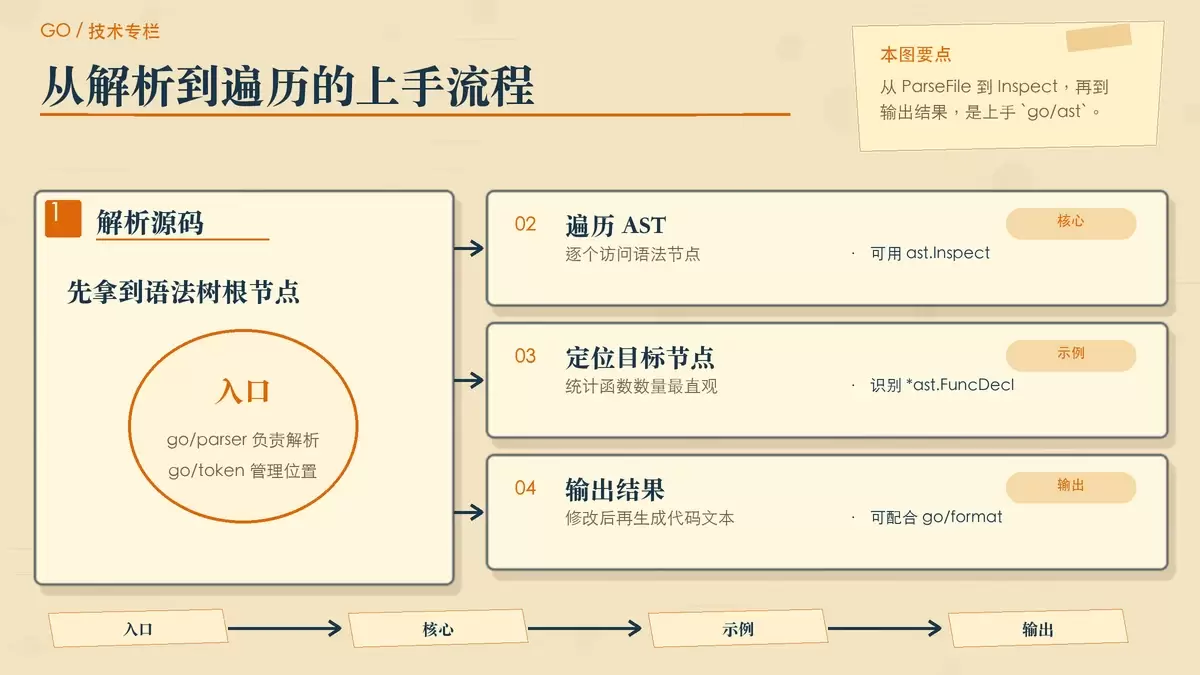
使用 go/ast 的入口并不复杂,通常可以按下面 5 步走:
- 导入必要包:
go/ast、go/parser和go/token - 解析代码:使用
parser.ParseFile解析 Go 文件,拿到 AST 根节点 - 遍历 AST:使用
ast.Inspect,或实现ast.Visitor接口逐个访问节点 - 分析和修改:根据节点类型判断需要检查或转换的内容
- 输出结果:如果做了修改,再用
go/format或go/printer输出回代码文本
其中最常见的组合是:parser.ParseFile 负责把源码变成树,ast.Inspect 负责遍历这棵树,token.FileSet 负责管理位置信息。
简单示例:统计函数数量
下面这个示例演示如何解析一个 Go 文件,并统计其中出现了多少个函数声明:
package main

import (
    "go/ast"
    "go/parser"
    "go/token"
    "log"
)

func main() {
    // 1. 解析代码文件
    fileSet := token.NewFileSet()
    src := `
package example

func add(a, b int) int {
    return a + b
}

func main() {
    // 主函数逻辑
}
`
    file, err := parser.ParseFile(fileSet, "input.go", src, parser.ParseComments)
    if err != nil {
        log.Fatalf("解析失败: %v", err)
    }

    // 2. 遍历统计函数数量
    var funcCount int
    ast.Inspect(file, func(node ast.Node) bool {
        if _, ok := node.(*ast.FuncDecl); ok {
            funcCount++
        }
        return true
    })
    log.Printf("函数总数: %d", funcCount)
}
这段代码的核心很直接:
token.NewFileSet()创建文件位置集合parser.ParseFile(...)解析源码,得到fileast.Inspect递归遍历所有节点- 遇到
*ast.FuncDecl时计数加一
如果你准备写自己的检查器,这个例子就是最典型的起点:先识别你关心的节点类型,再在遍历过程中加入判断逻辑。
使用时的几个注意点
go/ast 虽然好用,但第一次上手时通常会卡在几个地方。
AST 结构比想象中更细
很多初学者第一次看到节点类型会觉得杂,因为一个看似简单的语句,往往会被拆成多层结构。实践上最有效的办法,是先把解析结果打印出来,观察节点组织方式,再决定从哪一层入手遍历。
位置信息要通过 FileSet 换算
节点上的位置信息不是直接可读的行号。要拿到具体位置,通常需要配合 fset.Position(node.Pos())。如果你要做报错提示、规则告警或精确定位,这一步基本绕不开。
修改 AST 不等于直接改源码
AST 是源码的结构表示,不是源码文本本身。即使你在树上改了节点,最后仍然需要借助 printer.Fprint 或其他输出工具,把修改后的结构重新打印回代码。
这也是很多人刚开始容易误解的一点:解析、遍历、修改、输出,实际上是几个独立阶段。
外部依赖不会在 AST 中自动展开
如果代码引用了外部包,AST 里保留的是引用关系,而不会把外部包内部实现一起展开出来。也就是说,AST 很适合处理“当前源码文件写了什么”,但不等于自动获得整个依赖世界的完整语义。
为什么值得尽早理解 `go/ast`
从代码规范检查到自动化重构,从生成样板代码到提取文档,很多 Go 工具的底层能力都离不开 AST。理解 go/ast,并不只是为了写一个分析脚本,更重要的是它会让你更清楚 Go 工具链到底是如何理解源码的。
如果你准备做自定义 linter、内部代码生成器,或者想把一批重复劳动工具化,AST 往往就是最合适的入口。它不能替你做设计判断,但能把大量机械、易错、重复的工作稳定地自动化下来。















