



写 Go 并发代码时,很多人第一次遇到 close(ch) 后继续读取,都会被结果弄糊涂:为什么前两次能拿到值,后面却突然变成 0?这其实不是异常行为,而是 Go 对 channel 关闭后的明确语义。下面就从实验结果、读取规则到实战写法,梳理清楚关闭 channel 之后到底还能不能读、应该怎么判断、哪些地方最容易踩坑。
先看一个最容易混淆的例子
先直接看一段代码:
package main

import "fmt"

func main() {
    ch := make(chan int, 3)  // 创建缓冲大小为3的channel
    ch <- 1
    ch <- 2
    close(ch)  // 关闭channel

    fmt.Println(<-ch)  // 输出:1
    fmt.Println(<-ch)  // 输出:2
    fmt.Println(<-ch)  // 输出:0
}
这段程序的结果很有代表性:前两次读取拿到了已经写入的 1 和 2,第三次读取拿到的是 0。
关键点在于,关闭 channel 不等于立刻清空其中的数据。如果 channel 里还有已经发送但尚未被接收的值,接收方仍然可以继续把这些值读出来。只有当这些剩余数据都被消费完,后续读取才会直接返回该元素类型的零值。对 int 来说,零值就是 0。
关闭后还能怎么读:规则其实很明确
Go 对“从已关闭 channel 读取”这件事给了非常稳定的保证:这是安全的,不会 panic。
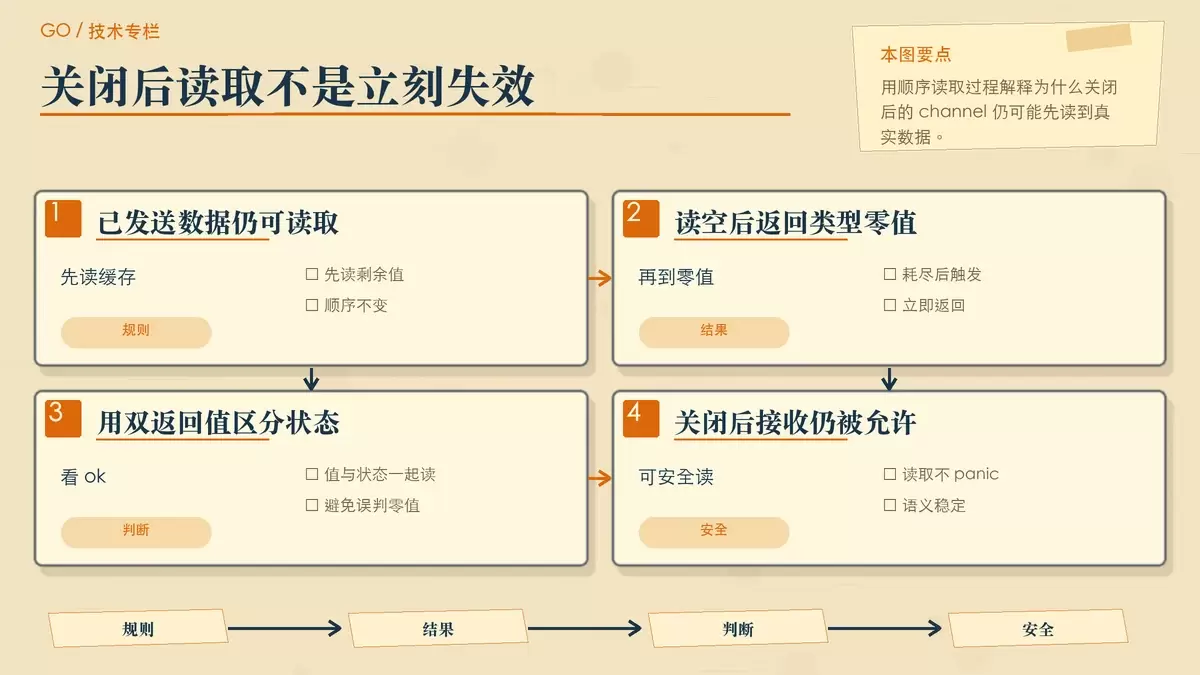
实际行为可以概括成三条:
- 如果 channel 中还有未读出的数据,就先按正常顺序读完它们。
- 当缓冲区里的数据全部读完后,再继续读取,会立刻返回元素类型的零值。
- 如果你需要区分“读到的是有效数据”还是“channel 已经关闭且数据耗尽”,就要使用双返回值形式。
也就是这类写法:
ch := make(chan int, 3)
ch <- 1
ch <- 2
close(ch)

// 安全读取
for {
    if value, ok := <-ch; ok {
        fmt.Println("读取到值:", value)
    } else {
        fmt.Println("Channel已关闭")
        break
    }
}
这里的 ok 很重要:
ok == true:说明这次读取拿到的是有效发送值。ok == false:说明 channel 已关闭,而且已经没有剩余数据可读了。
这也是为什么单看返回值本身不够可靠。因为如果元素类型本来就可能出现零值,比如 0、""、false 或 nil,你无法仅靠这个值判断它到底是业务数据,还是关闭后返回的默认结果。
有缓冲和无缓冲,表现差别在哪里
这个问题最容易在缓冲与非缓冲 channel 上混在一起看,因此需要分开理解。
有缓冲 channel
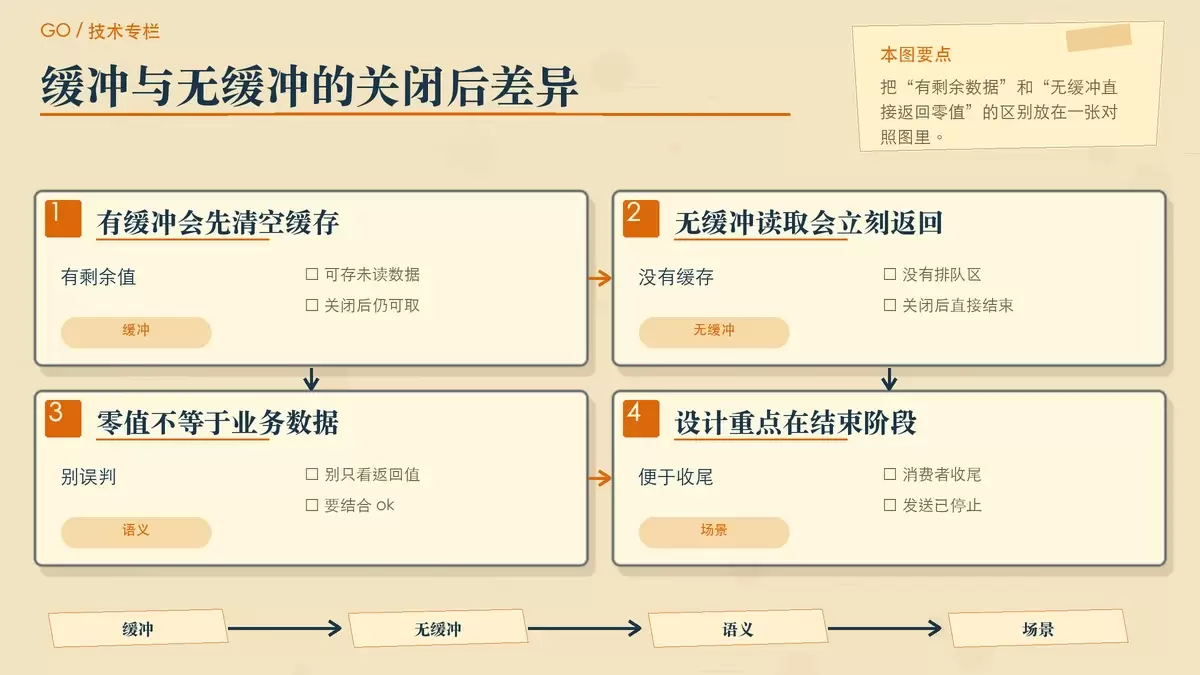
有缓冲 channel 会保留已经写入但尚未取走的数据,所以它关闭后的行为通常是:
- 先读出缓冲区里还没消费的值。
- 全部读完后,再返回零值和
false。
前面的示例正是这种情况。ch := make(chan int, 3) 创建了一个容量为 3 的缓冲 channel,写入了两个值后再关闭,因此接收方还可以把这两个值正常读走。
无缓冲 channel
无缓冲 channel 没有“排队等待读取”的缓冲区。也就是说,如果它已经关闭,再去读时就不会存在“先把缓存读完”这一步,而是会直接返回该类型的零值,并且 ok 为 false。
因此,很多人以为“关闭后读取一定得到零值”,这个说法只在没有剩余数据可读时才成立;对于有缓冲 channel,它往往要先把已有数据读完。
为什么 Go 要这样设计,以及开发中该怎么写
Go 没把“读取已关闭 channel”设计成 panic,主要是为了让并发通信更可控,也更适合生产者和消费者之间的收尾过程。
1. 让接收方能安全收尾
发送方向 channel 写完数据后关闭它,接收方仍然可以继续把剩余数据处理完。这种语义非常适合“生产结束,但积压任务还要继续消费”的场景。
如果关闭后就完全不能读,那么消费者还得额外处理一套结束逻辑,代码会复杂很多,也更容易遗漏收尾步骤。
2. 支持更自然的遍历方式
Go 专门为 channel 提供了 for...range 这种写法,用来持续接收数据直到 channel 关闭且数据耗尽:
// 优雅的遍历方式
for value := range ch {
    fmt.Println(value)
}
// 当ch关闭后,循环会自动退出
这类写法之所以成立,正是因为“关闭后仍可读取剩余值”这一规则存在。接收方不用自己判断每次读取后的细节,只要发送方在合适时机关闭 channel,循环就能自然结束。
3. 但发送到已关闭 channel 仍然会 panic
这里要特别区分两件事:
- 从已关闭 channel 读取:安全,不会 panic。
- 向已关闭 channel 发送:会 panic。
这也是 channel 使用里最容易记混的一点。读取被设计成可收尾、可探测状态;发送则被严格限制,避免程序在错误状态下继续投递数据。
4. 实际开发中的几个建议
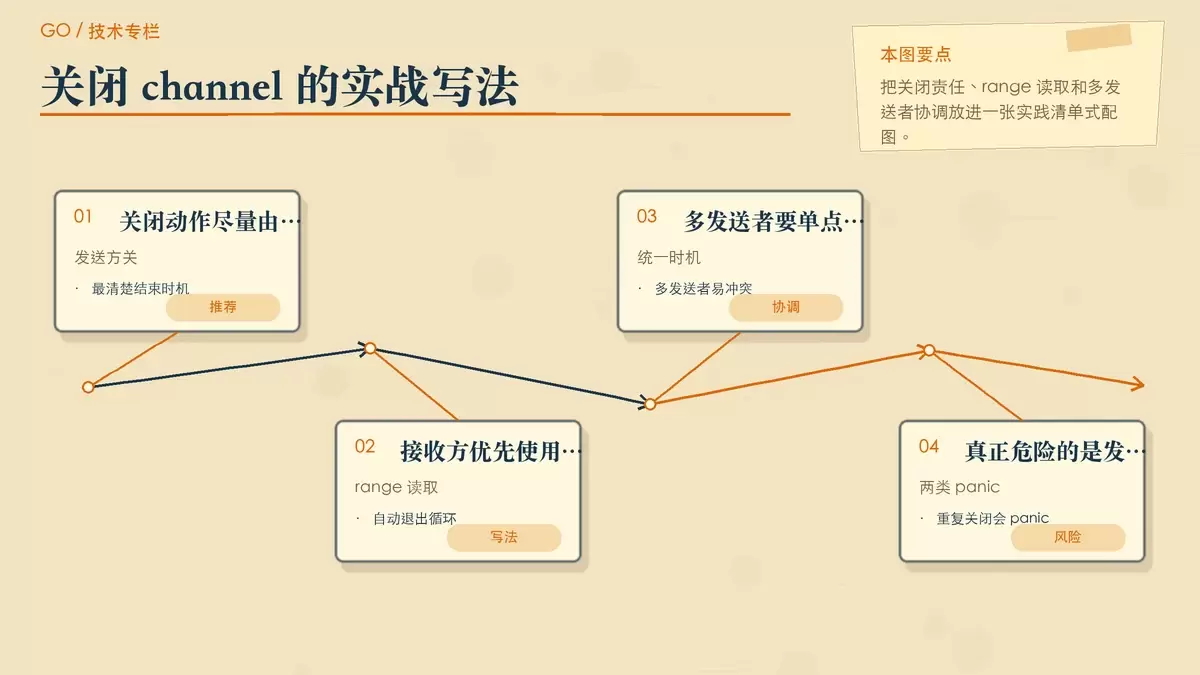
- 尽量由发送方关闭 channel。谁负责发送完成,谁通常就最清楚何时应该结束。
- 优先使用
for...range接收。它比手写死循环更简洁,也更不容易漏掉退出条件。 - 需要显式判断关闭状态时,用
value, ok := <-ch。特别是在零值本身也可能是合法数据时,这一步不能省。 - 多发送者场景要协调关闭时机。这时通常要借助专门的信号 channel 或
sync.Once,避免重复关闭。 - 不要重复关闭同一个 channel,否则同样会触发 panic。
最后把结论说清楚
回到最初的问题:Go 语言里,关闭的 channel 还能不能读数据?
答案是能,但要分阶段理解:
- 如果 channel 中还有已经发送但尚未读取的数据,仍然可以正常读出。
- 当这些数据读完后,继续读取会立即返回元素类型的零值。
- 要判断是否真的已经关闭且无数据可读,应使用
value, ok := <-ch。
把这几条规则搞清楚后,你再看关闭 channel 的行为就不会觉得反直觉了。它本质上不是“通道彻底失效”,而是“停止继续发送,同时允许接收方把剩余内容处理完”。这也是 Go 并发模型里非常实用的一部分。















