



在 Go 项目里,读取文件、日志和标准输入几乎是绕不开的基础操作。相比手动处理缓冲区或直接拼接读取逻辑,bufio.Scanner更适合承担“稳定扫描文本流”这件事。下面从它解决的问题、基本写法、缓冲区边界到典型场景逐步展开,帮助你判断它什么时候最省事,什么时候又该提前调整配置。
为什么很多文本读取场景更适合用 bufio.Scanner
Go 里并不缺读取输入流的办法,比如直接用 os 包读取,或者使用 bufio.Reader 的 ReadLine。但一旦进入真实项目,这些方案往往会把复杂度留给调用方:要自己处理缓冲区,要考虑长行输入是否溢出,还得兼顾不同平台下的换行符差异。
bufio.Scanner就是为这类“按单元扫描输入流”的任务准备的。它从 Go 1.1 开始进入标准库,优势很明确:API 短、默认行为清晰、对常见边界情况有内建处理,尤其适合逐行读取、按词拆分和流式文本处理。
如果你的目标是按顺序消费输入,而不是一次性把整个文件读入内存,Scanner 通常是更稳妥的起点。
基础用法:按行扫描、及时退出、统一收尾
bufio.Scanner最常见的使用方式是逐行读取。它的控制流很固定:创建实例、循环调用 Scan()、在循环内取值、结束后检查 Err()。
// 创建Scanner实例
scanner := bufio.NewScanner(os.Stdin)

// 逐行读取
for scanner.Scan() {
    line := scanner.Text()
    // 处理每一行内容
    if line == "." {
        break // 终止条件
    }
    fmt.Println("读取到:", line)
}

// 检查错误
if err := scanner.Err(); err != nil {
    log.Fatal("读取错误:", err)
}
这段模式之所以值得作为默认写法,不是因为它“看起来简洁”,而是因为它把输入处理拆成了三个清晰步骤:
- 用
Scan()推进读取过程; - 用
Text()取得当前扫描结果; - 在循环结束后统一通过
Err()判断是正常结束还是扫描失败。
如果中途需要业务终止条件,比如遇到某一行就退出,直接在循环中 break 即可。这样的结构在命令行工具、REPL 式输入处理和日志消费程序里都很常见。
三个关键点:换行处理、分割方式与缓冲区上限
自动兼容不同行终止符
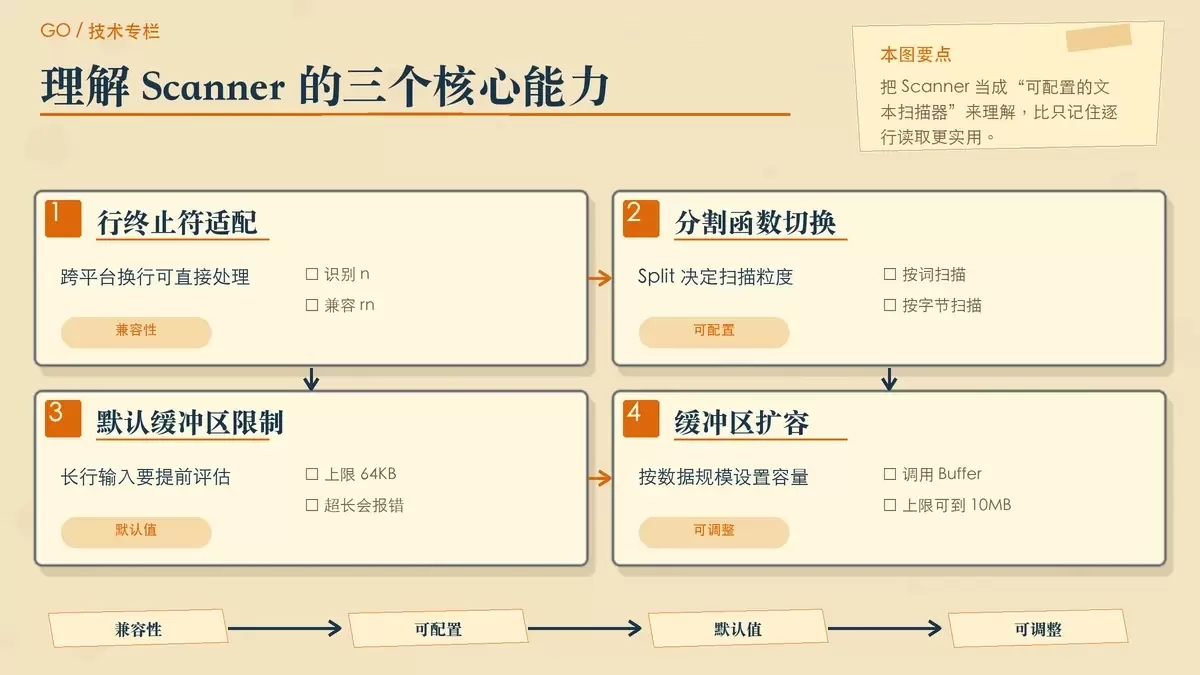
文本处理里一个很常见、但又容易被忽略的问题,是不同系统的换行格式。Unix 常见的是 n,Windows 常见的是 rn。Scanner 会处理这类差异,因此同一段逐行扫描逻辑通常可以直接跨平台复用,不需要额外为换行符写兼容分支。
不只是按行,还可以按词或按字节扫描
很多人第一次接触 Scanner,只把它当成“逐行读取器”。其实它更准确的定位是“可配置分割规则的扫描器”。除了默认的按行分割,还可以切换到按单词、按字节,或者使用自定义分割函数。
// 按单词分割
scanner.Split(bufio.ScanWords)

// 按字节分割
scanner.Split(bufio.ScanBytes)

// 自定义分割函数
scanner.Split(customSplitFunc)
这意味着它不仅适合普通文本文件,也能处理更结构化的输入。例如,按空白符提取字段、逐字节消费协议数据、或对特殊分隔符格式做轻量解析,都可以围绕 Split 展开。
默认 64KB 上限需要提前留意
Scanner 有一个非常实际的限制:默认最大 token 大小是 64KB。对普通日志、配置文件和命令行输入来说,这通常够用;但遇到超长日志行、单行 JSON、压缩后展开的大字段内容时,就可能直接报错。
这时应当尽早设置缓冲区,而不是等线上数据打进来后再排查:
scanner.Buffer(make([]byte, 1024), 10*1024*1024) // 提升最大支持到10MB这里要注意两件事:一是初始缓冲区大小可以比较保守,二是最大容量要根据输入特点来定。设得过小会中断扫描,设得过大则可能放大内存占用。它不是越大越好,而是要和数据分布匹配。
哪些场景用它最顺手
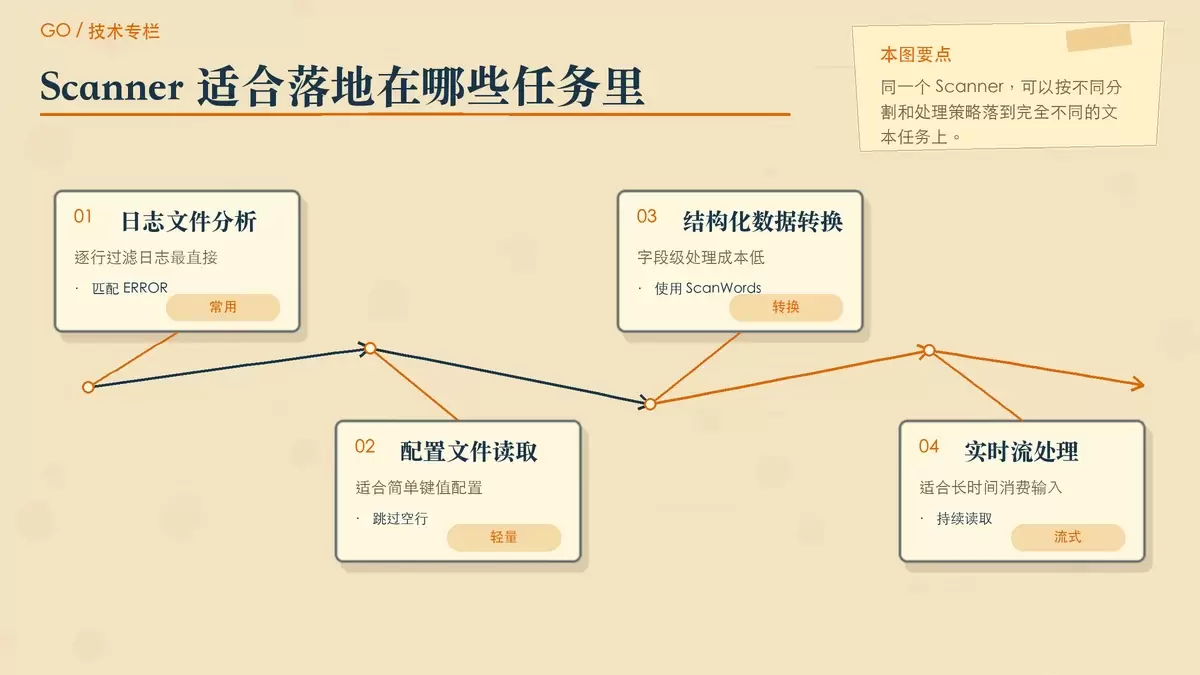
日志文件分析
日志处理是 Scanner 的典型用武之地。按行读取后,可以很自然地做过滤、计数和字段提取:
// 伪代码:分析日志中的错误信息
scanner := bufio.NewScanner(logFile)
errorCount := 0

for scanner.Scan() {
    line := scanner.Text()
    if strings.Contains(line, "ERROR") {
        errorCount++
        // 提取错误详情并记录
    }
}
// 输出错误统计报告
这种写法的好处是处理流程直观,适合边读边算,不需要先把整个日志文件载入内存。对批量分析任务尤其友好。
配置文件读取
读取简单键值配置时,Scanner 也很合适。因为逐行扫描天然方便跳过空行、注释和格式噪声:
// 伪代码:读取键值对配置
scanner := bufio.NewScanner(configFile)
config := make(map[string]string)

for scanner.Scan() {
    line := strings.TrimSpace(scanner.Text())
    if line == "" || strings.HasPrefix(line, "#") {
        continue // 跳过空行和注释
    }
    // 解析键值对并存储到config
}
当配置格式不复杂时,这种方式通常比引入额外解析器更轻,维护成本也更低。
结构化数据转换
如果输入本身以空白符分隔,切换到 bufio.ScanWords 后就能直接做字段级处理:
// 伪代码:读取并转换数据格式
scanner := bufio.NewScanner(dataFile)
scanner.Split(bufio.ScanWords) // 按单词分割
var numbers []int

for scanner.Scan() {
    // 将文本转换为整数或其他数据类型
    num, err := strconv.Atoi(scanner.Text())
    if err == nil {
        numbers = append(numbers, num)
    }
}
这类用法很适合做轻量的数据清洗、导入预处理和命令行输入转换。它未必能替代完整 parser,但在规则简单的情况下,足够高效。
实时流式处理
Scanner 也适合持续消费输入流,例如管道输入、实时采集流或长连接来源的数据:
// 伪代码:处理实时数据流
scanner := bufio.NewScanner(streamSource)

for scanner.Scan() {
    data := scanner.Text()
    // 实时处理数据并输出结果
    processed := processData(data)
    fmt.Println(processed)
}
这种模式的关键价值在于“读到一段、处理一段、输出一段”。如果业务不要求回看全部历史数据,Scanner 的流式特性能显著降低实现复杂度。
性能判断与实践建议
bufio.Scanner的性能基础来自缓冲机制。与无缓冲读取相比,它会尽量把更多数据读入内部缓冲区,再由扫描逻辑分段消费,从而减少系统调用次数。这也是它在大文件处理和流式输入场景里表现稳定的原因之一。
不过,性能并不只是“用了缓冲就一定快”。在工程实践中,更值得注意的是下面几条:
- 扫描结束后始终检查
scanner.Err():否则你可能把异常中断误判为正常读完。 - 对长行输入提前调用
Buffer:不要等默认 64KB 限制触发后再补救。 - 处理文件时记得资源清理:配合
defer关闭文件,避免句柄泄漏。 - 能用
scanner.Bytes()时就别急着转字符串:如果后续逻辑不需要字符串,直接处理字节切片可以减少一次不必要的分配。
最后可以给出一个实用判断:如果你处理的是文本流,消费模式清晰,且希望代码尽量短而稳,优先考虑 bufio.Scanner;如果你面对的是超长记录、复杂协议或需要更细粒度控制的读取过程,再评估是否切换到 bufio.Reader 等更底层方案。
把它用对位置,Scanner 往往就是 Go 文本处理里最省心的一层抽象。















