


Python字符串处理实战:8种核心操作详解

本文系统介绍Python中8种常用的字符串操作方法,涵盖拼接、长度计算、截取、分割、检索、大小写转换、去空格及格式化输出。通过具体语法格式与代码示例,详解各方法的参数使用与注意事项,帮助开发者高效处理文本数据。
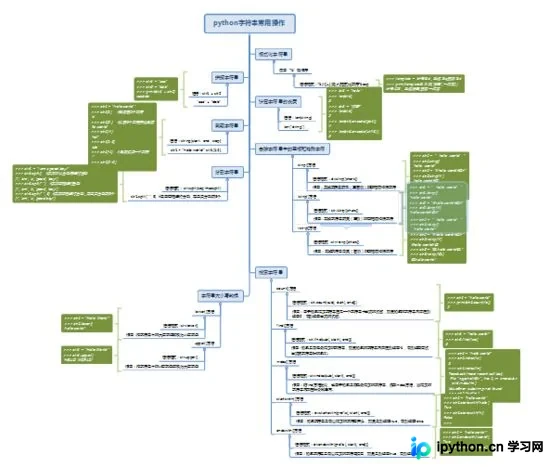
字符串拼接与长度计算
字符串拼接
在Python中,可以使用加号(+)运算符将多个字符串连接在一起。
其基本语法为:str1 + str2
>>> str1 = "aaa"
>>> str2 = "bbb"
>>> print(str1 + str2)
aaabbb
需要特别注意的是,字符串类型不能直接与数值等其他类型进行拼接操作。例如,尝试将字符串与整数相加会引发错误。
>>> num = 100
>>> str1 = "hello"
>>> print(str1 + num)
Traceback (most recent call last):
 File "<pyshell#5>", line 1, in <module>
 print(str1 + num)
TypeError: can only concatenate str (not "int") to str
针对上述情况,可以先将数值类型转换为字符串类型,然后再进行拼接操作。
>>> num = 100
>>> str1 = "hello"
>>> print(str1 + str(num))
hello100
经过类型转换后,程序即可正常运行而不会报错。
计算字符串长度
Python提供了内置函数len()用于获取字符串的长度。
语法格式为:len(string)
>>> str1 = "hello"
>>> len(str1)
5
>>> str2 = "你好"
>>> len(str2)
2
>>> str3 = "1111"
>>> len(str3)
4
从运行结果可以看出,在默认情况下,len()函数计算字符串长度时,无论是数字、字母还是多字节汉字,均被视为一个字符单位。
之所以称为“默认情况”,是因为在实际开发中,由于编码方式的不同,字符串实际占用的字节数也会有所差异。
- 在UTF-8编码下,一个汉字通常占用3个字节。
- 而在GBK或GB2312编码下,一个汉字通常占用2个字节。
若需获取字符串在特定编码下的字节长度,可以先使用encode()方法对字符串进行编码,再计算其长度。
具体示例如下:
>>> str1 = "你好"
>>> len(str1)
2
>>> len(str1.encode('gbk'))
4
>>> len(str1.encode('utf-8'))
6
字符串截取与分割技巧
字符串截取
Python中字符串截取的语法格式为: string[start : end : step]
参数说明如下:
- string:表示需要被截取的原始字符串。
- start:指定截取起始位置的索引(包含该位置字符)。若未指定,默认从索引0开始。
- end:指定截取结束位置的索引(不包含该位置字符)。若未指定,默认截取至字符串末尾。
- step:定义切片步长。若省略,默认值为1;当省略步长时,末尾的冒号也可一并省略。
>>> str1 = "hello world!"
>>> str1[1]  #截取第2个字符
'e'
>>> str1[2:] #从第3个字符开始截取
'llo world!'
>>> str1[:4]
'hell'
>>> str1[1:5]
'ello'
>>> str1[-1] #截取最后一个字符
'!'
>>> str1[2:-2]
'llo worl'
需要注意的是,字符串索引是从0开始计数的。
字符串分割
在Python中,可以使用split()方法将字符串分割为列表形式。
语法格式为:str.split(sep, maxsplit)
参数说明如下:
- str:表示需要进行分割操作的源字符串。
- sep:用于指定分隔符,可包含多个字符。默认值为None,即按所有空字符(包括空格、换行符\n、制表符\t等)进行分割。
- maxsplit:可选参数,用于指定最大分割次数。若未指定或设为-1,则分割次数不受限制;否则,返回结果列表的元素个数最多为maxsplit+1。
- 返回值:分割后的字符串列表。
>>> str1 = "i am a good boy!"
>>> str1.split() #采用默认分割符进行分割
['i', 'am', 'a', 'good', 'boy!']
>>> str1.split(" ") #采用空格进行分割
['i', 'am', 'a', 'good', 'boy!']
>>> str1.split(" ", 3) #采用空格进行分割,并且只分割前3个
['i', 'am', 'a', 'good boy!']
需要注意的是,默认情况下,split()方法按空格进行分割。
字符串检索方法详解
字符串检索
Python提供了多种字符串查找方法,具体如下:
1. count()方法
语法格式为:str.count(sub[, start[, end]])
功能:用于统计指定子字符串在原字符串中出现的次数。若未找到指定字符串,则返回0;否则返回出现的总次数。
参数说明如下:
- str:表示原始字符串。
- sub:表示需要检索的子字符串。
- start:可选参数,指定检索范围的起始索引。若未指定,则从头开始检索。
- end:可选参数,指定检索范围的结束索引。若未指定,则一直检索到字符串末尾。
>>> str1 = "hello world"
>>> print(str1.count('o'))
2
2. find()方法
语法格式为:str.find(sub[, start[, end]])
功能:用于判断字符串是否包含指定子串。若未找到,返回-1;否则返回该子串首次出现的索引位置。
>>> str1 = "hello world!"
>>> str1.find('wo')
6
3. index()方法
语法格式为:str.index(sub[, start[, end]])
功能:与find()类似,用于检索指定子串。不同之处在于,若使用index()方法且未找到指定字符串,程序将抛出异常。
>>> str1 = "hello world!"
>>> str1.index('w')
6
>>> str1.index('m')
Traceback (most recent call last):
 File "<pyshell#6>", line 1, in <module>
 str1.index('m')
ValueError: substring not found
>>> str1.find('m')
-1
4. startswith()方法
语法格式为:str.startswith(prefix[, start[, end]])
功能:用于判断字符串是否以指定子串开头。若是,返回True;否则返回False。
>>> str1 = "hello world!"
>>> str1.startswith('hello')
True
>>> str1.startswith('hi')
False
>>>
5. endswith()方法
语法格式为:str.endswith(prefix[, start[, end]])
功能:用于判断字符串是否以指定子串结尾。若是,返回True;否则返回False。
>>> str1 = "hello world!"
>>> str1.endswith('world!')
True
>>> str1.endswith('haha')
False
字符串大小写转换与清理
字符串大小写转换
1. lower()方法
语法格式为:str.lower()
功能:将字符串中的所有大写字母转换为小写字母。
>>> str1 = "Hello World!"
>>> str1.lower()
'hello world!'
2. upper()方法
语法格式为:str.upper()
功能:将字符串中的所有小写字母转换为大写字母。
>>> str1 = "Hello World!"
>>> str1.upper()
'HELLO WORLD!'
去除字符串中的空格和特殊字符
在开发过程中,常遇到需去除字符串前后空格或特殊字符的需求,例如清理用户输入中的多余空格。此时可使用strip()相关函数。
1. strip()方法
语法格式为:str.strip([chars])
功能:去除字符串前后(左右两侧)的空格或指定特殊字符。
>>> str1 = " hello world! "
>>> str1.strip()
'hello world!'
>>> str2 = "#hello world#@#"
>>> str2.strip('#')
'hello world#@'
>>> str3 = "@hello world!@."
>>> str3.strip('@.')
'hello world!'
2. lstrip()方法
语法格式为:str.lstrip([chars])
功能:仅去除字符串前面(左侧)的空格或指定特殊字符。
>>> str1 = " hello world! "
>>> str1.lstrip()
'hello world! '
>>> str2 = "#hello world#@#"
>>> str2.lstrip('#')
'hello world#@#'
>>> str3 = "@.hello world!@."
>>> str3.lstrip('@.')
'hello world!@.'
3. rstrip()方法
语法格式为: str.rstrip([chars])
功能:仅去除字符串后面(右侧)的空格或指定特殊字符。
>>> str1 = " hello world! "
>>> str1.rstrip()
' hello world!'
>>> str2 = "#hello world#@#"
>>> str2.rstrip('#')
'#hello world#@'
>>> str3 = "@.hello world!@."
>>> str3.rstrip('@.')
'@.hello world!'
字符串格式化输出
字符串格式化
所谓字符串格式化,即先定义一个包含占位符的模板,随后根据需要填入具体内容。
使用“%”操作符进行格式化
语法格式为: '%[-][+][0][.n]格式化字符'%exp
参数说明如下:
- -:可选参数,用于指定左对齐。正数前无符号,负数前加负号。
- +:可选参数,用于指定右对齐。正数前加正号,负数前加负号。
- 0:可选参数,表示右对齐。正数前无符号,负数前加负号,空白处用0填充(通常与m参数配合使用)。
- m:可选参数,表示占用宽度。
- n:可选参数,表示小数点后保留的位数。
- 格式化字符:用于指定数据类型,具体对应关系见下表。
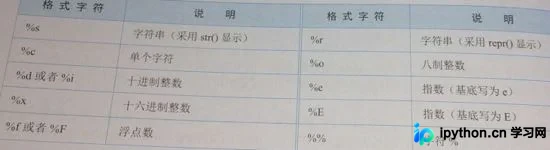
exp:表示要转换的项。若需指定多项,需通过元组形式传入,不支持列表。
>>> template = '学号:%d,姓名:%s,班级:%s'
>>> print(template% (123,'张三','一年级'))
学号:123,姓名:张三,班级:一年级
总结
以上介绍了Python中常用的8种字符串操作方法,希望能为读者提供有益参考。如有任何疑问,欢迎留言交流,我们将及时回复。感谢大家对本站的支持! 若本文对您有帮助,欢迎转载,请注明出处,谢谢!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















