


Python自动化前程无忧:基于竞争力分析的简历批量投递实战

本文介绍如何使用Python结合Selenium和Requests库,自动化获取前程无忧职位的竞争力得分与匹配度评价。通过解析页面结构提取职位ID,利用MongoDB去重存储数据,并筛选高匹配度职位进行批量自动投递,旨在提高求职效率。
前言与原理概述
前言
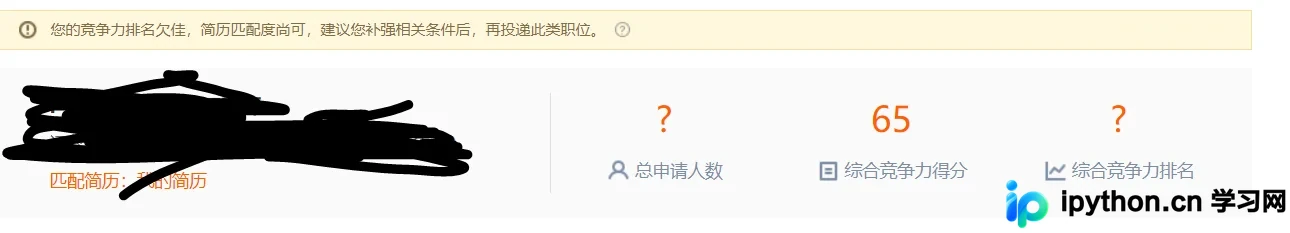
在前程无忧平台投递简历时,系统提供了竞争力分析功能。用户可免费查看职位匹配度评价及综合竞争力分数,这些数据可作为投递决策的重要参考依据。
计算方式
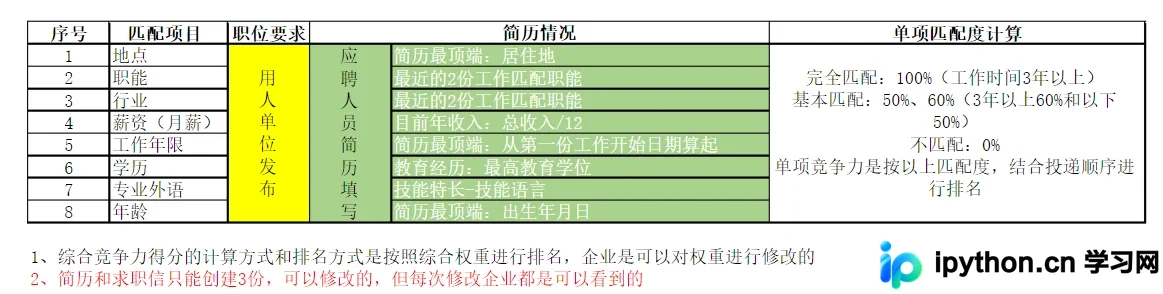
综合竞争力得分越高代表优势越大,同时匹配度评语的评价等级也越高越好,两者结合能更准确反映简历与职位的契合程度。
本方案的核心逻辑是:抓取所有职位关键字搜索结果,提取每个职位的综合竞争力得分和匹配度评语,随后根据设定阈值筛选出合适职位,并自动完成简历投递流程。
登录与Cookie管理
登陆获取cookie
from selenium import webdriver
from selenium.webdriver.chrome.options import Options
chrome_options = Options()
# chrome_options.add_argument('--headless')
from time import sleep
import re
from lxml import etree
import requests
import os
import json
driver = webdriver.Chrome(chrome_options=chrome_options,executable_path = 'D:\python\chromedriver.exe')
headers={"User-Agent":"Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/73.0.3683.86 Safari/537.36"}
driver.get(https://search.51job.com/list/020000,000000,0000,00,9,99,%2520,2,1.html?lang=c&stype=&postchannel=0000&workyear=99&cotype=99°reefrom=99&jobterm=99&companysize=99&providesalary=99&lonlat=0%2C0&radius=-1&ord_field=0&confirmdate=9&fromType=&dibiaoid=0&address=&line=&specialarea=00&from=&welfare=)由于Selenium WebDriver需要在目标域名下写入Cookie才能保持登录状态,因此程序首先需导航至职位搜索页面以初始化环境。

def get_cookie():
  driver.get("https://login.51job.com/login.php?loginway=1&lang=c&url=")
  sleep(2)
  phone=input("输入手机号:")
  driver.find_element_by_id("loginname").send_keys(phone)
  driver.find_element_by_id("btn7").click()
  sleep(1)
  code=input("输入短信:")
  driver.find_element_by_id("phonecode").send_keys(code)
  driver.find_element_by_id("login_btn").click()
  sleep(2)
  cookies = driver.get_cookies()
  with open("cookie.json", "w")as f:
    f.write(json.dumps(cookies))
程序会检查本地cookie文件是否存在;若不存在,则执行get_cookie函数获取并保存Cookie。建议登录阶段不使用无头模式,因为偶尔会触发滑动验证码,可视化界面有助于人机交互验证。
需注意前程无忧对手机短信验证码的发送频率有限制,每天仅限三条。保存Cookie文件可实现下次登录时直接复用,避免频繁获取验证码。
def get_job():
driver.get("https://search.51job.com/list/020000,000000,0000,00,9,99,%2520,2,1.html?lang=c&stype=&postchannel=0000&workyear=99&cotype=99°reefrom=99&jobterm=99&companysize=99&providesalary=99&lonlat=0%2C0&radius=-1&ord_field=0&confirmdate=9&fromType=&dibiaoid=0&address=&line=&specialarea=00&from=&welfare=")
sleep(2)
job=input("输入职位:")
driver.find_element_by_id("kwdselectid").send_keys(job)
driver.find_element_by_xpath('//button[@class="p_but"]').click()
url=driver.current_url
page=driver.page_source
return url,page职位数据抓取与解析
在职位搜索页面获取结果时,程序需同时返回页面源码和当前URL,以便后续解析。
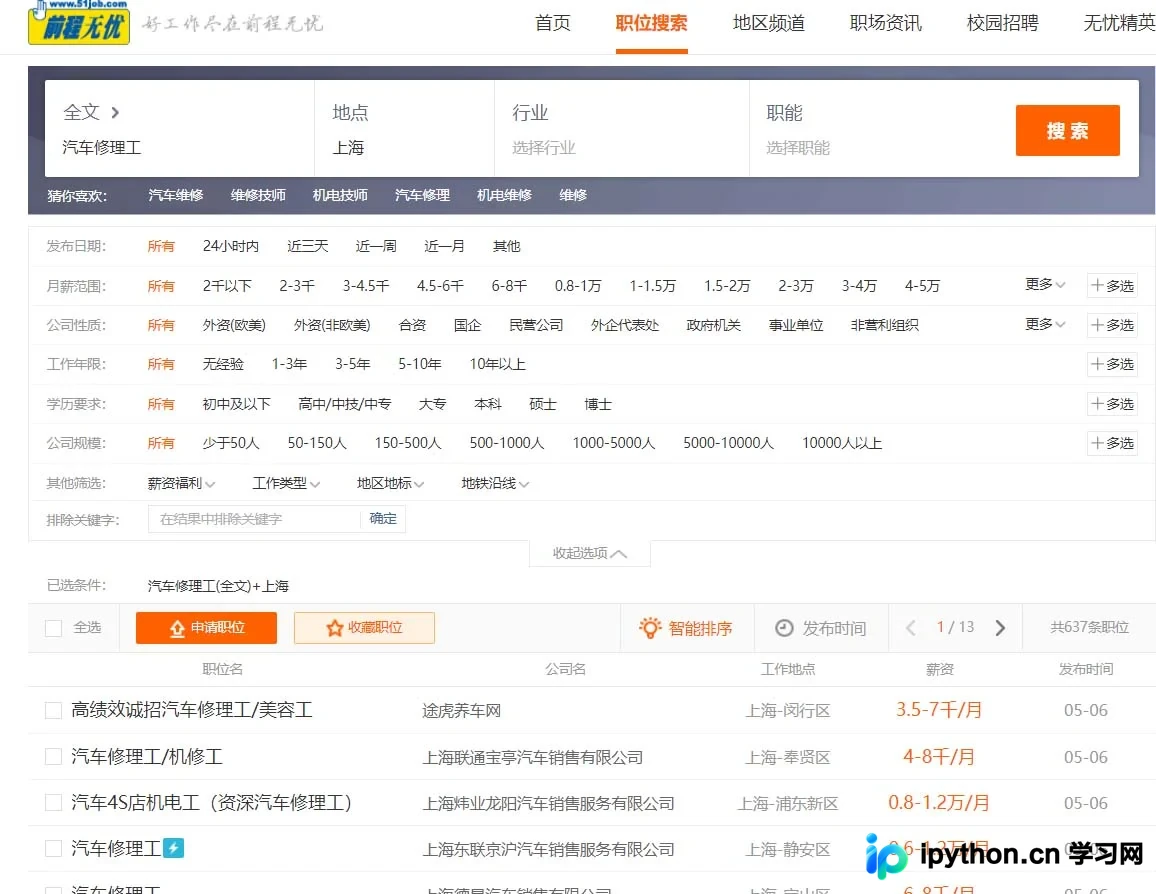
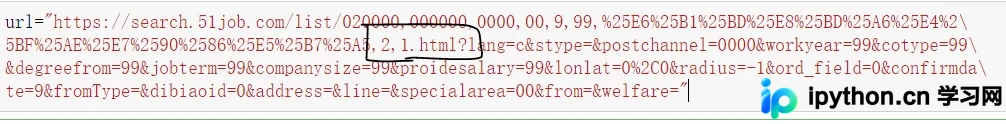

通过分析页码结构的HTML,可以发现页码前缀信息。总页码数量通过解析“共XX页”的文本内容获取。
def get_pages(url,page):
  tree=etree.HTML(page)
  href=[]
  x = tree.xpath('//span[@class="td"]/text()')[0]
  total_page=int(re.findall("(\d+)", x)[0])
  for i in range(1,total_page+1):
    href.append(re.sub("\d.html", f'{i}.html', url))
  return href
根据总页码数,程序生成所有分页的URL列表。
def get_job_code(url):
  headers={"User-Agent":"Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/73.0.3683.86 Safari/537.36"}
  r=session.get(url,headers=headers)
  tree=etree.HTML(r.text)
  divs=tree.xpath('//div[@class="el"]/p/span/a/@href')
  job=str(divs)
  job_id=re.findall("\/(\d+).html",job)
  return job_id
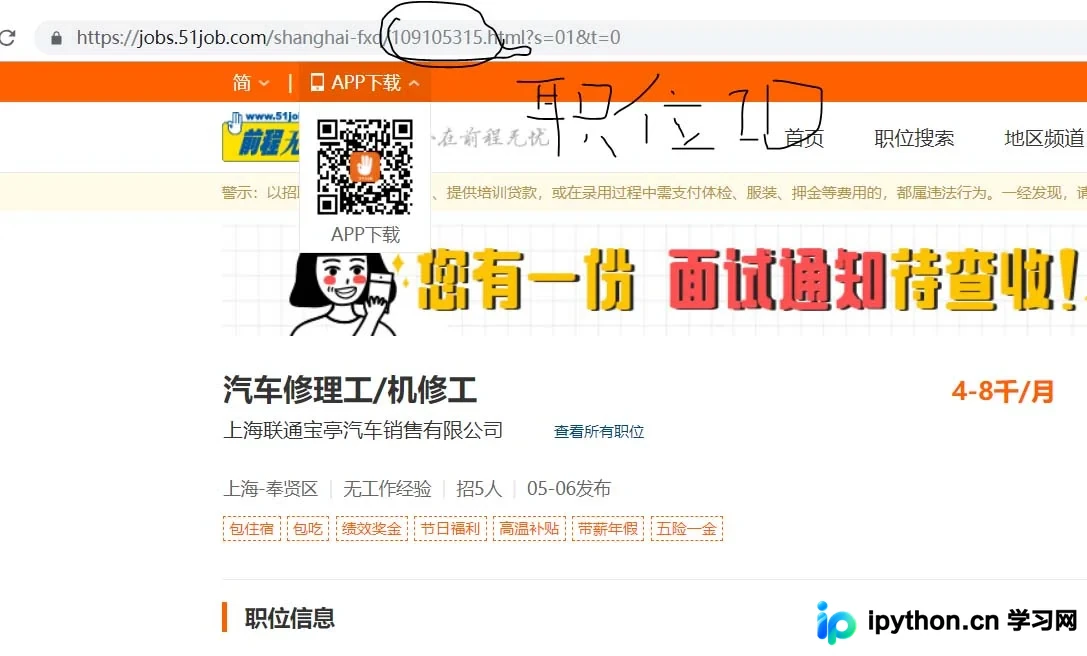
从各分页页面中提取职位ID,这是后续获取详细竞争力数据的关键标识。
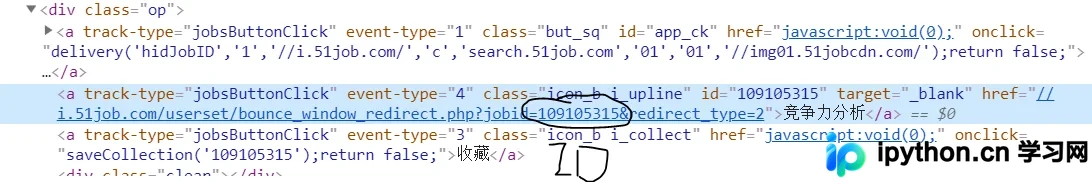
利用提取的职位ID构造请求网址,跳转至竞争力分析页面以获取具体数据。
def get_info(job_id):
  href=f"https://i.51job.com/userset/bounce_window_redirect.php?jobid={job_id}&redirect_type=2"
  r=session.get(href,headers=headers)
  r.encoding=r.apparent_encoding
  tree=etree.HTML(r.text)
  pingjia=tree.xpath('//div[@class="warn w1"]//text()')[0].strip()
  gongsi=[]
  for i in tree.xpath('//div[@class="lf"]//text()'):
    if i.strip():
      gongsi.append(i.strip())
  fenshu=[]
  for i in tree.xpath('//ul[@class="rt"]//text()'):
    if i.strip():
      fenshu.append(i.strip())
  url=f"https://jobs.51job.com/shanghai/{job_id}.html?s=03&t=0"
  return {"公司":gongsi[1],"职位":gongsi[0],"匹配度":pingjia,fenshu[3]:fenshu[2],"链接":url,"_id":job_id}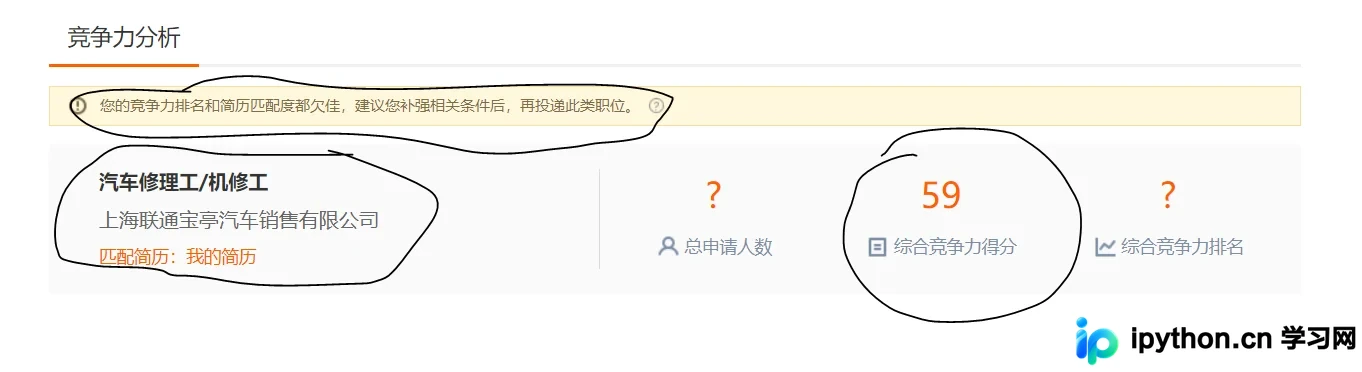
抓取竞争力分析页面的内容,解析后返回包含职位信息的字典对象。
主程序逻辑与数据存储
主程序
if not os.path.exists("cookie.json"):
    get_cookie()
f=open("cookie.json","r")
cookies=json.loads(f.read())
f.close()
主程序首先检查cookie文件是否载入;若Cookie不存在,则调用get_cookie()函数获取新Cookie并保存至文件。
session = requests.Session()
  for cookie in cookies:
  driver.add_cookie(cookie)
session.cookies.set(cookie['name'],cookie['value'])
url, page = get_job()
driver.close()
将获取的Cookie分别写入requests.Session对象和WebDriver实例中,以维持登录状态。
获取第一页数据及URL后,WebDriver浏览器实例即可关闭,以节省资源。
code=[]
for i in get_pages(url,page):
  code=code+get_job_code(i)
将获取到的所有职位ID添加至待处理列表。
import pymongo
client=pymongo.MongoClient("localhost",27017)
db=client["job_he"]
job_info=db["job_info"]
for i in code:
  try:
    if not job_info.find_one({"_id":i}):
      info=get_info(i)
      sleep(1)
      job_info.insert_one(info)
      print(info,"插入成功")
  except:
    print(code)
考虑到爬取速度较慢,程序采用MongoDB存储结果,以职位ID作为索引。在插入新数据前检查ID是否存在,通过简单去重机制减少不必要的访问请求。
批量投递执行流程
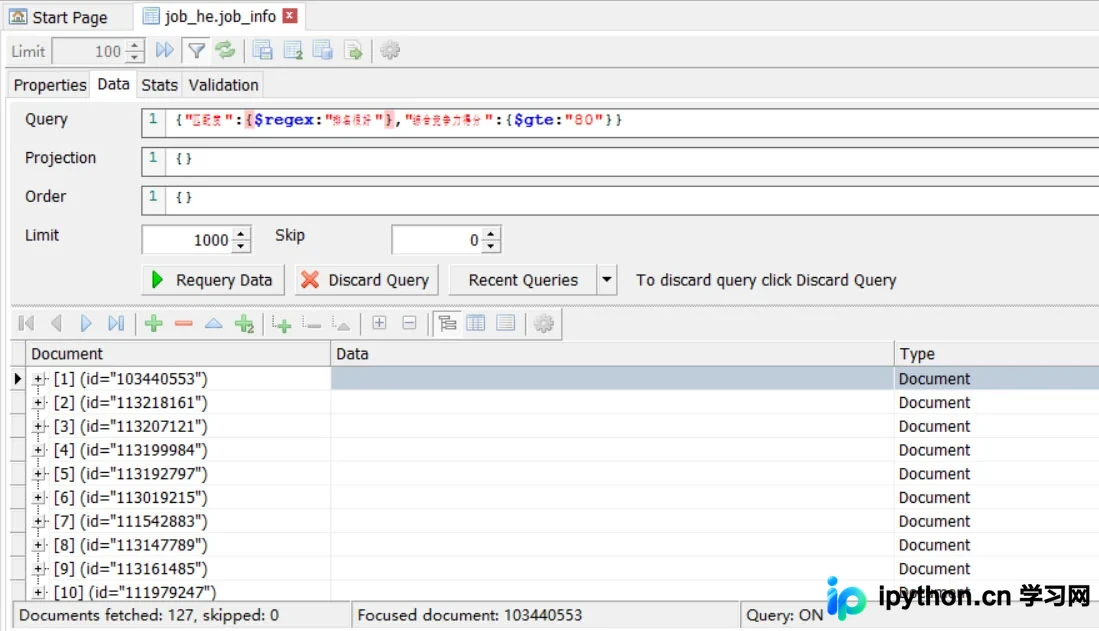
经过一段时间的运行,程序成功抓取了8000个职位数据。经过筛选,找到127个匹配度良好的职位,随后开始执行批量投递操作。
在保持登录状态的前提下,点击“申请职位”按钮。此步骤由WebDriver模拟操作完成。
for i in job_info.find({"匹配度":{$regex:"排名很好"},"综合竞争力得分":{$gte:"80"}}):
  print(i)
  try:
    driver.get(i)
    driver.find_element_by_id("app_ck").click()
    sleep(2)
  except:
    pass
利用Cookie保持登录状态,通过简单的for循环执行投递。程序从MongoDB查询数据表,使用正则表达式筛选匹配度评语和竞争力得分,获取所有符合投递条件的结果。
确认投递操作已成功执行。
代码
from selenium import webdriver
from selenium.webdriver.chrome.options import Options
chrome_options = Options()
# chrome_options.add_argument('--headless')
from time import sleep
import re
from lxml import etree
import requests
import os
import json
driver = webdriver.Chrome(chrome_options=chrome_options,executable_path = 'D:\python\chromedriver.exe')
headers={"User-Agent":"Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/73.0.3683.86 Safari/537.36"}
driver.get("https://search.51job.com/list/020000,000000,0000,00,9,99,%2520,2,1.html?lang=c&stype=&postchannel=0000&workyear=99&cotype=99°reefrom=99&jobterm=99&companysize=99&providesalary=99&lonlat=0%2C0&radius=-1&ord_field=0&confirmdate=9&fromType=&dibiaoid=0&address=&line=&specialarea=00&from=&welfare=")
def get_cookie():
driver.get("https://login.51job.com/login.php?loginway=1&lang=c&url=")
sleep(2)
phone=input("输入手机号:")
driver.find_element_by_id("loginname").send_keys(phone)
driver.find_element_by_id("btn7").click()
sleep(1)
code=input("输入短信:")
driver.find_element_by_id("phonecode").send_keys(code)
driver.find_element_by_id("login_btn").click()
sleep(2)
cookies = driver.get_cookies()
with open("cookie.json", "w")as f:
f.write(json.dumps(cookies))
def get_job():
driver.get("https://search.51job.com/list/020000,000000,0000,00,9,99,%2520,2,1.html?lang=c&stype=&postchannel=0000&workyear=99&cotype=99°reefrom=99&jobterm=99&companysize=99&providesalary=99&lonlat=0%2C0&radius=-1&ord_field=0&confirmdate=9&fromType=&dibiaoid=0&address=&line=&specialarea=00&from=&welfare=")
sleep(2)
job=input("输入职位:")
driver.find_element_by_id("kwdselectid").send_keys(job)
driver.find_element_by_xpath('//button[@class="p_but"]').click()
url=driver.current_url
page=driver.page_source
return url,page
def close_driver():
driver.close()
def get_pages(url,page):
tree=etree.HTML(page)
href=[]
x = tree.xpath('//span[@class="td"]/text()')[0]
total_page=int(re.findall("(\d+)", x)[0])
for i in range(1,total_page+1):
href.append(re.sub("\d.html", f'{i}.html', url))
return href
def get_job_code(url):
headers={"User-Agent":"Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/73.0.3683.86 Safari/537.36"}
r=session.get(url,headers=headers)
tree=etree.HTML(r.text)
divs=tree.xpath('//div[@class="el"]/p/span/a/@href')
job=str(divs)
job_id=re.findall("\/(\d+).html",job)
return job_id
def get_info(job_id):
href=f"https://i.51job.com/userset/bounce_window_redirect.php?jobid={job_id}&redirect_type=2"
r=session.get(href,headers=headers)
r.encoding=r.apparent_encoding
tree=etree.HTML(r.text)
pingjia=tree.xpath('//div[@class="warn w1"]//text()')[0].strip()
gongsi=[]
for i in tree.xpath('//div[@class="lf"]//text()'):
if i.strip():
gongsi.append(i.strip())
fenshu=[]
for i in tree.xpath('//ul[@class="rt"]//text()'):
if i.strip():
fenshu.append(i.strip())
url=f"https://jobs.51job.com/shanghai/{job_id}.html?s=03&t=0"
return {"公司":gongsi[1],"职位":gongsi[0],"匹配度":pingjia,fenshu[3]:fenshu[2],"链接":url,"_id":job_id}
if not os.path.exists("cookie.json"):
get_cookie()
f=open("cookie.json","r")
cookies=json.loads(f.read())
f.close()
session = requests.Session()
for cookie in cookies:
driver.add_cookie(cookie)
session.cookies.set(cookie['name'], cookie['value'])
url, page = get_job()
driver.close()
code=[]
for i in get_pages(url,page):
code=code+get_job_code(i)
import pymongo
client=pymongo.MongoClient("localhost",27017)
db=client["job_he"]
job_info=db["job_info"]
for i in code:
try:
if not job_info.find_one({"_id":i}):
info=get_info(i)
sleep(1)
job_info.insert_one(info)
print(info)
print("插入成功")
except:
print(code)总结
以上就是本文的全部内容,希望本文提供的技术方案对大家的学习或工作具有一定的参考和借鉴价值,感谢支持。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















