


Python处理&#数字;HTML实体编码的方法

发布时间:2026-10-13 |
5人浏览过
本文介绍在Python中处理以&#开头加数字的HTML字符编码(如风)的方法。针对Python 2.7版本,需导入HTMLParser模块并使用HTMLParser().unescape()进行转换;对于Python 3.7及以上版本,推荐使用html模块或from html import unescape直接处理字符串,实现从中文字符编码到正常文本的还原。
Python处理HTML数字实体编码的方法
在Python中,如何处理以“&#”开头并跟随数字的HTML字符编码,例如风水这类数据?
在使用Python抓取网页数据时,有时会遇到数据以“&#”开头后接数字的字符形式,如图中所示的情况。
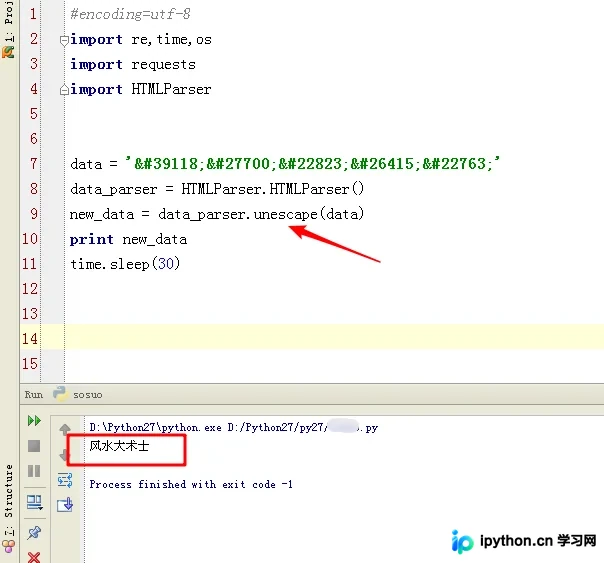
风水大术士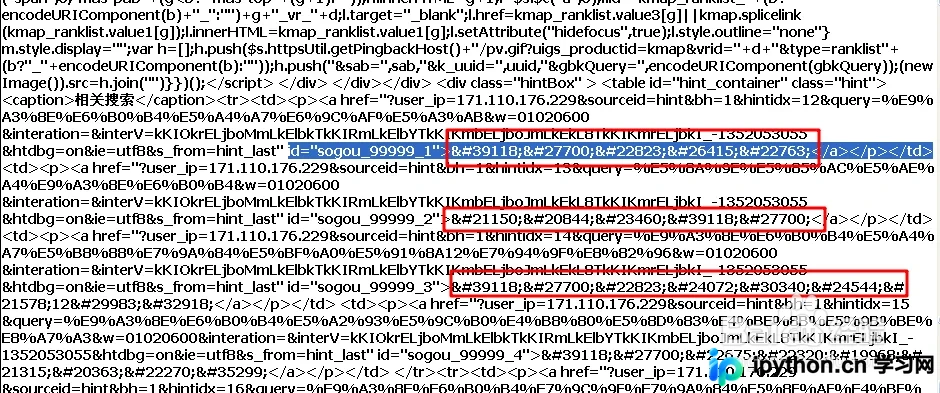
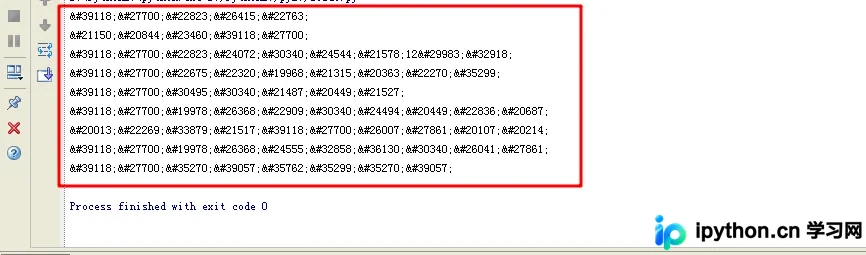
这些字符需要经过再次转换,才能还原为正常的中文内容。
Python 2.7版本实现
Python 2.7版本
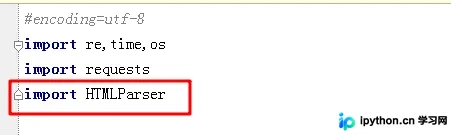
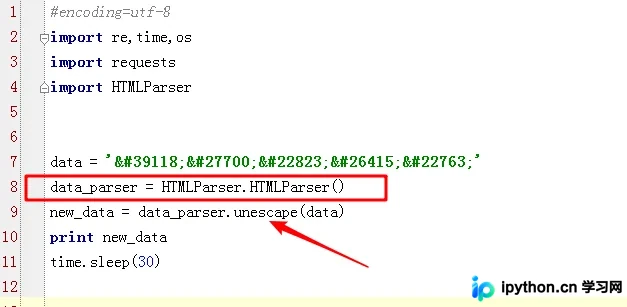
在Python 2.7版本中,需要导入HTMLParser模块。
定义相关变量,并编写转换代码。
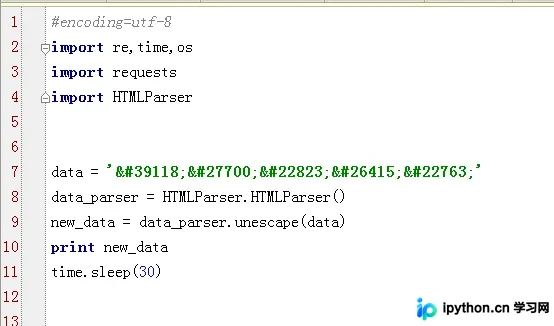
代码的关键在于“data_parser = HTMLParser.HTMLParser()”,通过创建该实例,才能调用“.unescape()”方法。
测试运行结果,该字符串被正常输出为中文。
Python 3.7及以上版本实现
Python 3.7及以上版本
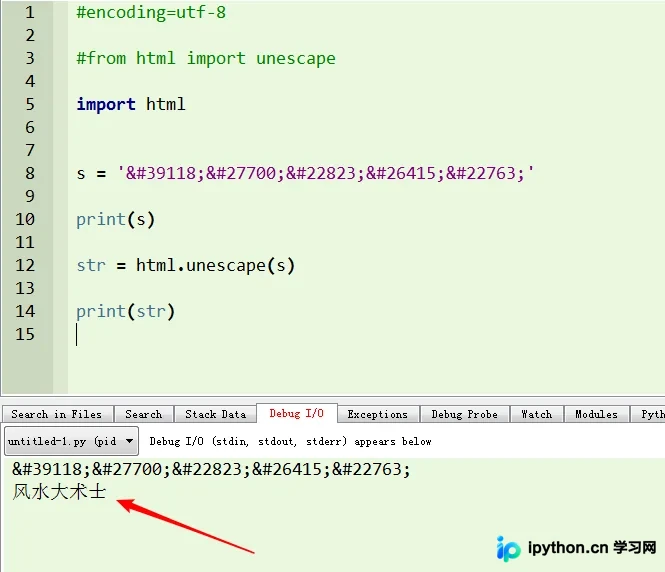
在较新的Python版本中,上述导入方式不再适用。可以使用“import html”或者“from html import unescape”。此处以“import html”为例进行测试。
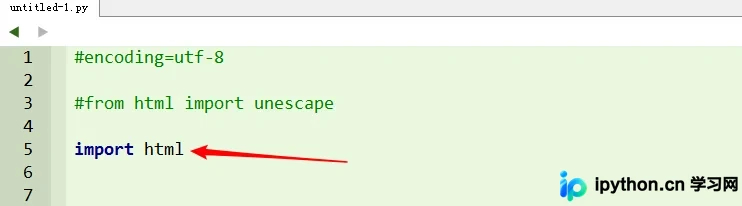
导入html模块后,直接利用“.unescape()”方法处理字符串。
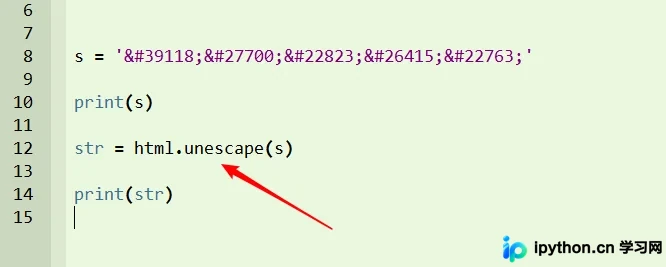
运行后,字符串被正常转换为中文字符。
感谢大家的阅读和对本站的支持。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















