


Python批量查询微信指数实战:Fiddler抓包与脚本实现

本文详细介绍如何使用Python批量获取微信指数数据。通过Fiddler配置HTTPS抓包,从微信指数小程序中提取关键请求参数,结合Python脚本实现自动化查询。涵盖环境准备、代理设置、证书安装及核心代码解析,帮助开发者高效获取关键词热度数据。
Python批量查询微信指数实战:Fiddler抓包与脚本实现
本文旨在演示如何利用Python脚本批量获取关键词的微信指数数据。
环境准备与工具安装
在开始之前,需要确保本地已安装Python开发环境,并准备好Fiddler抓包工具。
Fiddler HTTPS与连接配置
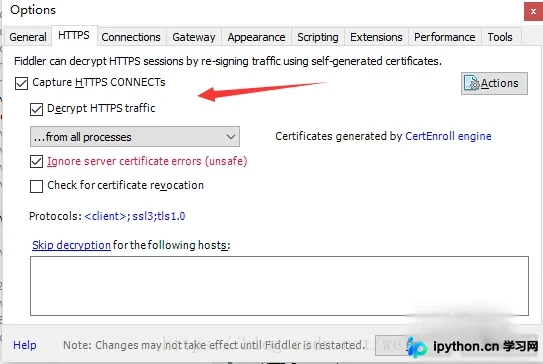
首先启动Fiddler软件,依次点击Tools菜单下的Options选项,进入HTTPS设置界面,勾选相关选项以启用HTTPS解密功能,具体操作可参考下图所示步骤。
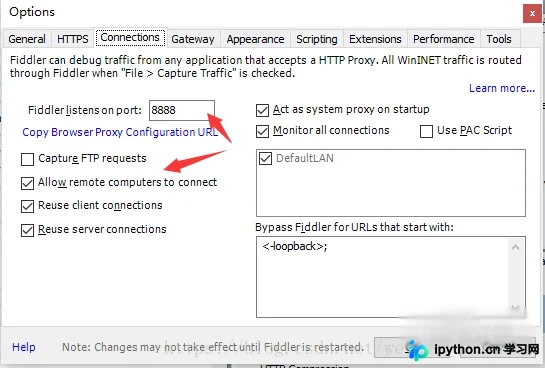
接着进行Connections连接设置,确保Fiddler监听端口配置正确,详细设置请参考下图。
手机代理设置与证书安装
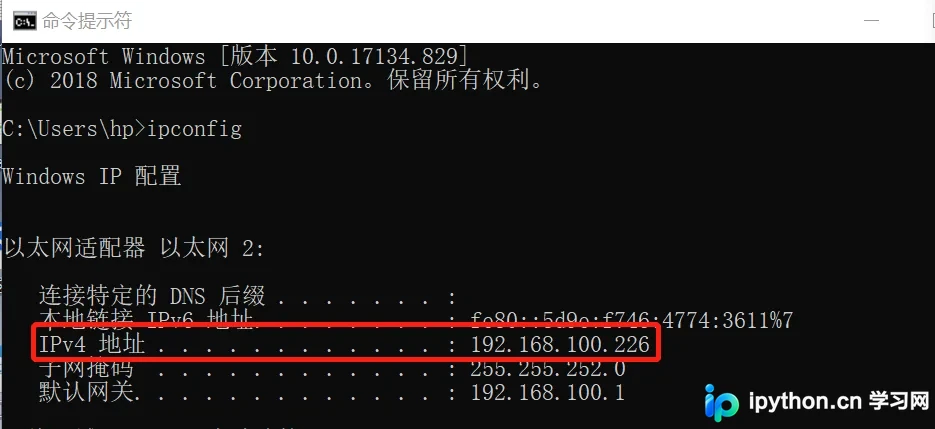
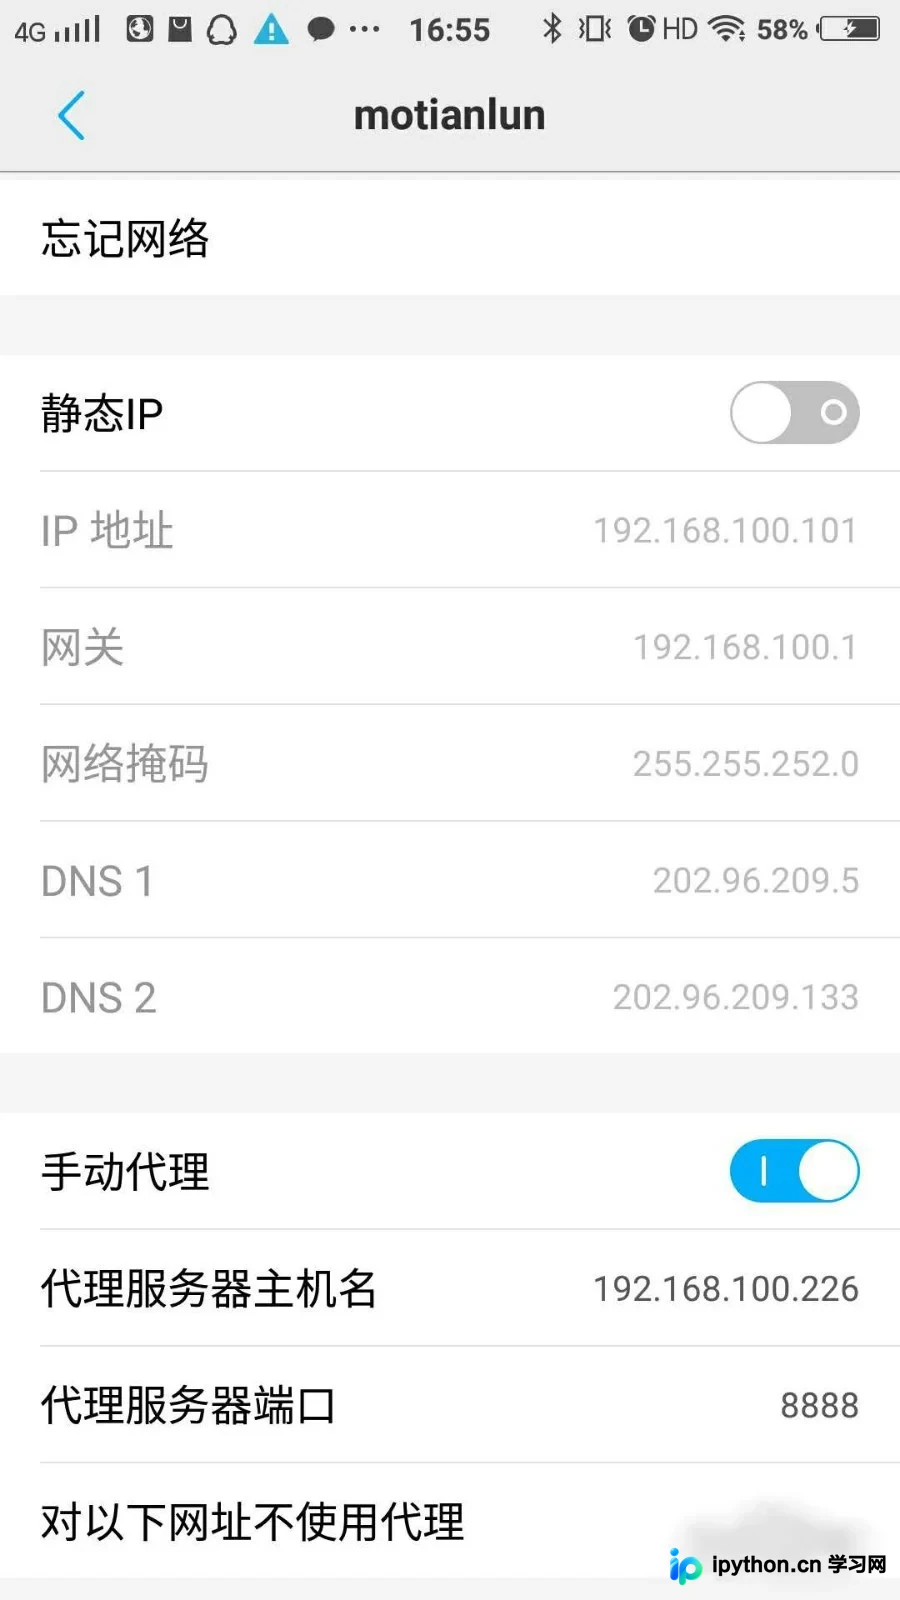
手机端配置的关键在于使手机与电脑处于同一局域网环境下。在手机WLAN设置中开启手动代理模式,并将代理服务器主机名设置为电脑的IPv4地址。获取电脑IP地址的方法是在命令行窗口运行cmd,输入ipconfig命令并回车即可查看,如下图所示。
代理服务器端口应设置为Fiddler Connections中配置的默认端口8888。虽然该端口可自定义,只要手机与Fiddler设置一致即可,但此处建议直接使用默认端口以简化配置。最终的网络代理配置效果如下图所示。
完成上述设置后,在手机浏览器中访问http://加上电脑IPv4地址及端口(例如http://192.168.100.226:8888/),在页面中找到并点击“FiddlerRoot certificate”下载根证书,按照提示完成安装。至此,所有配置工作完成,当手机访问微信相关页面时,Fiddler即可捕获到相应的网络请求数据。
微信指数接口抓包与参数提取
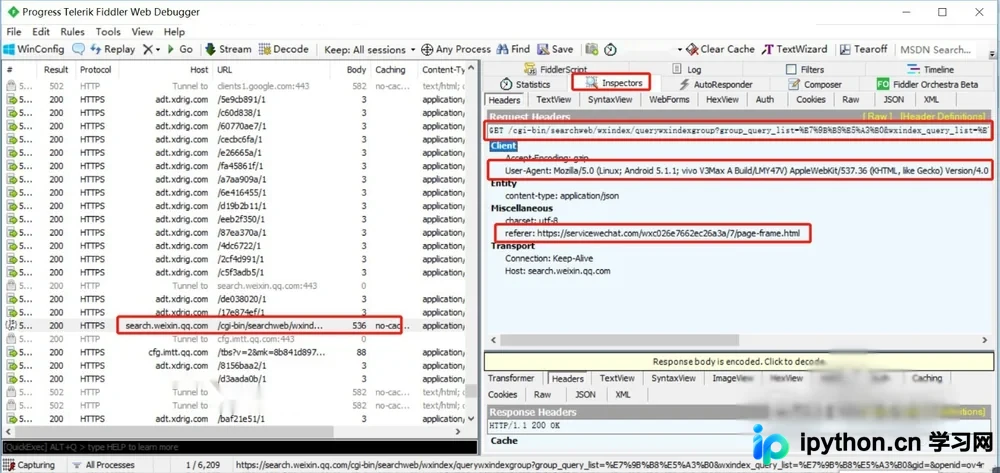
打开微信指数小程序,输入目标关键词(如“演唱会”)进行搜索。在Fiddler捕获的数据流中,找到Host为search.weixin.qq.com的请求,点击进入查看详细信息。重点提取Request Headers中的几个关键参数:GET请求地址、User-Agent(用户代理)以及referer(来源页面),如下图所示。这些参数将在后续代码中作为请求头进行配置,需根据实际抓包结果调整。
Python批量查询代码实现
以下是实现批量查询的核心Python代码示例:
import requests,urllib,json,random,time
from requests.packages.urllib3.exceptions import InsecureRequestWarning
requests.packages.urllib3.disable_warnings(InsecureRequestWarning)

headers = {'Accept-Encoding': 'gzip',
    'referer': 'https://servicewechat.com/wxc026e7662ec26a3a/7/page-frame.html',#需按实际抓包修改
    'content-type': 'application/json',
    'User-Agent': 'Mozilla/5.0 (Linux; Android 5.1.1; vivo V3Max A Build/LMY47V) AppleWebKit/537.36 (KHTML, like Gecko) Version/4.0 Chrome/39.0.0.0 Mobile Safari/537.36 MicroMessenger/7.0.4.1420(0x27000435) Process/appbrand2 NetType/WIFI Language/zh_CN', #需按实际抓包修改
    'Host': 'search.weixin.qq.com',
    'Connection': 'Keep-Alive'
    }

with open('weixin.txt','w',encoding='utf-8') as f:
 for line in open('keywords.txt',encoding='utf-8-sig'):
   word = line.rstrip()
   kw = urllib.parse.quote(word)
   url = 'https://search.weixin.qq.com/cgi-bin/searchweb/wxindex/querywxindexgroup?group_query_list={}&wxindex_query_list={}&gid=&openid=ov4ns0NiA4_Cshlsxa5pT640jC5w&search_key=1560843991380393_3137533225'.format(kw,kw) #需按实际抓包修改
   html = requests.get(url,headers=headers,verify=False).text
   time.sleep(random.uniform(2, 4))
   datas = json.loads(html)
   if datas.get('data'):
    try:
      wxindex_str = datas['data']['group_wxindex'][0]['wxindex_str']
      if wxindex_str:
       index = wxindex_str.split(',')[-1]
      else:
       index = 0
    except:
      index = 0
   else:
    index = 0
   data = '{}\t{}\n'.format(word,index)
   print(data.rstrip())
   f.write(data)
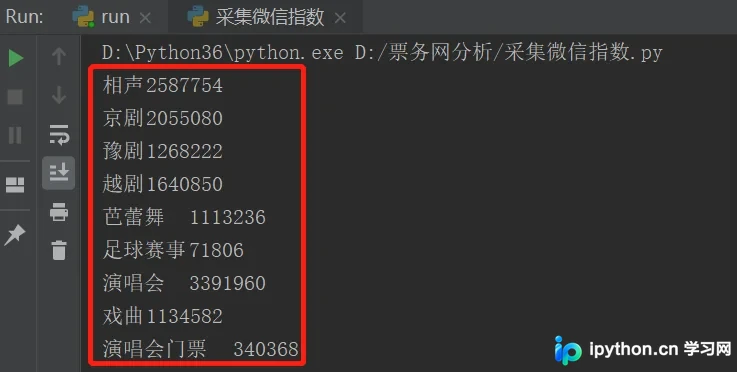
需要注意的是,请求链接中的参数需要进行替换处理。将抓取的原始链接中groupquerylist及wxindexquerylist等号后的具体字符替换为占位符{}。将待查询的关键词列表保存至keywords.txt文件中,确保每个关键词独占一行。运行脚本后,查询结果将实时输出至控制台,并最终保存至weixin.txt文件中,数据输出效果如下图所示。
通过上述步骤,我们完成了从环境配置、抓包分析到脚本实现的全过程。
以上就是关于使用Python批量查询微信指数的完整教程,希望本文的内容能对各位开发者有所帮助,感谢阅读与支持。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















