


使用pandas to_sql将DataFrame高效存入数据库

发布时间:2026-10-13 |
5人浏览过
本文介绍如何利用pandas的to_sql方法将DataFrame数据保存至数据库。重点解析chunksize批量处理、if_exists冲突策略及index索引控制等关键参数,结合MySQL连接与数据汇总示例,展示从数据读取、处理到入库的完整流程。
pandas to_sql数据库存储目的
目的
在数据分析流程中,常需将中间计算结果或最终产出持久化至数据库;或将中间数据存入数据库后,利用SQL语句进行更直观的操作,再将处理后的结果读取回DataFrame。针对这两种典型场景,使用DataFrame的to_sql方法是必要的解决方案。
具体的操作
数据库连接与数据入库操作
连接数据库代码
import pandas as pd
from sqlalchemy import create_engine
# default
engine = create_engine('mysql+pymysql://ledao:ledao123@localhost/pandas_learn')
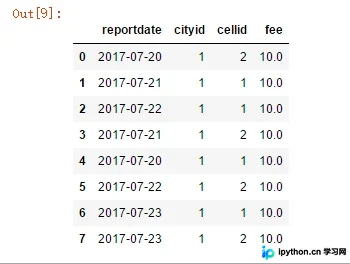
original_data = pd.read_sql_table('cellfee', engine)
original_data
结果如下所示。
对数据进行汇总,每个小区的电费进行求和放到Series中,然后将所有小区的总电费放到DataFrame中,最后将DataFrame保存到数据库中,代码如下所示。
all_cells = []
for k, v in original_data.groupby(by=['cityid', 'cellid']):
onecell = pd.Series(data=[k[0], k[1], v['fee'].sum()], index=['cityid', 'cellid', 'fee_sum'])
all_cells.append(onecell)
all_cells = pd.DataFrame(all_cells)
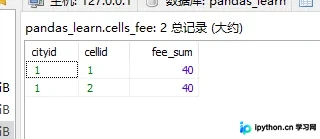
all_cells.to_sql(name='cells_fee', con=engine, chunksize=1000, if_exists='replace', index=None)
to_sql关键参数详解
对于DataFrame的to_sql函数,需要注意的参数在代码中已经写出来,其中比较重要的是chunksize、if_exists和index。 chunksize可以设置一次入库的大小;if_exists设置如果数据库中存在同名表怎么办,‘replace'表示将表原来数据删除放入当前数据;‘append'表示追加;‘fail'则表示将抛出异常,结束操作,默认是‘fail';index=接受boolean值,表示是否将DataFrame的index也作为表的列存储。
最终存表的结果如下图所示。
以上就是本文的全部内容,希望对大家的学习有所帮助,也希望大家多多支持本站。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















