


Python OpenCV实现基于投影法的图像文字分割

本文介绍利用Python和OpenCV库,通过水平与垂直投影法实现图像中文字的自动分割。首先对图像进行二值化处理,随后统计像素分布以确定行列边界,进而提取单个字符坐标。文中提供了完整的代码示例,并分析了中文复杂结构下的分割局限性及优化方向。
文字分割实现步骤与原理
具体实现流程如下:
第一步,利用水平投影技术对图像进行横向切割,从而提取出每一行的图像区域;
第二步,对已分割的每一行图像执行垂直投影操作,进行纵向切割,最终确定每个字符的具体坐标位置,完成单个字符的提取;
简要说明投影法的原理:在水平和垂直两个方向上,对经过预处理(即二值化)的图像中的特定像素进行统计。由于二值化图像仅包含黑白两种颜色,通过统计白色或黑色像素的数量,可以判断出每一行的上下边界以及每一列的左右边界,从而实现图像分割。
接下来,将使用Python结合OpenCV库来演示该功能的具体实现。
水平投影实现与代码解析
首先实现水平投影部分:
import cv2

import numpy as np


'''水平投影'''

def getHProjection(image):

 hProjection = np.zeros(image.shape,np.uint8)

 #图像高与宽

 (h,w)=image.shape

 #长度与图像高度一致的数组

 h_ = [0]*h

 #循环统计每一行白色像素的个数

 for y in range(h):

  for x in range(w):

   if image[y,x] == 255:

    h_[y]+=1

 #绘制水平投影图像

 for y in range(h):

  for x in range(h_[y]):

   hProjection[y,x] = 255

 cv2.imshow('hProjection2',hProjection)


 return h_


if __name__ == "__main__":

 #读入原始图像

 origineImage = cv2.imread('test.jpg')

 # 图像灰度化

 #image = cv2.imread('test.jpg',0)

 image = cv2.cvtColor(origineImage,cv2.COLOR_BGR2GRAY)

 cv2.imshow('gray',image)

 # 将图片二值化

 retval, img = cv2.threshold(image,127,255,cv2.THRESH_BINARY_INV)

 cv2.imshow('binary',img)

 #水平投影

 H = getHProjection(img)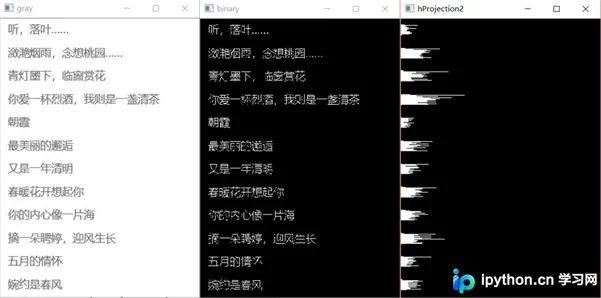
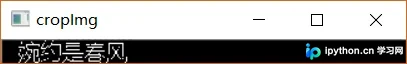
根据上述水平投影结果,利用白色像素形成的“小山峰”的起始位置,可以界定出每一行的起始边界,从而将每一行图像成功分割出来。
垂直投影与字符定位
在获取每一行图像后,可以对其执行垂直投影操作。
def getVProjection(image):

 vProjection = np.zeros(image.shape,np.uint8);

 #图像高与宽

 (h,w) = image.shape

 #长度与图像宽度一致的数组

 w_ = [0]*w

 #循环统计每一列白色像素的个数

 for x in range(w):

  for y in range(h):

   if image[y,x] == 255:

    w_[x]+=1

 #绘制垂直平投影图像

 for x in range(w):

  for y in range(h-w_[x],h):

   vProjection[y,x] = 255

 cv2.imshow('vProjection',vProjection)

 return w_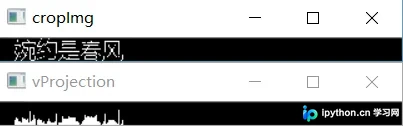
通过垂直投影分析,可以获得每个字符左右两侧的起始位置,由此确定每个字符的具体坐标,即生成一个矩形框来标记字符位置。
完整代码实现与效果分析
以下是实现该功能的全部代码:
import cv2

import numpy as np


'''水平投影'''

def getHProjection(image):

 hProjection = np.zeros(image.shape,np.uint8)

 #图像高与宽

 (h,w)=image.shape

 #长度与图像高度一致的数组

 h_ = [0]*h

 #循环统计每一行白色像素的个数

 for y in range(h):

  for x in range(w):

   if image[y,x] == 255:

    h_[y]+=1

 #绘制水平投影图像

 for y in range(h):

  for x in range(h_[y]):

   hProjection[y,x] = 255

 cv2.imshow('hProjection2',hProjection)


 return h_


def getVProjection(image):

 vProjection = np.zeros(image.shape,np.uint8);

 #图像高与宽

 (h,w) = image.shape

 #长度与图像宽度一致的数组

 w_ = [0]*w

 #循环统计每一列白色像素的个数

 for x in range(w):

  for y in range(h):

   if image[y,x] == 255:

    w_[x]+=1

 #绘制垂直平投影图像

 for x in range(w):

  for y in range(h-w_[x],h):

   vProjection[y,x] = 255

 #cv2.imshow('vProjection',vProjection)

 return w_


if __name__ == "__main__":

 #读入原始图像

 origineImage = cv2.imread('test.jpg')

 # 图像灰度化

 #image = cv2.imread('test.jpg',0)

 image = cv2.cvtColor(origineImage,cv2.COLOR_BGR2GRAY)

 cv2.imshow('gray',image)

 # 将图片二值化

 retval, img = cv2.threshold(image,127,255,cv2.THRESH_BINARY_INV)

 cv2.imshow('binary',img)

 #图像高与宽

 (h,w)=img.shape

 Position = []

 #水平投影

 H = getHProjection(img)


 start = 0

 H_Start = []

 H_End = []

 #根据水平投影获取垂直分割位置

 for i in range(len(H)):

  if H[i] > 0 and start ==0:

   H_Start.append(i)

   start = 1

  if H[i] <= 0 and start == 1:

   H_End.append(i)

   start = 0

 #分割行,分割之后再进行列分割并保存分割位置

 for i in range(len(H_Start)):

  #获取行图像

  cropImg = img[H_Start[i]:H_End[i], 0:w]

  #cv2.imshow('cropImg',cropImg)

  #对行图像进行垂直投影

  W = getVProjection(cropImg)

  Wstart = 0

  Wend = 0

  W_Start = 0

  W_End = 0

  for j in range(len(W)):

   if W[j] > 0 and Wstart ==0:

    W_Start =j

    Wstart = 1

    Wend=0

   if W[j] <= 0 and Wstart == 1:

    W_End =j

    Wstart = 0

    Wend=1

   if Wend == 1:

    Position.append([W_Start,H_Start[i],W_End,H_End[i]])

    Wend =0

 #根据确定的位置分割字符

 for m in range(len(Position)):

  cv2.rectangle(origineImage, (Position[m][0],Position[m][1]), (Position[m][2],Position[m][3]), (0 ,229 ,238), 1)

 cv2.imshow('image',origineImage)

 cv2.waitKey(0)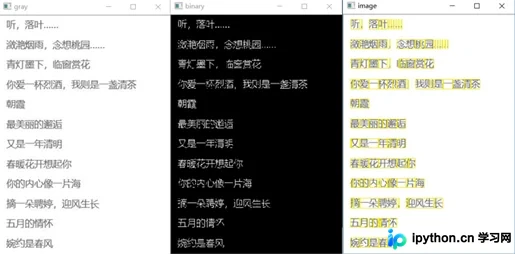
从分割结果来看,基本实现了图片中文字的分割。然而,由于中文结构较为复杂,部分汉字的分割效果并不理想,例如“叶”、“桃”等字可能出现过度分割的情况;而对于存在粘连的两个字(如示例中的“念想”),则可能出现分割不充分的现象。不过,可以通过图像预处理(如腐蚀操作)以及调整边界判断的阈值等方面进行优化。
以上就是本文的全部内容,希望对大家的学习有所帮助,也希望大家多多支持本站。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















