


基于Python与TensorFlow的垃圾分类图像识别方案

本文介绍利用Python、Keras和TensorFlow构建垃圾分类模型的思路。通过卷积神经网络(CNN)对干垃圾、湿垃圾、有害垃圾及可回收物进行图像分类,详细解析了数据预处理、模型架构搭建及训练流程,为智能垃圾分类提供技术参考。
环境配置
0 环境
Python版本:3.6.8
系统版本:macOS Mojave
Python Jupyter Notebook
引言与分类背景
1 引言
七月已至,随着《上海市生活垃圾管理条例》的正式实施,垃圾分类成为公众关注的焦点。许多人在面对复杂的分类标准时感到困惑,例如不确定某些物品应归入哪一类垃圾,导致日常处理时倍感压力。
以未喝完的珍珠奶茶为例,其分类处理需遵循特定步骤:
- 首先,将剩余的奶茶液体倒入水槽。
- 珍珠、水果果肉等固体残渣属于湿垃圾,应投入湿垃圾桶。
- 清洗后的塑料杯身属于干垃圾,需投入干垃圾桶。
- 对于带盖的热饮杯,若塑料盖材质符合回收标准,可归为可回收垃圾。
尽管分类规则繁琐,但这并不影响我们享受奶茶的乐趣。关键在于掌握正确的分类方法。
由此引出一个技术问题:能否利用人工智能和数据科学手段,辅助实现更高效的垃圾分类?若能通过技术手段自动识别垃圾类型,将极大降低公众的分类门槛。
技术解决思路
2 思路
解决垃圾分类问题存在多种技术路径,本文旨在提供几种初步的技术视角。
方案一:将垃圾属性转化为结构化表格数据,利用传统机器学习算法进行分类。
方案二:构建垃圾分类知识图谱,通过查询系统实现类似字典检索的信息获取。
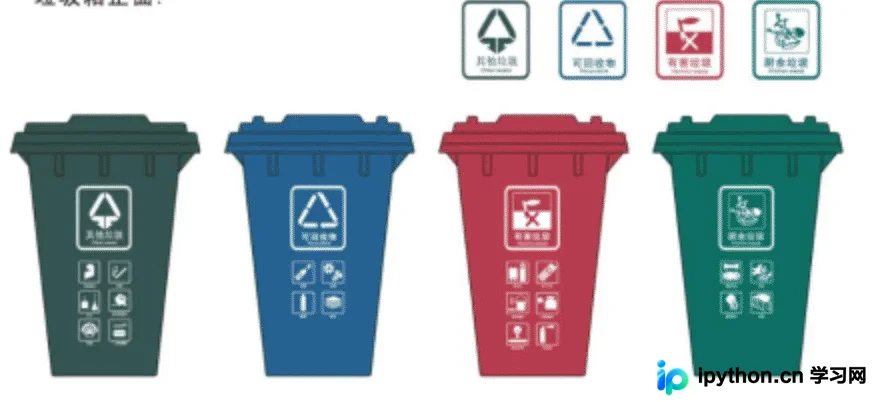
方案三:采用深度学习技术,特别是图像识别方法。通过输入垃圾图片,由模型自动判断其属于干垃圾、湿垃圾、有害垃圾还是可回收垃圾。
图像分类模型实现
3 图像分类
图像分类是深度学习的经典应用场景。该过程接收一张图片作为输入,经过预处理后输入深度学习模型,最终输出该图片中垃圾的类别。本文设定的分类目标包括四类:干垃圾、湿垃圾、有害垃圾和可回收垃圾。
例如:报纸属于可回收垃圾。
电池属于有害垃圾。
一次性餐盒属于干垃圾。
针对图片中物品的分类属于图像处理与识别领域。在人工智能领域,卷积神经网络(Convolutional Neural Network, CNN)被广泛用于解决此类问题。
本文使用Keras包配合Tensorflow后端来构建模型。鉴于当前训练集样本尚不充分,本文主要提供基础思路与代码框架。实际应用中需先进行数据收集工作,随后再进行模型训练。
以下展示代码的基本结构。
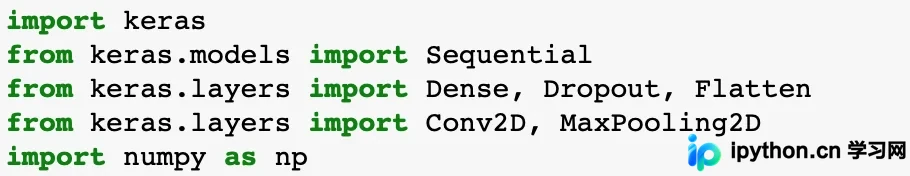
首先导入必要的依赖包。
接着进行数据预处理准备工作。
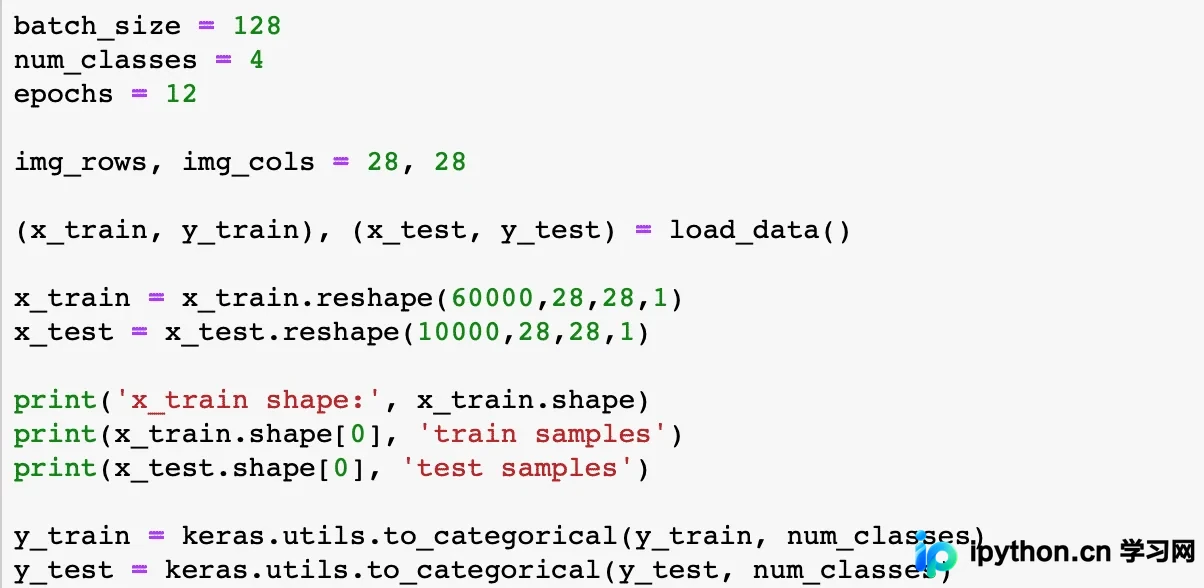
在上述代码中,初始化了若干关键变量:batch size设为128;num_classes设为4,对应干垃圾、湿垃圾、有害垃圾和可回收垃圾四个类别;epochs表示训练轮次。此外,img_rows和img_cols均设为28,定义图片尺寸。
在.reshape(60000,28,28,1)操作中,60000代表图片数量(可根据实际情况调整),28代表图片尺寸(可调),1代表通道数,此处指黑白图像。同理,.reshape(10000,28,28,1)表示图片数量为10000的情况。
最后两行代码将目标变量转换为二分类向量(矩阵)表示。例如,[1,0,0,0]代表干垃圾,[0,1,0,0]代表湿垃圾,以此类推。
接下来进入模型构建阶段。
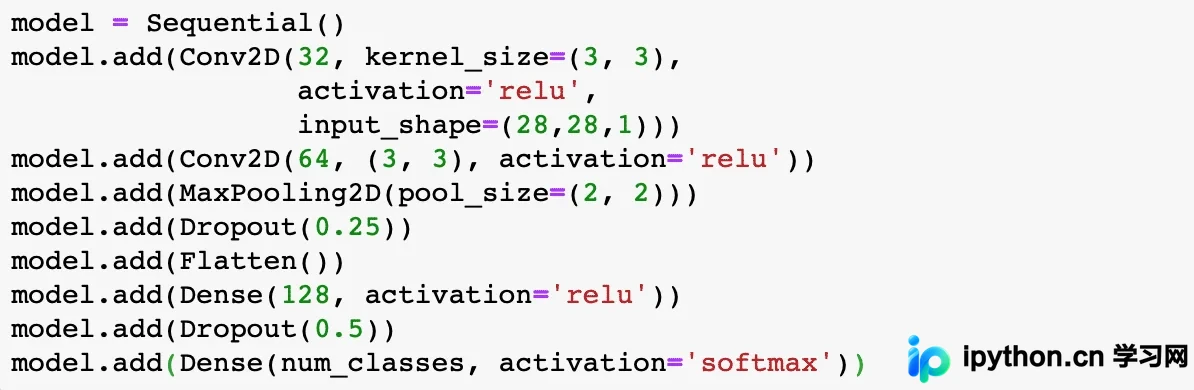
模型中加入了卷积层和池化层。激活函数选用relu,该函数在卷积神经网络及深度学习中应用广泛。层间还加入了dropout机制以降低过拟合风险。Dense layer用于最终的类别预测。
模型构建完成后,需进行验证以确保准确性符合预期。
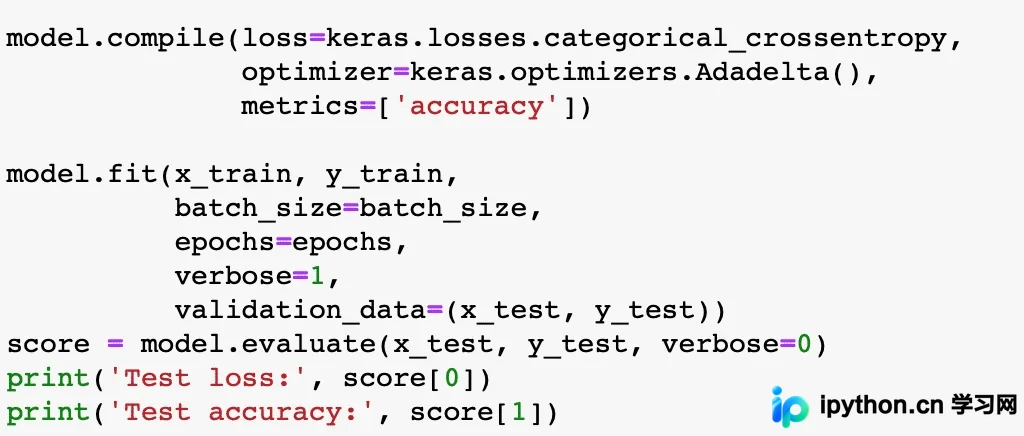
至此,建模预测的基本流程已完成。优秀的模型需要持续优化,提升精确度等指标,直至达到可接受的标准。
关于具体的优化过程,本文暂不深入探讨,留待后续讨论。
总结与挑战
4 总结
值得注意的是,尽管上述方法在理论上是可行的,但实际应用场景往往更为复杂,尤其是对识别精度的要求极高。
此外,若一张图片中包含多种垃圾,将显著增加分类模型的开发难度,使问题复杂化。
例如,对一杯奶茶进行垃圾分类时,照片中可能同时包含杯身、杯盖、残留液体及珍珠等多种物品,涉及不同类别,这使得单一类别的判断变得困难。
前路虽充满挑战,但本文的分享仅作为抛砖引玉的起点。
正如李白所言:“长风破浪会有时,直挂云帆济沧海”。
以上为本文全部内容,希望对读者有所帮助,欢迎支持本站。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















