


Python Selenium自动化测试:Page Object模式实战解析

本文深入剖析Selenium自动化测试中常见的代码混乱问题,并引入Page Object设计模式进行重构。通过对比传统写法与基于BasePage继承的Page模式,详细展示了如何分离页面元素定位与业务逻辑,从而显著提升测试用例的易读性、可扩展性、可复用性及可维护性,帮助开发者构建更稳健的Web自动化测试体系。
Selenium自动化测试的痛点分析
Selenium是目前广泛使用的Web自动化工具,支持Chrome、Firefox、IE等多种浏览器。开发者可以使用Java、C#、Python等熟悉语言编写测试用例,上手门槛较低。然而,在编写完首个自动化用例后,虽然初期可能感到兴奋,但审视代码结构时往往会发现逻辑杂乱无章,例如大量重复的find element调用,导致代码难以阅读。
__author__ = 'xua'

from selenium import webdriver
from selenium.webdriver.common.keys import Keys
import unittest

class TCRepeatLogin(unittest.TestCase):
  def setUp(self):

    #webdriver
    self.driver = webdriver.Chrome(r'C:\Users\xua\Downloads\chromedriver_win32\chromedriver.exe')
    self.driver.implicitly_wait(30)
    self.base_url = "http://10.222.30.145:9000/"

  def test_(self):
    driver = self.driver
    driver.get(self.base_url)

    #enter username and password
    driver.find_element_by_id("username").clear()
    driver.find_element_by_id("username").send_keys("sbxadmin")
    driver.find_element_by_id("password").clear()
    driver.find_element_by_id("password").send_keys("IGTtest1"+Keys.RETURN)

    #find dialog and check
    dialogTitle = driver.find_element(By.XPATH,'//html/body/div[7]/div/div/div[1]/h3')
    self.assertEqual("Sign in",dialogTitle.text)

    #find cancel button and click
    cancelBtn = driver.find_element(By.XPATH,'//html/body/div[7]/div/div/div[3]/button[2]')
    cancelBtn.click()

  def tearDown(self):
    self.driver.close()

if __name__ == "__main__":
  unittest.main()
针对上述代码结构,我们可以从以下几个维度进行深入分析:
1. 易读性差:代码难以理解,充斥着大量的find element调用,无法直观体现测试用例的逻辑意图。
2. 可扩展性弱:各个测试用例相互孤立,缺乏统一的架构支持,难以进行功能扩展。
3. 可复用性低:缺乏公共方法封装,导致代码片段难以在不同测试场景中复用。
4. 可维护性差:一旦页面元素发生变化,必须逐一修改所有相关的测试用例,维护工作量巨大。
Page Object模式架构设计
为解决上述问题,Python中引入了Page Object模式来管理测试逻辑。其基本架构如示意图所示(注:原图箭头示意TestCase指向各个Page类,因软件限制未作修改):
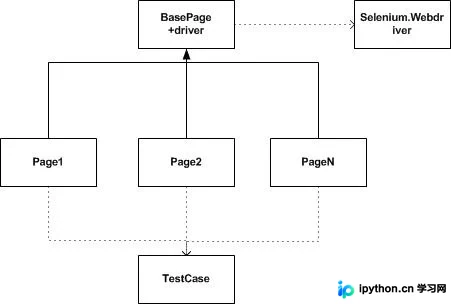
Page模式的核心设计原则如下:
1. 定义一个BasePage基类,该类包含指向Selenium WebDriver的实例属性,作为所有页面类的父类。
2. 每个具体的Web页面类继承自BasePage,通过driver获取页面元素,并将针对该页面的所有操作抽象为独立的方法。
3. 测试用例类(TestCase)继承自unittest.TestCase,并依赖具体的Page类来执行相应的测试步骤,实现逻辑与数据的分离。
利用Page模式重构后的代码如下:
BasePage.py实现:
__author__ = 'xua'

from selenium.webdriver.common.by import By
from selenium.webdriver.common.keys import Keys


#super class
class BasePage(object):
  def __init__(self, driver):
    self.driver = driver


class LoginPage(BasePage):

  #page element identifier
  usename = (By.ID,'username')
  password = (By.ID, 'password')
  dialogTitle = (By.XPATH,'//html/body/div[7]/div/div/div[1]/h3')
  cancelButton = (By.XPATH,'//html/body/div[7]/div/div/div[3]/button[2]')

  #Get username textbox and input username
  def set_username(self,username):
    name = self.driver.find_element(*LoginPage.usename)
    name.send_keys(username)

  #Get password textbox and input password, then hit return
  def set_password(self, password):
    pwd = self.driver.find_element(*LoginPage.password)
    pwd.send_keys(password + Keys.RETURN)

  #Get pop up dialog title
  def get_DiaglogTitle(self):
    digTitle = self.driver.find_element(*LoginPage.dialogTitle)
    return digTitle.text

  #Get "cancel" button and then click
  def click_cancel(self):
    cancelbtn = self.driver.find_element(*LoginPage.cancelButton)
    cancelbtn.click()
Test_Login.py实现:
__author__ = 'xua'

from selenium import webdriver
from selenium.webdriver.common.keys import Keys
from selenium.webdriver.common.alert import Alert
import unittest
import time
import BasePage

class Test_Login(unittest.TestCase):

  #Setup
  def setUp(self):
    self.driver = webdriver.Chrome(r'C:\Users\xua\Downloads\chromedriver_win32\chromedriver.exe')
    self.driver.implicitly_wait(30)
    self.base_url = "http://10.222.30.145:9000/"
  #tearDown
  def tearDown(self):
    self.driver.close()

  def test_Login(self):
    #Step1: open base site
    self.driver.get(self.base_url)
    #Step2: Open Login page
    login_page = BasePage.LoginPage(self.driver)
    #Step3: Enter username
    login_page.set_username("sbXadmin")
    #Step4: Enter password
    login_page.set_password("IGTtest1")
    #Checkpoint1: Check popup dialog title
    self.assertEqual(login_page.get_DiaglogTitle(),"Sign in")
    #Step5: Cancel dialog
    login_page.click_cancel()


if __name__ == "__main__":
  unittest.main()
Page模式优势验证
回顾重构后的代码,Page模式是否有效解决了前述四个方面的问题?
1. 易读性:观察test_login方法,逻辑清晰,每一步操作明确,符合测试用例的阅读习惯。
2. 可扩展性:由于每个页面的元素操作都封装在对应的Page类中,新增、删除或修改功能变得非常便捷。
3. 可复用性:Page中的基础操作被封装为方法,可以在不同的测试用例中重复调用,避免代码冗余。
4. 可维护性:若页面元素发生变更,只需修改对应Page类中的方法即可,无需改动具体的测试用例代码。
总结:
Page模式提供了一种优秀的页面逻辑与测试用例分离机制,有效降低了模块间的耦合度,提高了代码的内聚性,使Web自动化测试更加灵活高效。
以上就是本文的全部内容,希望对大家的学习有所帮助,也希望大家多多支持本站。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















