


Python实现快递单号识别:从条形码原理到Tesseract-OCR实战

本文详细解析了基于Python的快递单号识别方案。首先深入剖析EAN13条形码的结构、编码规则及校验算法,随后针对非标准快递条码,转向使用Tesseract-OCR引擎进行数字识别。文章提供了完整的代码实现,并重点解决了Python 2.7环境下的编码报错问题,为开发者提供实用的技术参考。
识别快递单号
项目背景与条形码基础
在近期与导师合作的项目中,主要任务是实现流水线上的快递单号自动识别。起初,我尝试从条形码的基础知识入手进行探索。
百度百科:条形码
条形码(barcode)是一种由宽度不等的多个黑条和空白,按照特定编码规则排列而成的图形标识符,用于表达一组信息。常见的条形码图案由反射率差异显著的黑条(条)和白条(空)平行排列组成。条形码能够标识物品的生产国、制造厂家、商品名称、生产日期、图书分类号、邮件起止地点、类别、日期等大量信息,因此在商品流通、图书管理、邮政管理、银行系统等众多领域得到了广泛应用。
条形码种类繁多,在我国应用最为广泛的是EAN13条形码(下文简称条形码),因此本研究主要聚焦于该种条形码的识别技术。
条形码位数说明:
- 条形码总共包含13位数字。
- 前2位或前3位被称为前缀,用于表示国家、地区或特定的商品类型。
- 中国区的条形码前缀范围为690~699。
- 图书类的条形码前缀范围为978~979。
- 前缀之后的4位或5位被称为厂商代码,用于标识产品制造商。
- 厂商代码之后的5位被称为商品代码,用于标识具体的商品项目。
- 最后1位是校验码,它是根据前12位数字计算得出的,主要用于防伪以及识别校验。
EAN13条形码结构与编码规则
条形码编码说明
条形码结构包含8个区域:左侧空白区、起始符、左侧数据符、中间分隔符、右侧数据符、校验符、终止符、右侧空白区。
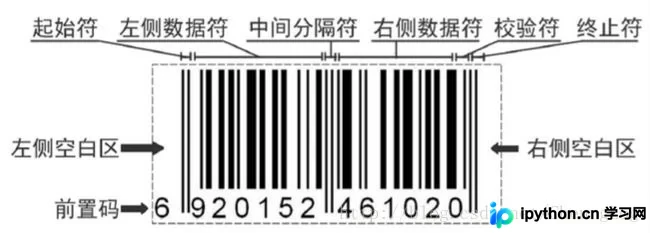
- 字符范围涵盖0~9。
- 除空白区外的所有区域和字符均采用二进制编码表示,其中1代表bar(黑条),0代表space(白条)。
- 起始符和终止符的编码均为101,中间分隔符的编码为01010。
- 0~9每个数字都有3种编码方式,其中AB代表左侧数据的奇偶编码,C代表右侧数据的偶编码。
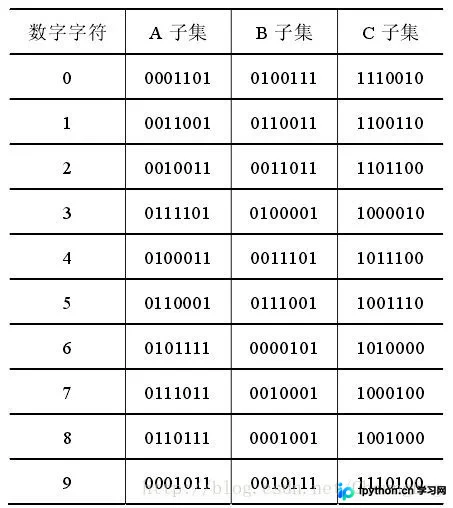
- 左侧数据的奇偶性由前置符决定(即第一个数字是几,就按照对应的排列规则开始)。
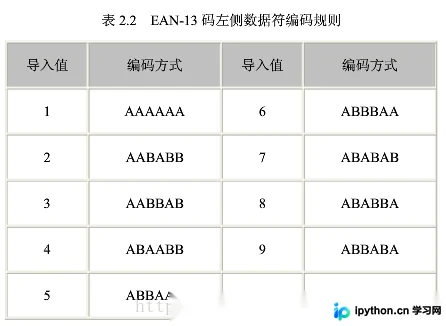
此外,还存在另一种理解编码方法的方式。
以宽度作为编码依据,去掉起始码、终止码和中间分隔码,无论白条还是黑条均视为一个编码单元。最窄的一节定义为单位宽度1,两个单位宽度即为2,三单位长度为3,四单位宽度为4。
四条(无论黑条还是白条均计为条)代表一个数字。
| 四条长度 | 数字 |
|---|---|
| 3211 | 0 |
| 2221 | 1 |
| 2122 | 2 |
| 1411 | 3 |
| 1132 | 4 |
| 1231 | 5 |
| 1114 | 6 |
| 1312 | 7 |
| 1213 | 8 |
| 3112 | 9 |
两种编码方式的图示对比如下。
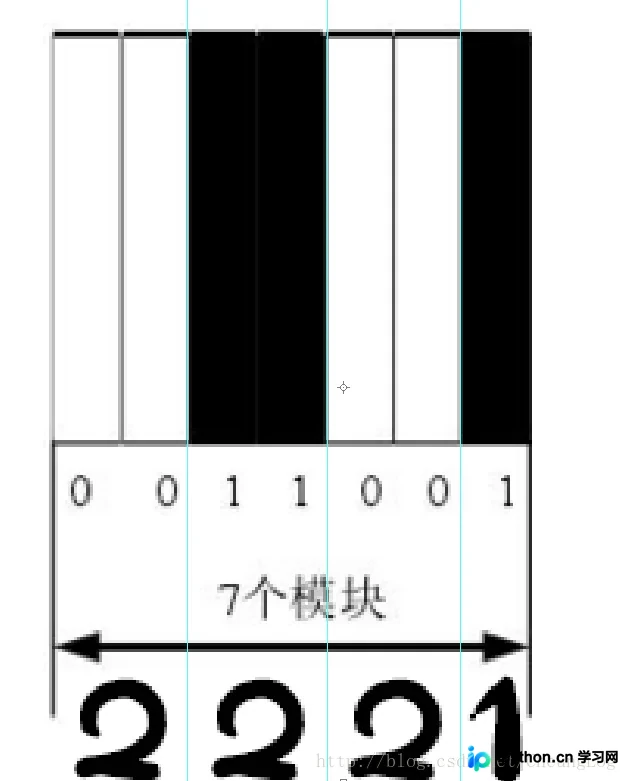
这代表数字1。
校验码计算机制
校验
EAN13条形码共13位,最后一位是校验位,该位是通过前12位按照特定步骤计算得出的。
如果按照特定步骤处理识别出的前12位数据,计算结果与识别出的结果相等,则判定识别正确。
如果不相等,则需要重新识别、进行纠错后再校验,或者提示识别失败。
校验码计算方法
以下图所示的条形码为例进行说明。

条形码的位数起始位为最右一位,即校验位,检验码计算方法如下:
- 偶位数数值相加后乘3((0+2+0+8+1+9)*3=60)。
- 不含校验位的奇位数相加(7+4+7+9+3+6=36)。
- 将前两步的结果相加(60+36=96)。
- 用10减去上一步结果的个位数数值(10-6=4)。
- 上一步结果的个位数即为校验码(4)。
条形码识别源码实现
源码
#创建:2016/01/26
#文件:BarCodeIdentification.py
#作者:moverzp
#功能:识别条形码
import sys
import cv2

DECODING_TABLE = {
  '0001101': 0, '0100111': 0, '1110010': 0,
  '0011001': 1, '0110011': 1, '1100110': 1,
  '0010011': 2, '0011011': 2, '1101100': 2,
  '0111101': 3, '0100001': 3, '1000010': 3,
  '0100011': 4, '0011101': 4, '1011100': 4,
  '0110001': 5, '0111001': 5, '1001110': 5,
  '0101111': 6, '0000101': 6, '1010000': 6,
  '0111011': 7, '0010001': 7, '1000100': 7,
  '0110111': 8, '0001001': 8, '1001000': 8,
  '0001011': 9, '0010111': 9, '1110100': 9,
  }

EDGE_TABLE = {
  2:{2:6,3:0,4:4,5:3},
  3:{2:9,3:'33',4:'34',5:5},
  4:{2:9,3:'43',4:'44',5:5},
  5:{2:6,3:0,4:4,5:3},
  }

INDEX_IN_WIDTH = (0, 4, 8, 12, 16, 20, 24, 33, 37, 41, 45, 49, 53)
def get_bar_space_width(img):
  row = img.shape[0] *1/2
  currentPix = -1
  lastPix = -1
  pos = 0
  width = []
  for i in range(img.shape[1]):#遍历一整行
    currentPix = img[row][i]
    if currentPix != lastPix:
      if lastPix == -1:
        lastPix = currentPix
        pos = i
      else:
        width.append( i - pos )
        pos = i
        lastPix = currentPix
  return width

def divide(t, l):
  if float(t) / l < 0.357:
    return 2
  elif float(t) / l < 0.500:
    return 3
  elif float(t) / l < 0.643:
    return 4
  else:
    return 5

def cal_similar_edge(data):
  similarEdge = []
  #先判断起始符
  limit = float(data[1] + data[2] + data[3] ) / 3 * 1.5
  if data[1] >= limit or data[2] >= limit or data[3] >= limit:
    return -1#宽度提取失败
  index = 4
  while index < 54:
    #跳过分隔符区间
    if index==28 or index==29 or index==30 or index==31 or index==32:
      index +=1
      continue
    #字符检测
    T1 = data[index] + data[index+1]
    T2 = data[index+1] + data[index+2]
    L = data[index] + data[index+1] + data[index+2] + data[index+3]
    similarEdge.append( divide(T1, L) )
    similarEdge.append( divide(T2, L) )
    index += 4

  return similarEdge

def decode_similar_edge(edge):
  barCode = [6]#第一个字符一定是6,中国区
  for i in range (0, 24, 2):#每个字符两个相似边,共12个字符
    barCode.append( EDGE_TABLE[edge[i]][edge[i+1]] )
  return barCode

def decode_sharp(barCode, barSpaceWidth):
  for i in range(0, 13):
    if barCode[i] == '44':
      index = INDEX_IN_WIDTH[i]
      c3 = barSpaceWidth[index+2]
      c4 = barSpaceWidth[index+3]
      if c3 > c4:
        barCode[i] = 1
      else:
        barCode[i] = 7
    elif barCode[i] == '33':
      index = INDEX_IN_WIDTH[i]
      c1 = barSpaceWidth[index]
      c2 = barSpaceWidth[index+1]
      if c1 > c2:
        barCode[i] = 2
      else:
        barCode[i] = 8
    elif barCode[i] == '34':
      index = INDEX_IN_WIDTH[i]
      c1 = barSpaceWidth[index]
      c2 = barSpaceWidth[index+1]
      if c1 > c2:
        barCode[i] = 7
      else:
        barCode[i] = 1
    elif barCode[i] == '43':
      index = INDEX_IN_WIDTH[i]
      c2 = barSpaceWidth[index+1]
      c3 = barSpaceWidth[index+2]
      if c2 > c3:
        barCode[i] = 2
      else:
        barCode[i] = 8

def check_bar_code(barCode):
  evens = barCode[11]+barCode[9]+barCode[7]+barCode[5]+barCode[3]+barCode[1]
  odds = barCode[10]+barCode[8]+barCode[6]+barCode[4]+barCode[2]+barCode[0]
  sum = evens * 3 + odds
  if barCode[12] == (10 - sum % 10) % 10:
    return True
  else:
    return False
#载入图像
img = cv2.imread('res\google6.jpg')
grayImg = cv2.cvtColor(img, cv2.COLOR_BGR2GRAY)#转换成单通道图像
ret, grayImg = cv2.threshold(grayImg, 200, 255, cv2.THRESH_BINARY)#二值化
grayImg = cv2.medianBlur(grayImg, 3)#中值滤波
#提取条空宽度
barSpaceWidth = get_bar_space_width(grayImg)
print 'bar & space\'s numbers:', len(barSpaceWidth)#只有60是正确的
print barSpaceWidth
#计算相似边数值
similarEdge = cal_similar_edge(barSpaceWidth)
if similarEdge == -1:
  print 'barSpaceWidth error!'
  sys.exit()
print 'similarEdge\'s numbers:', len(similarEdge)
print similarEdge
#相似边译码
barCode = decode_similar_edge(similarEdge)
#针对‘#'译码
decode_sharp(barCode, barSpaceWidth)
#校验
valid = check_bar_code(barCode)
valid = 1
print 'barcode:\n', barCode if valid else 'Check barcode error!'

height = img.shape[0]
width = img.shape[1]
cv2.line(grayImg, (0, height/2), (width, height/2),(0, 255, 0), 2)#画出扫描的行

#显示图像
cv2.imshow("origin", img)
cv2.imshow("result", grayImg)

key = cv2.waitKey(0)
if key == 27:
  cv2.destroyAllWindows()
第二种编码的程序
#-*- coding:utf-8 -*-
from PIL import Image

def clean(img):
  A = img.load()
  print A
  ss = ''
  for x in xrange(img.size[0]):
    ss += str(A[x, img.size[1]/2])
  print ss
  ls = []
  while len(ss) > 0:
    start = ss[0]
    j = 1
    while j < len(ss) and ss[j] == start :
      j += 1
    ls.append(j)
    ss = ss[j:]
  print ls
  return ls
  #print ls
def GetUPC_A(t):
  #print t
  t = t[4:-4]
  print len(t)
  for i in xrange(len(t)):
    t[i] = (t[i] + 1) / 4
  t = t[:24] + t[29:]
  s = ''
  for i in xrange(len(t)):
   s += str(t[i])
  upca = ''
  for i in range(0, len(s) / 4):
    n = i * 4
    upca += dic[s[n:n + 4]]
  print upca


dic = {'3211':'0', '2221':'1', '2122':'2', '1411':'3', '1132':'4', '1231':'5', '1114':'6', '1312':'7', '1213':'8', '3112':'9'}
img = Image.open('7.png')
GetUPC_A(clean(img))
转向OCR:Tesseract-OCR应用
遗憾的是,本次遇到的快递单上的条形码并非标准的EAN13条形码,其编码方式暂时不明。因此,我们转换思路,直接识别快递单上的数字快递单号。
这里我使用OCR引擎进行识别,具体选用的是Tesseract-OCR引擎。
Tesseract-OCR引擎简介
OCR(Optical Character Recognition):光学字符识别,是指对图片文件中的文字进行分析识别并获取的过程。Tesseract的OCR引擎最早由HP实验室于1985年开始研发,至1995年时已成为OCR业内最准确的三款识别引擎之一。然而,HP不久后决定放弃OCR业务,Tesseract也随之尘封。
数年后,HP意识到,与其将Tesseract束之高阁,不如贡献给开源软件界,让其重焕新生——2005年,Tesseract由美国内华达州信息技术研究所获得,并交由Google进行改进、消除Bug及优化工作。
(由于由Google管理,下载地址可能受限,此处不贴链接)。
另一个相关模块是pytesseract,这是对Google Tesseract的一层Python封装,需要配合PIL模块使用。
因此,本次识别快递单号涉及三个组件。
- Tesseract-OCR——直接下载exe文件,一路点击“next”即可完成安装。
- pytesseract模块——直接执行pip install pytesseract安装即可。
- PIL模块——由于我使用的是win7_64bit系统,原PIL不支持,因此改用pillow模块,直接执行pip install pillow即可。
源代码
#-*- coding:utf-8 -*-
from PIL import Image
import pytesseract
import time

start = time.clock()#开始计时
#---------主要代码------------
im = Image.open('66.png')
code = pytesseract.image_to_string(im)
print u'验证码:' + str(code)
#---------------------------------
end = time.clock()#结束计时

print u'运行时间:' + str(end-start)
Python环境编码问题排查与解决
有坑
在使用Git Bash调试时遇到了。
Traceback (most recent call last):
 File "111.py", line 10, in <module>
  print u'验证码:' + str(code)
UnicodeEncodeError: 'ascii' codec can't encode characters in position 0-2: ordinal not in range(128)
这显然是编码问题导致的,我使用的是python2.7,估计升级到python3就没有这个问题了。
但当前仍需解决此问题,针对编码问题有两种解决方法:
1. 一个解决方案是在程序中加入以下代码:
import sys
reload(sys)
sys.setdefaultencoding('utf8')
2. 是在python的Lib\site-packages文件夹下新建一个sitecustomize.py,内容为:
# encoding=utf8
import sys
reload(sys)
sys.setdefaultencoding('utf8')
此时重启python解释器,执行sys.getdefaultencoding(),发现编码已被设置为utf8。多次重启后效果相同,这是因为系统在python启动时会自动调用该文件,设置系统的默认编码,无需每次手动添加解决代码,属于一劳永逸的解决方法。
以上就是本文的全部内容,希望对大家的学习有所帮助,也希望大家多多支持本站。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















