


Python实现图片文字与数字分割的代码示例

发布时间:2026-10-13 |
1人浏览过
本文介绍使用Python和OpenCV库实现图片中文字及数字分割的具体方法。通过遍历图像像素,识别非全黑行与列来定位文字区域,并根据最小像素高度和宽度阈值进行行列分割。最终将分割后的字符区域统一缩放至指定尺寸并保存,适用于OCR前的预处理步骤。
Python图片文字分割实现概述
本文提供了一段使用Python实现图片中文字分割的具体代码,供读者参考学习。
数字与文字分割效果展示
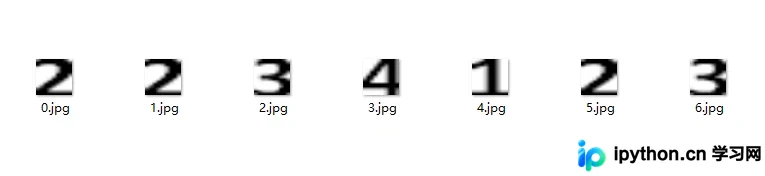
首先展示包含数字的原始图片及其分割结果。
接着展示包含文字内容的原始图片及其对应的分割结果图。
随后展示包含更多文字内容的原始图片及分割后的效果。
最后展示另一组包含文字的原始图片及其分割结果。

核心分割代码解析
以下是实现上述功能的核心代码逻辑。
import cv2
import numpy as np

path = 'test.jpg'
root = 'output\\'
# 图像resize
dsize = 36
img = cv2.imread(path)
data = np.array(img)
height = data.shape[0]
width = data.shape[1]
# 设置最小的文字像素高度
min_val = 10

start_i = -1
end_i = -1
# 存放每行的起止坐标
rowinfo = []

# 行分割
for i in range(height):

 # 行中有字相关信息
 if (not data[i].all()):
 end_i = i
 if(start_i < 0):
 start_i = i
 pass
 # 行中无字相关信息
 elif (data[i].all() and start_i >= 0):
 if(end_i - start_i >= min_val):
 rowinfo.append((start_i, end_i))
 pass
 start_i, end_i = -1, -1
print(rowinfo)

# 列分割
start_j = -1
end_j = -1
# 最小文字像素宽度
min_val_word = 5
# 分割后保存编号
number = 0
for start, end in rowinfo:
 for j in range(width):
 # 列中有字相关信息
 if(not data[start: end, j].all()):
 end_j = j
 if(start_j < 0):
  start_j = j
  pass
 # 列中无字信息
 elif(data[start: end, j].all() and start_j >= 0):
 if(end_j - start_j >= min_val_word):
 img = data[start:end, start_j: end_j]
 im2save = cv2.resize(img, (dsize, dsize)) #归一化处理
 cv2.imwrite(root + '%d.jpg' % number, im2save)
 number += 1
 pass
 start_j, end_j = -1, -1
以上即为本文分享的全部内容,希望能为读者的编程学习提供有益帮助,同时也欢迎大家继续支持本站获取更多技术资源。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















