



不少 PHP 项目在迁移到 Go 之后,最先遇到的问题不是业务逻辑,而是历史数据兼容。像 serialize() 和 unserialize() 这类 PHP 原生序列化内容,如果还存放在数据库、缓存或接口里,Go 端就必须能继续读写。本文先说明这类数据为什么能在 Go 中处理,再用现成库演示基本做法,最后补充跨语言项目里更适合长期使用的序列化选择。
为什么 Go 也能处理 PHP 的序列化数据
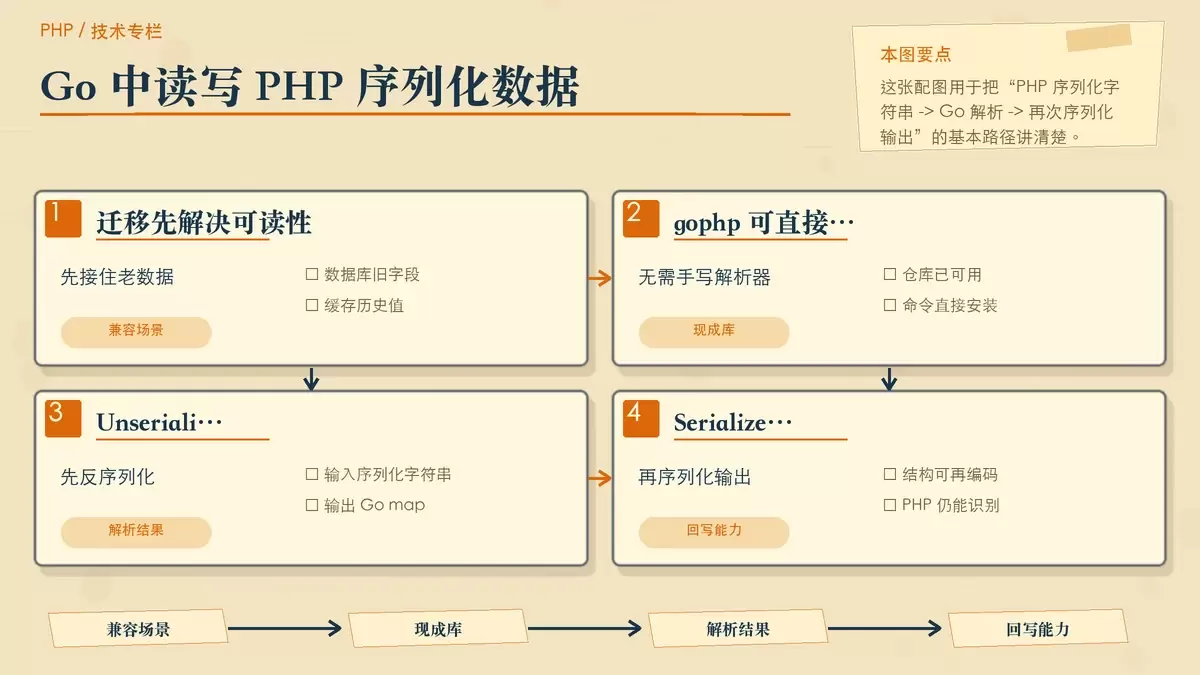
PHP 的 serialize() 并不是黑盒,它本质上是一套明确的编码规则。只要按这套规则实现解析和编码,Go 同样可以完成 PHP 风格的序列化与反序列化。
这也是很多迁移项目的常见思路:先保证老数据可读,再逐步决定是否保留原格式,或过渡到更通用的跨语言协议。
直接可用的 Go 方案:gophp
如果不打算自己手写解析器,可以直接使用 Github 上已有的实现库:gophp。
go get -u github.com/leeqvip/gophp对应仓库为:https://github.com/leeqvip/gophp。
下面是官方给出的基础示例,展示了 Go 中如何完成 PHP 的 unserialize() 和 serialize():
package main

import (
    "fmt"

    "github.com/leeqvip/gophp"
)

func main() {

    str := `a:1:{s:3:"php";s:24:"世界上最好的语言";}`

    // unserialize() in php
    out, _ := gophp.Unserialize([]byte(str))

    fmt.Println(out) //map[php:世界上最好的语言]

    // serialize() in php
    jsonbyte, _ := gophp.Serialize(out)

    fmt.Println(string(jsonbyte)) // a:1:{s:3:"php";s:24:"世界上最好的语言";}
}
这个示例说明了什么
示例中的字符串:
a:1:{s:3:"php";s:24:"世界上最好的语言";}本质上是一段 PHP 序列化后的数组数据。传给 gophp.Unserialize([]byte(str)) 之后,Go 可以把它还原成可操作的数据结构;再调用 gophp.Serialize(out),又能重新生成 PHP 可识别的序列化字符串。
对于需要兼容旧数据库字段、缓存值或消息内容的场景,这种方式很直接,改造成本也相对低。
跨语言项目里,序列化格式该怎么选
Go 自己也有原生序列化方式,比如 gob。但如果项目本身涉及 PHP、Go,甚至后续还可能接入其他语言,就不太建议把数据长期绑定在某一种语言专有格式上。
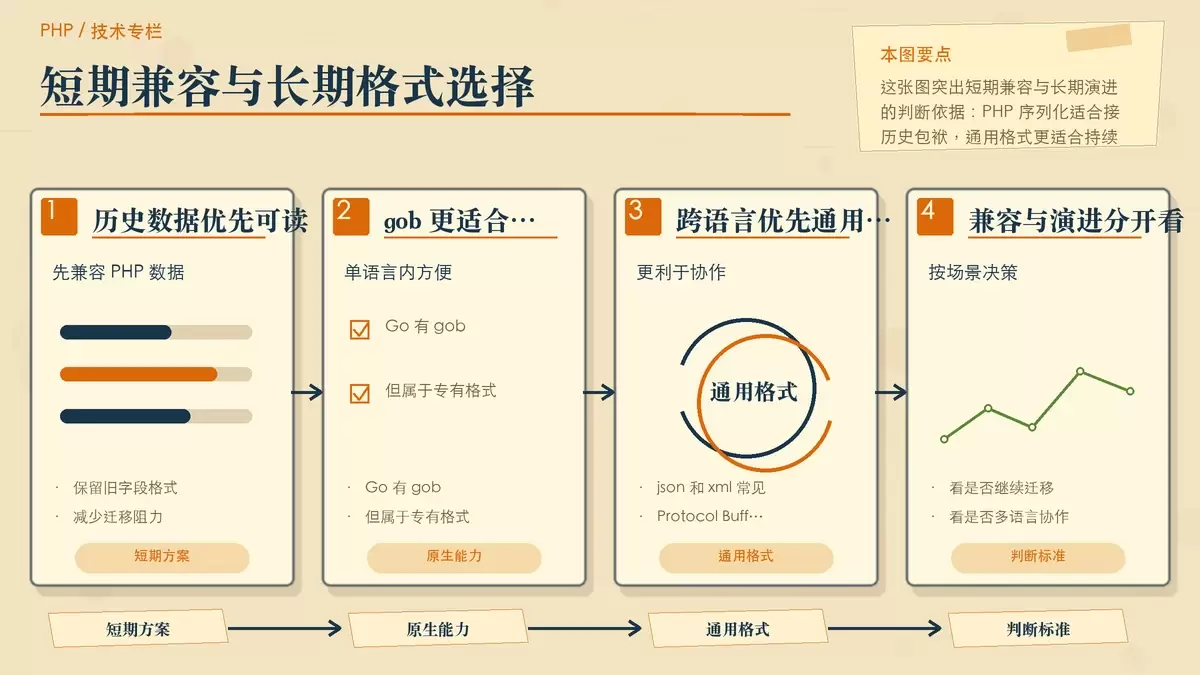
原因很简单:语言专有协议在单一技术栈里用起来方便,一旦服务拆分、重写或迁移,就容易出现兼容负担,最后还是得重新补一轮解析逻辑。
更适合跨语言协作的常见选择包括:
json、xml、Protocol Buffer
如果当前目标只是“让 Go 接住 PHP 历史数据”,继续解析 PHP 的序列化内容是合理方案;如果目标是“为后续多语言协作打基础”,那就应尽早评估把数据格式逐步迁移到更通用的协议上。















