


Python实现哈夫曼树编码:原理、代码解析与完整流程

本文详细解析Python中哈夫曼树的构建与编码过程。从树节点类定义、优先度队列管理,到字符频率统计、中序遍历生成编码表,最后实现字符串的编码与解码。通过逐段代码分析,帮助读者理解哈夫曼编码的核心逻辑与递归实现,适用于Python初学者及算法爱好者参考。
哈夫曼树原理与流程概述
哈夫曼树原理
遵循精简实用的原则,关于哈夫曼树的理论背景及具体构建方法,建议参考相关技术博客以获取更详尽的背景知识。
https://www.jb51.net/article/97396.htm
其大概流程
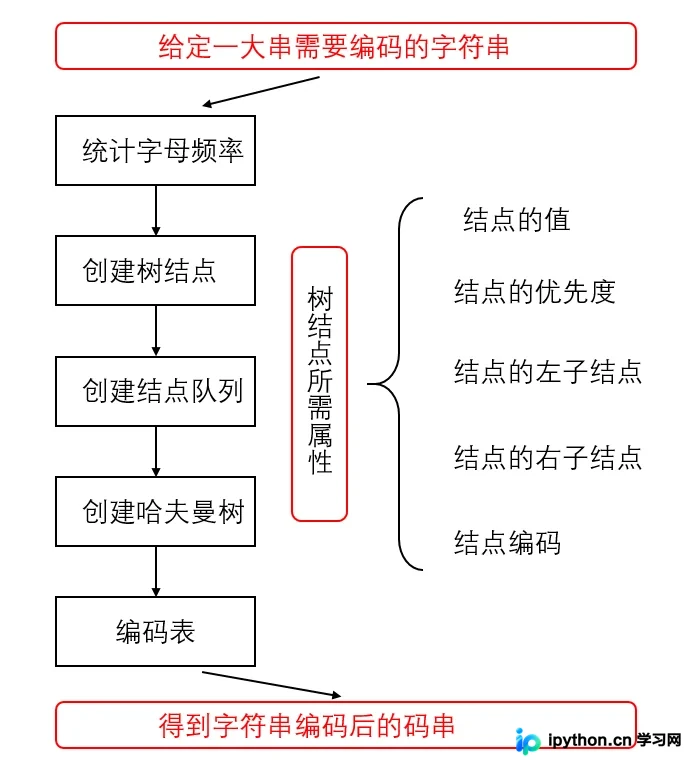
哈夫曼编码Python实现代码解析
哈夫曼编码代码
核心数据结构与队列管理
# 树节点类构建
class TreeNode(object):
  def __init__(self, data):
    self.val = data[0]
    self.priority = data[1]
    self.leftChild = None
    self.rightChild = None
    self.code = ""
# 创建树节点队列函数
def creatnodeQ(codes):
  q = []
  for code in codes:
    q.append(TreeNode(code))
  return q
# 为队列添加节点元素,并保证优先度从大到小排列
def addQ(queue, nodeNew):
  if len(queue) == 0:
    return [nodeNew]
  for i in range(len(queue)):
    if queue[i].priority >= nodeNew.priority:
      return queue[:i] + [nodeNew] + queue[i:]
  return queue + [nodeNew]
# 节点队列类定义
class nodeQeuen(object):

  def __init__(self, code):
    self.que = creatnodeQ(code)
    self.size = len(self.que)

  def addNode(self,node):
    self.que = addQ(self.que, node)
    self.size += 1

  def popNode(self):
    self.size -= 1
    return self.que.pop(0)
# 各个字符在字符串中出现的次数,即计算优先度
def freChar(string):
  d ={}
  for c in string:
    if not c in d:
      d[c] = 1
    else:
      d[c] += 1
  return sorted(d.items(),key=lambda x:x[1])
# 创建哈夫曼树
def creatHuffmanTree(nodeQ):
  while nodeQ.size != 1:
    node1 = nodeQ.popNode()
    node2 = nodeQ.popNode()
    r = TreeNode([None, node1.priority+node2.priority])
    r.leftChild = node1
    r.rightChild = node2
    nodeQ.addNode(r)
  return nodeQ.popNode()

codeDic1 = {}
codeDic2 = {}
# 由哈夫曼树得到哈夫曼编码表
def HuffmanCodeDic(head, x):
  global codeDic, codeList
  if head:
    HuffmanCodeDic(head.leftChild, x+'0')
    head.code += x
    if head.val:
      codeDic2[head.code] = head.val
      codeDic1[head.val] = head.code
    HuffmanCodeDic(head.rightChild, x+'1')
# 字符串编码
def TransEncode(string):
  global codeDic1
  transcode = ""
  for c in string:
    transcode += codeDic1[c]
  return transcode
# 字符串解码
def TransDecode(StringCode):
  global codeDic2
  code = ""
  ans = ""
  for ch in StringCode:
    code += ch
    if code in codeDic2:
      ans += codeDic2[code]
      code = ""
  return ans
# 举例
string = "AAGGDCCCDDDGFBBBFFGGDDDDGGGEFFDDCCCCDDFGAAA"
t = nodeQeuen(freChar(string))
tree = creatHuffmanTree(t)
HuffmanCodeDic(tree, '')
print(codeDic1,codeDic2)
a = TransEncode(string)
print(a)
aa = TransDecode(a)
print(aa)
print(string == aa)
接下来对代码进行分段解析。
1.树结点类的构建:
该类包含五个核心属性:节点的值、节点的优先度(权重)、左子节点、右子节点以及节点值的编码字符串。这些属性均为构建哈夫曼树所必需。
2.创建树结点队列函数:
针对所有字母节点,我们需要将其组织为一个队列,此处使用Python的list列表来实现队列功能。将所有树节点放入列表中,传入的参数应为已按优先度从小到大排序的元素列表。
3.为队列添加节点元素,并保证优先度从大到小排列:
当生成新的内部节点时,需将其插入列表中的合适位置,以确保队列始终保持按优先度从小到大排列的顺序。
4.结点队列类定义:
类初始化时接收一个列表作为参数,列表中的每个元素是由字母与优先度组成的元组。元组的第一个元素为字母,第二个元素为该字母在文本中出现的次数(即优先度)。
在类初始化过程中,调用“创建树结点队列函数”,将队列中的每个元素转换为对应的树节点对象。
该类还包含一个记录队列规模的属性,以及两个操作函数:添加节点函数和弹出节点函数。
添加节点函数直接调用前文定义的插入函数,输入参数为当前队列和新节点,同时队列规模加一。
弹出第一个元素则直接调用列表的pop(0)函数,同时队列规模减一。
5.计算文本中个字母的优先度,即出现的次数:
字符频率统计与编码表生成
定义一个字典,遍历文本中的每一个字母。若字母不在字典中,说明是第一次出现,则将该字母设为键,初始值为1;若字母已在字典中,则将其对应的值加一。遍历结束后,即可得到每个字母出现的次数。
6.由哈夫曼树得到编码表:
这里定义了两个全局字典,分别用于存放编码和解码信息。一个字典用于生成编码,另一个用于逆向解码,这样设计便于程序后续操作。
核心逻辑在于遍历,采用二叉树的中序遍历方式。若理解中序遍历,即可看懂此段代码:每递归深入一层,便在路径上追加一个‘0’(代表左子树)或‘1’(代表右子树)。
中序遍历的具体实现可参考前文博客,若已掌握则可跳过此段说明。
这一段是哈夫曼编码的关键与难点,建议仔细理解,这也是对递归思维的一次良好训练。若此点无误,哈夫曼树的实现便相对简单。
字符串编码与解码实现
7.字符串编码,字符串解码:
这两部分代码不再赘述。由于已生成编码与解码字典,只需在字典中查找对应字母即可。字典的查找速度相当快,因此效率较高。
示例不再列举,总体而言,哈夫曼树的实现比之前的八皇后问题或KMP算法更为直观简单。
最后向Huffman大神致敬,祝各位学有所成。
以上就是本文的全部内容,希望对大家的学习有所帮助,也希望大家多多支持本站。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















