


Python实现语音交互:PyAudio录音、百度AI识别与FFmpeg播放完整教程

本文详解如何使用Python的PyAudio库实现麦克风录音,并通过FFmpeg将WAV格式转换为百度AI语音识别所需的PCM格式。结合百度AI的语音识别与合成接口,利用os模块调用ffplay实现自动播放,构建从录音、识别、合成到播放的完整自动化问答交互流程。
Python音频处理与PyAudio简介
Python之所以功能强大,得益于其拥有庞大的第三方库生态和丰富的资源,其中自然也不缺乏处理音频的相关库。
在音频处理领域,PyAudio是一个常用的库,它支持开启麦克风进行录音以及播放音频文件等功能。本文将聚焦于如何利用该库实现录音功能。
首先,需要通过pip工具安装PyAudio库。
pip install pyaudio
PyAudio实现麦克风录音
一.PyAudio 实现麦克风录音
接下来,创建一个Python文件并复制以下代码。
import pyaudio
import wave
CHUNK = 1024
FORMAT = pyaudio.paInt16
CHANNELS = 2
RATE = 16000
RECORD_SECONDS = 2
WAVE_OUTPUT_FILENAME = "Oldboy.wav"
p = pyaudio.PyAudio()
stream = p.open(format=FORMAT,
    channels=CHANNELS,
    rate=RATE,
    input=True,
    frames_per_buffer=CHUNK)
print("开始录音,请说话......")
frames = []
for i in range(0, int(RATE / CHUNK * RECORD_SECONDS)):
 data = stream.read(CHUNK)
 frames.append(data)
print("录音结束,请闭嘴!")
stream.stop_stream()
stream.close()
p.terminate()
wf = wave.open(WAVE_OUTPUT_FILENAME, 'wb')
wf.setnchannels(CHANNELS)
wf.setsampwidth(p.get_sample_size(FORMAT))
wf.setframerate(RATE)
wf.writeframes(b''.join(frames))
wf.close()
运行代码后,目录中会生成一个 Oldboy.wav 文件,播放该文件可以听到清晰的录音效果。
随后,将上述录音代码封装为一个函数,以便在需要录音时直接调用。
新建一个名为pyrec.py的文件,将录音代码及封装好的函数写入其中。
# pyrec.py 文件内容
import pyaudio
import wave
CHUNK = 1024
FORMAT = pyaudio.paInt16
CHANNELS = 2
RATE = 16000
RECORD_SECONDS = 2
def rec(file_name):
 p = pyaudio.PyAudio()
 stream = p.open(format=FORMAT,
     channels=CHANNELS,
     rate=RATE,
     input=True,
     frames_per_buffer=CHUNK)
 print("开始录音,请说话......")
 frames = []
 for i in range(0, int(RATE / CHUNK * RECORD_SECONDS)):
  data = stream.read(CHUNK)
  frames.append(data)
 print("录音结束,请闭嘴!")
 stream.stop_stream()
 stream.close()
 p.terminate()
 wf = wave.open(file_name, 'wb')
 wf.setnchannels(CHANNELS)
 wf.setsampwidth(p.get_sample_size(FORMAT))
 wf.setframerate(RATE)
 wf.writeframes(b''.join(frames))
 wf.close()
rec函数即为封装后的录音接口,传入文件名参数后,程序会自动将声音数据写入指定文件。
音频格式转换与百度AI语音识别
二.实现音频格式自动转换 并 调用语音识别
录音功能解决后,接下来尝试将其与百度语音识别服务对接使用。
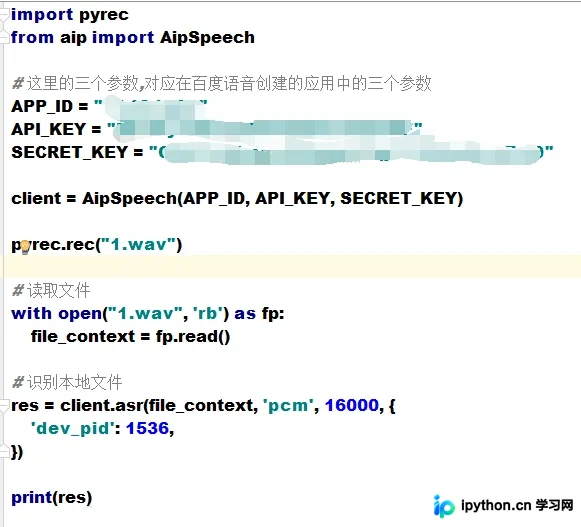
无论录音多么清晰,调用百度接口后往往返回错误信息。
{'err_msg': 'speech quality error.', 'err_no': 3301, 'sn': '6397933501529645284'} # 音质不清晰这并非识别失败,而是百度语音识别服务对音频格式有特定要求,仅支持PCM格式。
因此,必须将录制生成的WAV音频文件转换为PCM格式文件。
创建一个名为 wav2pcm.py的文件,其中包含专门用于转换WAV文件的函数。
利用os模块中的os.system()方法,该方法用于执行系统命令,例如Windows系统中cmd窗口支持的dir、cd等命令。
# wav2pcm.py 文件内容
import os
def wav_to_pcm(wav_file):
 # 假设 wav_file = "音频文件.wav"
 # wav_file.split(".") 得到["音频文件","wav"] 拿出第一个结果"音频文件" 与 ".pcm" 拼接 等到结果 "音频文件.pcm"
 pcm_file = "%s.pcm" %(wav_file.split(".")[0])
 # 就是此前我们在cmd窗口中输入命令,这里面就是在让Python帮我们在cmd中执行命令
 os.system("ffmpeg -y -i %s -acodec pcm_s16le -f s16le -ac 1 -ar 16000 %s"%(wav_file,pcm_file))
 return pcm_file
至此,我们拥有了将WAV转换为PCM的函数,并重新构建主程序代码。
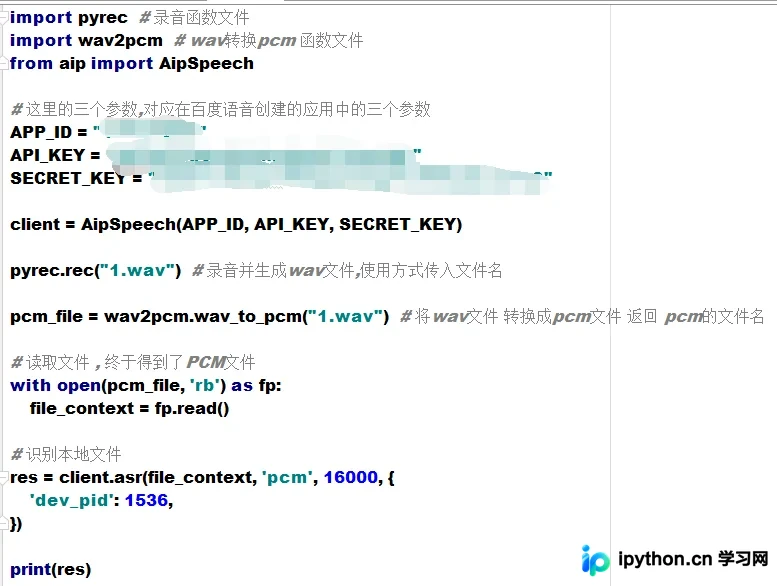
再次运行后,返回结果令人满意。
{'corpus_no': '6569869134617218414', 'err_msg': 'success.', 'err_no': 0, 'result': ['老男孩教育'], 'sn': '8116162981529666859'}获取到语音识别后的字符串,接下来利用该字符串进行语音合成,模拟程序“学习”用户所说的话。
语音合成与FFmpeg播放实现
三.语音合成 与 FFmpeg 播放mp3 文件
获取识别字符串后,直接调用synthesis方法进行语音合成。
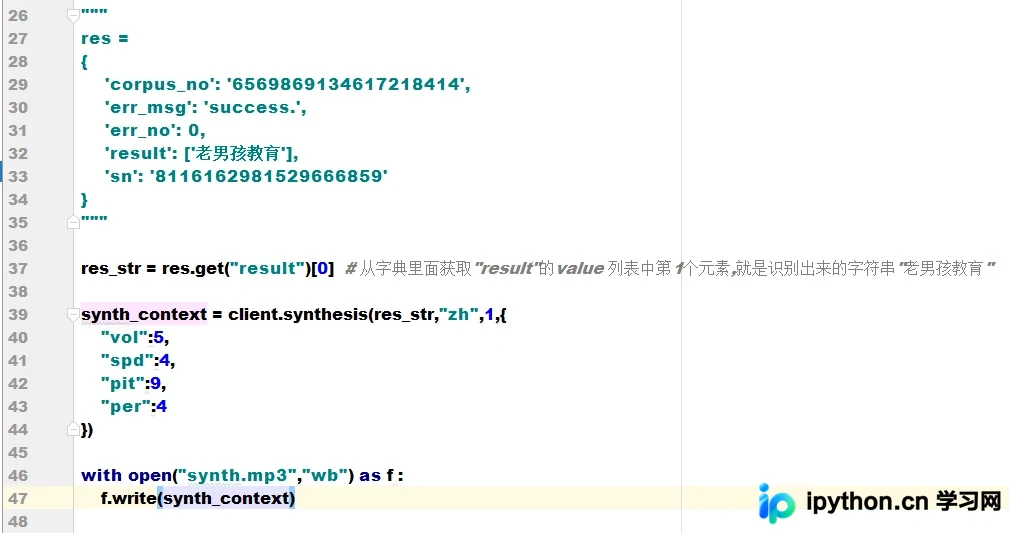
这段代码衔接上一部分,成功生成了synth.mp3音频文件,确认程序正在复述用户的话。
接下来需要让程序自动播放synth.mp3音频文件。虽然PyAudio具备播放功能,但操作较为复杂。
因此,我们选择更简单直接的方式来解决复杂问题,即利用FFmpeg工具。
FFmpeg系统工具中包含ffplay组件,用于打开并播放音频文件,基本用法为:ffplay 音频文件.mp3。
创建一个playmp3.py文件,编写一个名为play_mp3的函数用于播放已合成的语音。
# playmp3.py 文件内容
import os
def play_mp3(file_name):
os.system("ffplay %s"%(file_name))回到主文件,调用playmp3.py中的play_mp3 函数。
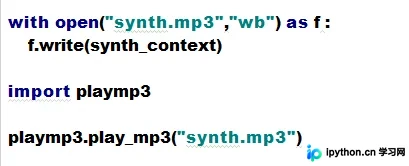
执行代码,当屏幕显示:开始录音,请说话......
请大声说出:学IT 找老男孩教育
随后即可听到一个柔和的声音重复你刚才说的话。
构建简单问答交互系统
四.简单问答
首先对代码结构进行重新梳理。
将语音合成与语音识别部分的代码独立封装为函数,并放入baidu_ai.py文件中。
# baidu_ai.py 文件内容
from aip import AipSpeech
# 这里的三个参数,对应在百度语音创建的应用中的三个参数
APP_ID = "xxxxx"
API_KEY = "xxxxxxx"
SECRET_KEY = "xxxxxxxx"
client = AipSpeech(APP_ID, API_KEY, SECRET_KEY)
def audio_to_text(pcm_file):
 # 读取文件 , 终于得到了PCM文件
 with open(pcm_file, 'rb') as fp:
  file_context = fp.read()
 # 识别本地文件
 res = client.asr(file_context, 'pcm', 16000, {
  'dev_pid': 1536,
 })
 # 从字典里面获取"result"的value 列表中第1个元素,就是识别出来的字符串"老男孩教育"
 res_str = res.get("result")[0]
 return res_str
def text_to_audio(res_str):
 synth_file = "synth.mp3"
 synth_context = client.synthesis(res_str, "zh", 1, {
  "vol": 5,
  "spd": 4,
  "pit": 9,
  "per": 4
 })
 with open(synth_file, "wb") as f:
  f.write(synth_context)
 return synth_file
随后对主文件代码进行相应修改。
import pyrec # 录音函数文件
import wav2pcm # wav转换pcm 函数文件
import baidu_ai # 语音合成函数,语音识别函数 文件
import playmp3 # 播放mp3 函数 文件
pyrec.rec("1.wav") # 录音并生成wav文件,使用方式传入文件名
pcm_file = wav2pcm.wav_to_pcm("1.wav") # 将wav文件 转换成pcm文件 返回 pcm的文件名
res_str = baidu_ai.audio_to_text(pcm_file) # 将转换后的pcm音频文件识别成 文字 res_str
synth_file = baidu_ai.text_to_audio(res_str) # 将res_str 字符串 合成语音 返回文件名 synth_file
playmp3.play_mp3(synth_file) # 播放 synth_file
接下来充分发挥想象力,实现更丰富的交互。
res_str 是识别得到的字符串,当字符串等于"你叫什么名字"时,程序应回答:我的名字叫老男孩教育。
新建一个FAQ.py文件,并建立一个名为faq的函数。
# FAQ.py 文件内容
def faq(Q):
 if Q == "你叫什么名字": # 问题
  return "我的名字是老男孩教育" # 答案
  return "我不知道你在说什么" #问题没有答案时返
在主文件中导入该函数,并将语音识别后的字符串作为参数传入。
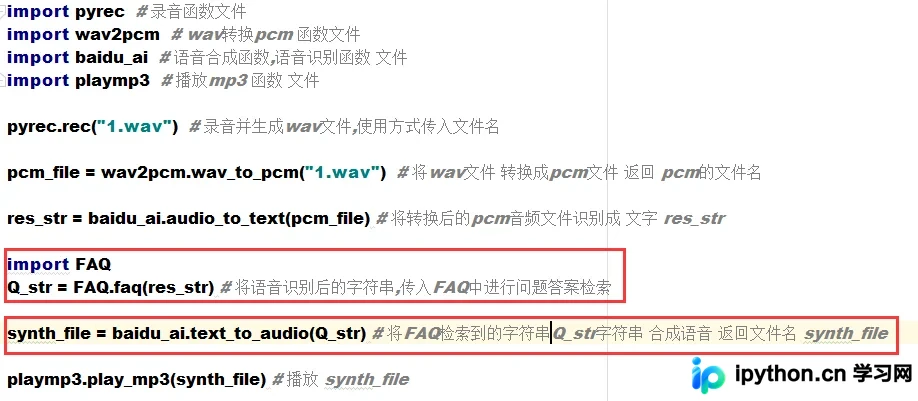
现在尝试提问:"你叫什么名字","你今年几岁了"。
测试成功,现在你可以对FAQ.py文件进行更多问题的匹配扩展。
仍需提醒,请勿过度测试导致程序异常。
思考题:
1.如何实现持续问答而无需每次提问后暂停?
2.面对大量问题,是否都需要编写对应的问答逻辑?
3.如果用户问“你是谁”,是否需要重复输出“我的名字叫老男孩教育”这一固定答案?
总结
以上介绍了Python人工智能之路中,利用PyAudio实现录音、自动化交互及问答的完整流程,希望有所帮助。如有疑问请留言,小编会及时回复。感谢大家对本站的支持! 如果觉得本文对你有帮助,欢迎转载,烦请注明出处,谢谢!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















