



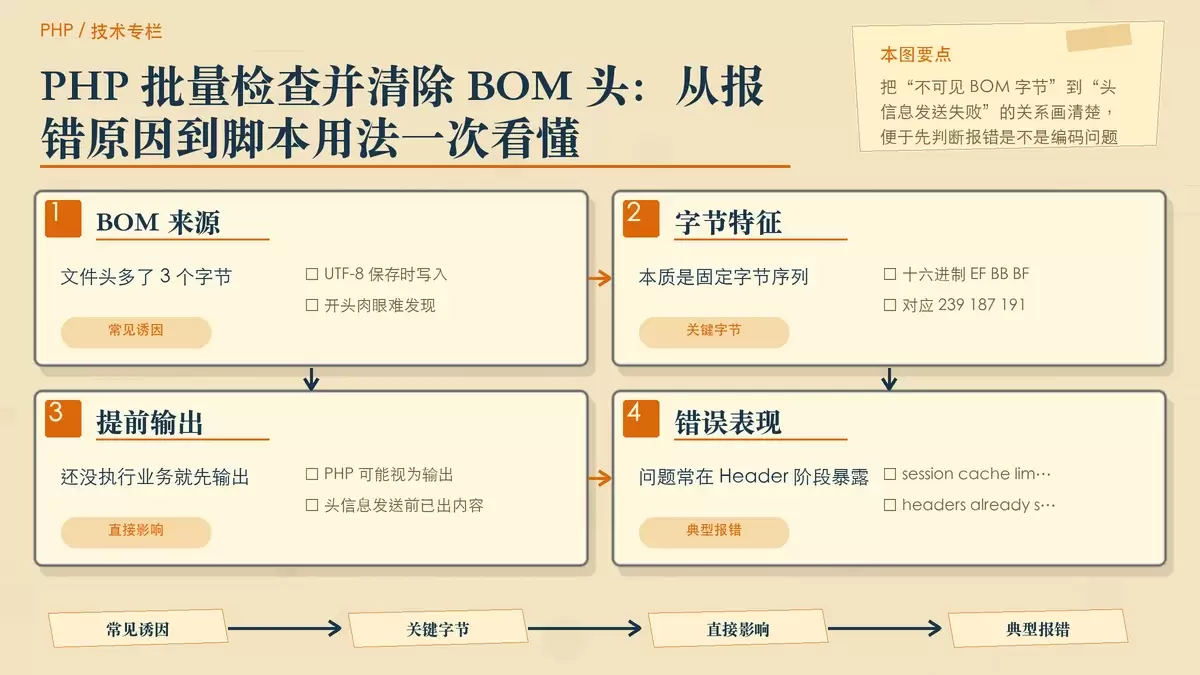
在 PHP 项目里,遇到 Cannot send session cache limiter - headers already sent (output started at...) 这类报错,很多人第一反应会去查 session_start() 或输出顺序,但真正的原因有时出在文件最前面那几个看不见的字节上。本文把这类问题拆开讲清楚:先解释 BOM 为什么会影响 PHP 输出,再整理一段批量扫描并清除 BOM 头的脚本,最后补上实际使用时应该注意的限制,方便你判断该不该直接上脚本处理。
为什么 BOM 会让 PHP 提前输出内容
在 Windows 下,如果用记事本之类的程序把文本文件保存为 UTF-8,文件开头有时会被写入几个不可见字符:EF BB BF。这就是常说的 BOM,完整名称是 Byte Order Mark。
对普通文本来说,这几个字节通常不容易被注意到;但对 PHP 文件来说,如果它们出现在脚本最前面,PHP 可能会把它们当成实际输出的一部分。这样一来,后面再调用需要发送 HTTP 头信息的操作,比如 Session、Cookie 或重定向,就可能触发下面这类错误:
Cannot send session cache limiter - headers already sent (output started at...) on line ...
所以这类报错并不一定代表业务代码逻辑有问题,也可能只是某个文件在保存时混入了 BOM 头。项目文件一多,手工逐个排查并不现实,这时候批量检查脚本就更有价值。
用于批量检查并清除 BOM 的 PHP 脚本
下面这段脚本的思路比较直接:从指定目录开始递归遍历,读取每个文件的前 3 个字节,判断是否等于 239、187、191,也就是 EF BB BF。如果命中,并且启用了自动处理,就把前 3 个字节去掉后重写文件。
<?php
if (isset($_GET['dir'])) {
    // config the basedir
    $basedir = $_GET['dir'];
} else {
    $basedir = '.';
}

$auto = 1;

checkdir($basedir);
function checkdir($basedir)
{
    if ($dh = opendir($basedir)) {
        while (($file = readdir($dh)) !== false) {
            if ($file != '.' && $file != '..') {
                if (!is_dir($basedir . "/" . $file)) {
                    // 如果是文件
                    echo "filename: $basedir/$file " . checkBOM("$basedir/$file") . "
";
                } else {
                    $dirname = $basedir . "/" . $file; // 如果是目录
                    checkdir($dirname); // 递归
                }
            }
        }
        closedir($dh);
    }
}
function checkBOM($filename)
{
    global $auto;
    $contents   = file_get_contents($filename);
    $charset[1] = substr($contents, 0, 1);
    $charset[2] = substr($contents, 1, 1);
    $charset[3] = substr($contents, 2, 1);
    if (ord($charset[1]) == 239 && ord($charset[2]) == 187 && ord($charset[3]) == 191) {
        // BOM
        // 的前三个字符的ASCII
        // 码分别为
        // 239
        // 187
        // 191
        if ($auto == 1) {
            $rest = substr($contents, 3);
            rewrite($filename, $rest);
            return ("");
        } else {
            return ("");
        }
    } else {
        return ("BOM Not Found.");
    }

}
function rewrite($filename, $data)
{
    $filenum = fopen($filename, "w");
    flock($filenum, LOCK_EX);
    fwrite($filenum, $data);
    fclose($filenum);
}
脚本入口做了什么
脚本先检查是否传入了 $_GET['dir']。如果传了,就把这个目录作为扫描起点;如果没有传,则默认使用当前目录 '.'。
这意味着它既可以直接放在项目目录里运行,也可以通过参数指定某个子目录做处理。对于只想清理模板目录、配置目录或老旧模块的场景,这种写法比较省事。
递归扫描目录的实现方式
checkdir($basedir) 使用 opendir()、readdir() 遍历目录项,并跳过 . 和 ..。遇到普通文件时,调用 checkBOM() 检测;遇到目录时,则继续递归进入下一级目录。
这个实现没有限制文件类型,因此理论上会检查目录下的所有文件。它的优点是简单,缺点也很明显:如果目录里包含图片、压缩包或其他二进制文件,虽然未必一定出错,但并不是最稳妥的处理方式。
脚本是如何判断并移除 BOM 的
真正的核心逻辑在 checkBOM($filename) 里。脚本先用 file_get_contents($filename) 一次性读入文件内容,再依次取出前 3 个字节:
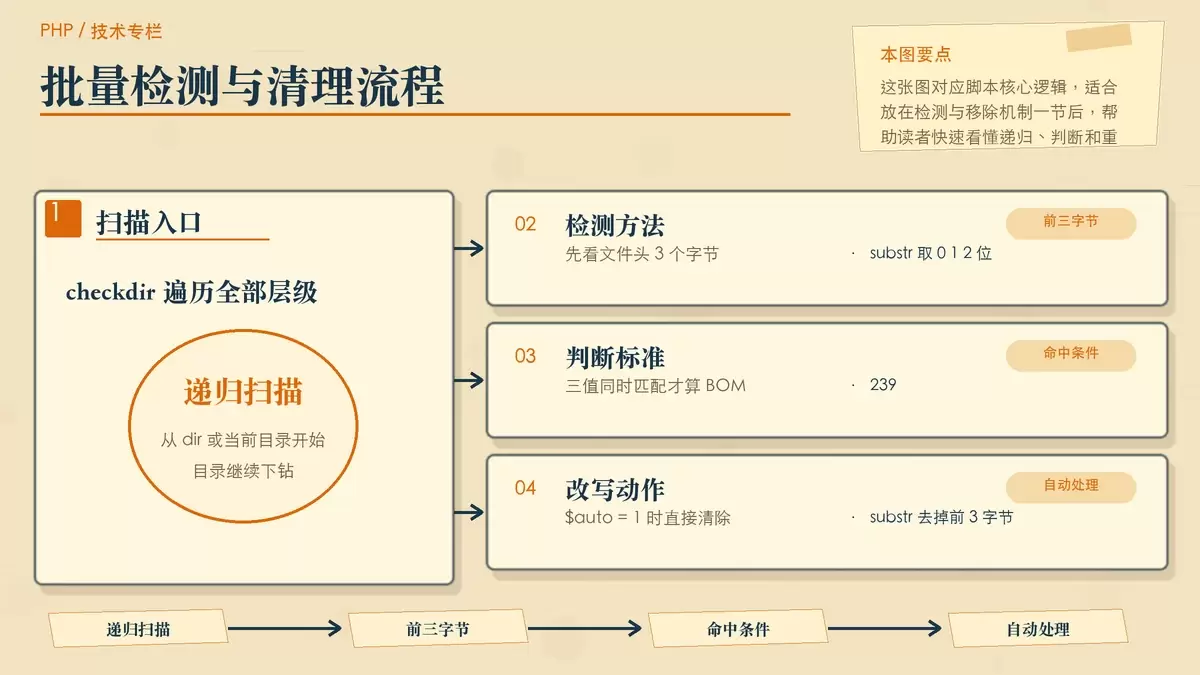
substr($contents, 0, 1)substr($contents, 1, 1)substr($contents, 2, 1)
随后通过 ord() 把这 3 个字符转成数值,并和 BOM 的 3 个固定值比较:
239187191
如果三个值全部匹配,就说明文件头存在 UTF-8 BOM。
自动清除的处理流程
脚本里把 $auto 设成了 1,表示发现 BOM 后自动处理。处理方式也很直接:通过 substr($contents, 3) 截掉前 3 个字节,把剩余内容写回原文件。
写回动作由 rewrite($filename, $data) 完成,这个函数用了:
fopen($filename, "w")打开文件flock($filenum, LOCK_EX)加排他锁fwrite($filenum, $data)写入新内容fclose($filenum)关闭文件
也就是说,它不是生成新文件,而是直接覆盖原文件。对于批量修复老项目,这种方式效率高,但也意味着运行前最好先备份,至少确认当前目录确实就是你要处理的代码目录。
输出结果怎么看
扫描过程中,脚本会输出每个文件名,并在未发现 BOM 时返回 BOM Not Found.。如果检测到 BOM 且启用了自动处理,函数返回的是空字符串,等于直接把文件改掉了。
这也解释了一个容易忽略的点:从输出信息上看,脚本更偏向“执行型”而不是“审计型”。如果你只想先确认有哪些文件存在问题,再决定是否修改,可以把 $auto 改成非 1 的值,先跑一次检查结果。
实际使用时要注意的几个问题
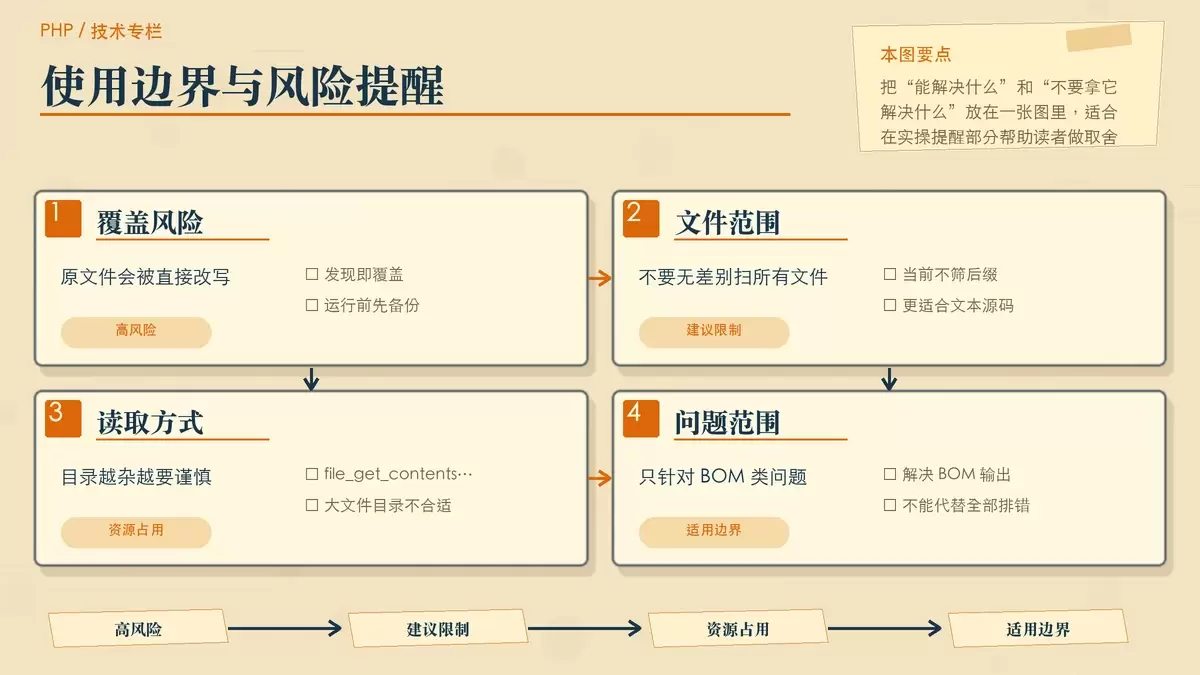
这段脚本能解决问题,但它更像是一个够用的小工具,而不是完整的工程化方案。真正放到项目里跑之前,有几个点最好先看清楚。
1. 它会直接改写原文件
只要 $auto = 1,检测到 BOM 后就会立刻覆盖原文件。对于线上代码、共享目录或仍在协作中的老项目,直接运行前应先备份,或者先在测试环境执行。
2. 没有限制文件后缀
脚本当前是“扫到什么就读什么”,并不会只处理 .php、.html、.js 或 .css。如果目录中混有大量非文本文件,更稳妥的做法是增加后缀过滤,只处理明确的文本类文件。
3. 通过 file_get_contents() 整体读入文件
对普通源码文件来说,这么做没有问题;但如果目标目录里有体积较大的文件,一次性整体读取会带来额外的内存占用。这个脚本适合处理常见源码目录,不适合无差别扫描大体积混合资源目录。
4. 适合处理 BOM 引发的头部输出问题
需要区分的是,这个脚本只能解决“文件头存在 BOM”这一类问题。若报错是由 PHP 标签外的空格、调试输出、echo、var_dump(),或模板提前输出内容引起,清除 BOM 并不能替代完整排查。
换句话说,它适合当作 BOM 专项清理工具,而不是所有 headers already sent 报错的通用修复器。
什么场景下值得用这类脚本
如果你的项目存在这些情况,这段脚本通常就很实用:
- 老项目从 Windows 编辑器迁移过来
- 多人协作,编辑器编码设置不统一
- 报错信息指向多个不同文件,手工排查成本高
- 确认问题集中在 UTF-8 BOM,而不是业务输出逻辑
它的价值不在于复杂,而在于把“逐个打开文件检查编码”的重复劳动换成一次递归扫描。对体量不大的 PHP 项目,这种处理方式通常足够直接有效。
如果你要进一步长期规避这类问题,更可靠的办法还是统一编辑器编码设置,保存为不带 BOM 的 UTF-8,并在团队协作中固定代码规范。脚本适合补救,规范才能减少问题反复出现。















