


Python2与Python3在图片中添加汉字的编码差异及解决方案

发布时间:2026-10-13 |
4人浏览过
本文详解在Python2和Python3环境下,利用OpenCV和PIL库在图片上叠加汉字的实现方法。重点解析因内部编码机制不同导致的UnicodeDecodeError错误,并提供将UTF-8转换为GBK编码的具体代码修正方案,确保在Windows系统中正确显示中文标签。
在Python2和Python3中实现在图片上添加汉字,核心差异源于两者内部编码机制的不同,这直接导致代码实现细节存在区别。深入理解底层编码原理即可避免此类问题。以下提供的代码示例已在Windows 10系统中验证可用。
Python2环境下图片添加汉字的代码实现
# -*- coding: cp936 -*-
import cv2
import numpy as np
from PIL import Image, ImageDraw, ImageFont
def ID_2_Word(txt):
 tmp_ID = txt.split(':')[0]
 value = txt.split(':')[-1]
 '''
 numbers = {
  'DS041' : "Coolant TEMP   ",
  'DS048' : "RPM     ",
  'DS049' : "Speed     ",
  'DS098' : "Oil level    ",
  'DS123' : "Control Module Voltage"
 }
 '''
 numbers = {
  'DS041' : "冷却液温度",
  'DS048' : "发动机转速",
  'DS049' : "车速 ",
  'DS098' : "燃油液位输入",
  'DS123' : "控制模块电压"
 }
 word = numbers.get(tmp_ID, None)
 result = str(word) + ':' + value
 #print(result)
 return result
def cv2ImgAddText(img, text, left, top, textColor=(0, 255, 0), textSize=20):
 if (isinstance(img, np.ndarray)): #判断是否OpenCV图片类型
  img = Image.fromarray(cv2.cvtColor(img, cv2.COLOR_BGR2RGB))
 draw = ImageDraw.Draw(img)
 #fontText = ImageFont.truetype("font/simsun.ttc", textSize, encoding="utf-8")
 fontText = ImageFont.truetype("font/simsun.ttc", textSize, encoding="gb2312") #cp936
 draw.text((left, top), text, textColor, font=fontText)
 return cv2.cvtColor(np.asarray(img), cv2.COLOR_RGB2BGR)
def layer1_show(img,data):
 frame = cv2.resize(img, (1280, 720), interpolation=cv2.INTER_CUBIC)
 font = ImageFont.truetype('font/simsun.ttc',24,encoding="utf-8")
 OBD_string = data
 y0, dy = 50, 25
 for i, txt in enumerate(OBD_string.split(';')):
   #word = txt
  word = ID_2_Word(txt) #将OBD信号的ID转换为中文
  word = unicode(word,'gbk')
   #print(i, txt.split(':')[0])
  y = y0+i*dy
  frame = cv2ImgAddText(frame, word, 100, y, (255, 0, 0), 20)
 cv2.imshow("layer_1", frame)
 cv2.waitKey(0)
if __name__ == '__main__':
 img = cv2.imread("map.png");
 data = "DS041: 88;DS048: 800;DS049: 64;DS098: 0.00;DS123: 0.00"
 layer1_show(img,data)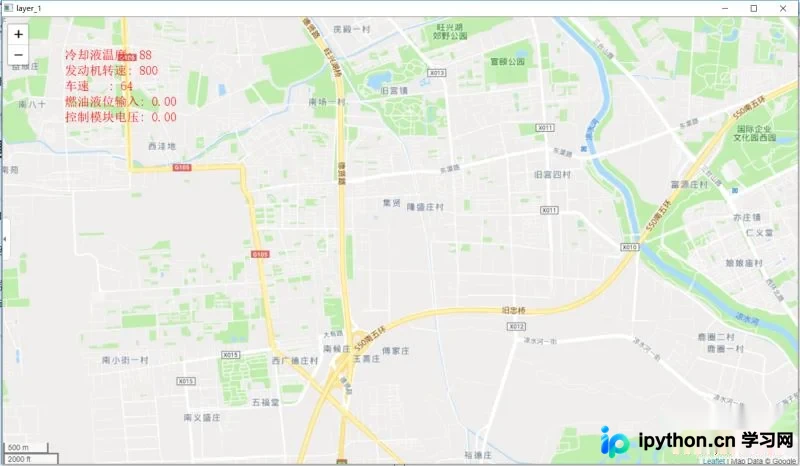
Python3环境下图片添加汉字的代码实现
import cv2
import numpy as np
from PIL import Image, ImageDraw, ImageFont
def ID_2_Word(txt):
 tmp_ID = txt.split(':')[0]
 value = txt.split(':')[-1]
 '''
 numbers = {
  'DS041' : "Coolant TEMP   ",
  'DS048' : "RPM     ",
  'DS049' : "Speed     ",
  'DS098' : "Oil level    ",
  'DS123' : "Control Module Voltage"
 }
 '''
 numbers = {
  'DS041' : "冷却液温度",
  'DS048' : "发动机转速",
  'DS049' : "车速 ",
  'DS098' : "燃油液位输入",
  'DS123' : "控制模块电压"
 }
 word = numbers.get(tmp_ID, None)
 result = str(word) + ':' + value
 #print(result)
 return result
def cv2ImgAddText(img, text, left, top, textColor=(0, 255, 0), textSize=20):
 if (isinstance(img, np.ndarray)): #判断是否OpenCV图片类型
  img = Image.fromarray(cv2.cvtColor(img, cv2.COLOR_BGR2RGB))
 draw = ImageDraw.Draw(img)
 #fontText = ImageFont.truetype("font/simsun.ttc", textSize, encoding="utf-8")
 fontText = ImageFont.truetype("font/simsun.ttc", textSize, encoding="gb2312") #cp936
 draw.text((left, top), text, textColor, font=fontText)
 return cv2.cvtColor(np.asarray(img), cv2.COLOR_RGB2BGR)
def layer1_show(img,data):
 frame = cv2.resize(img, (1280, 720), interpolation=cv2.INTER_CUBIC)
 font = ImageFont.truetype('font/simsun.ttc',24,encoding="utf-8")
 OBD_string = data
 y0, dy = 50, 25
 for i, txt in enumerate(OBD_string.split(';')):
   #word = txt
  word = ID_2_Word(txt) #将OBD信号的ID转换为中文
  #word = unicode(word,'gbk')
  y = y0+i*dy
  frame = cv2ImgAddText(frame, word, 100, y, (255, 0, 0), 20)
 cv2.imshow("layer_1", frame)
 cv2.waitKey(0)
if __name__ == '__main__':
 img = cv2.imread("map.png");
 data = "DS041: 88;DS048: 800;DS049: 64;DS098: 0.00;DS123: 0.00"
 layer1_show(img,data)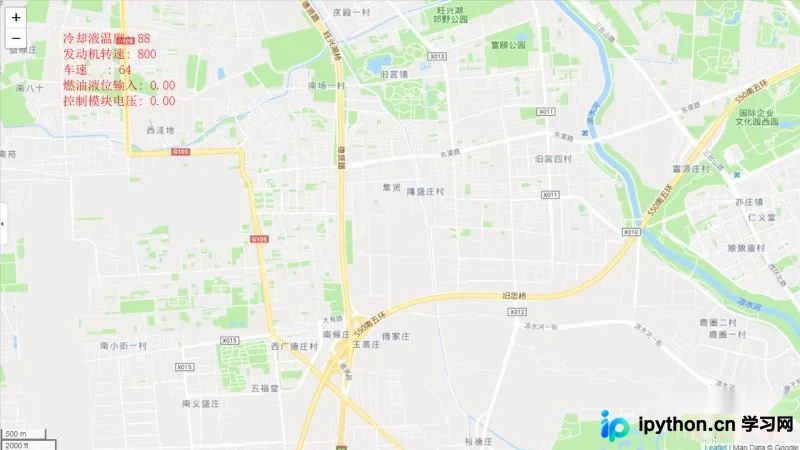
常见报错与问题排查
Python2中常遇到如下错误:UnicodeDecodeError: ‘ascii' codec can't decode byte 0xe8 in position 0: ordinal not in range(128)。
该错误通常由默认的UTF-8编码格式引起。
中文字符的Unicode编码范围位于0x0800至0xFFFF之间,部分汉字虽包含在UTF-8编码中,但当尝试将该字符转换为UTF-8编码时,可能超出其处理范畴。相比之下,GBK规范收录了ISO 10646.1中的全部CJK汉字及符号并有补充。因此,解决该问题的有效方法是将编码方式由UTF-8改为GBK。
word = unicode(word,'utf-8') 改为 word = unicode(word,'gbk')总结
上述内容介绍了Python2和Python3在图片上添加汉字的具体实现方法,希望能对读者有所帮助。如有任何疑问,欢迎留言,小编会及时回复。感谢大家对本站的支持!若本文对您有帮助,欢迎转载,请注明出处,谢谢!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















