


Python爬虫实战:利用正则表达式抓取猫眼电影Top100封面图

本文通过Python爬虫实战,演示如何使用正则表达式从猫眼电影Top100榜单批量下载电影封面图。文章详细解析了页面元素分析、URL规律观察及正则匹配策略,结合requests与re模块实现数据提取,并探讨该方法的优缺点及与其他爬虫技术的对比。
前言与背景
前言
近期多部热门电影上映,笔者在查阅猫眼电影数据时,注意到其Top100榜单涵盖了经典与热映影片。鉴于电影封面视觉效果丰富且手动逐一下载耗时费力,笔者尝试运用近期学习的正则表达式技术,以验证其在爬虫场景下的实际效果与局限性。
抓取目标与榜单规则
目标:爬取Top100榜单上电影的封面图
Top100榜单的生成规则为:基于猫眼电影库中的经典影片数据,综合评分高低及评分人数多少进行排序,选取前100名,并于每日上午10点更新。相关数据源明确标注为“猫眼电影库”。
实施步骤详解
以下是具体的实施步骤:
(1)检查页面HTML结构,定位包含图片路径的代码片段。
(2)分析图片在网页中的唯一标识属性,以便后续准确获取图片位置信息。
(3)针对翻页需求,观察并记录多个页面URL的变化规律。
(4)综合上述分析结果,编写适配的正则表达式。
代码实现与逻辑分析
1、Python标准库中的re模块提供了完整的正则表达式功能,直接导入即可使用;requests模块作为常用的HTTP客户端库,用于发起网络请求;而urllib.request模块则主要用于最后阶段的文件写入操作。
import re
import requests
import urllib.request
2、首先接收目标URL对应的HTML页面内容,并将其转换为字符串格式(因为正则表达式操作对象为字符串)。定义第一个pattern1用于缩小匹配范围,抓取目标区域,result1接收匹配结果,此时所有封面图的地址信息已提取至该变量中。
response = requests.get(url)
response = str(response.content)
patttern1 = '<dl class="board-wrapper">.+?<div class="pager-main">'
result1 = re.compile(pat).findall(response)
3、应用第二个正则表达式,专门用于匹配图片的具体地址信息。
pat2 = '<img data-src="https://(.+?\.jpg)'
photos = re.compile(pat1).findall(re1[0])
此时已成功获取100张电影封面图的信息,效果如下图所示:
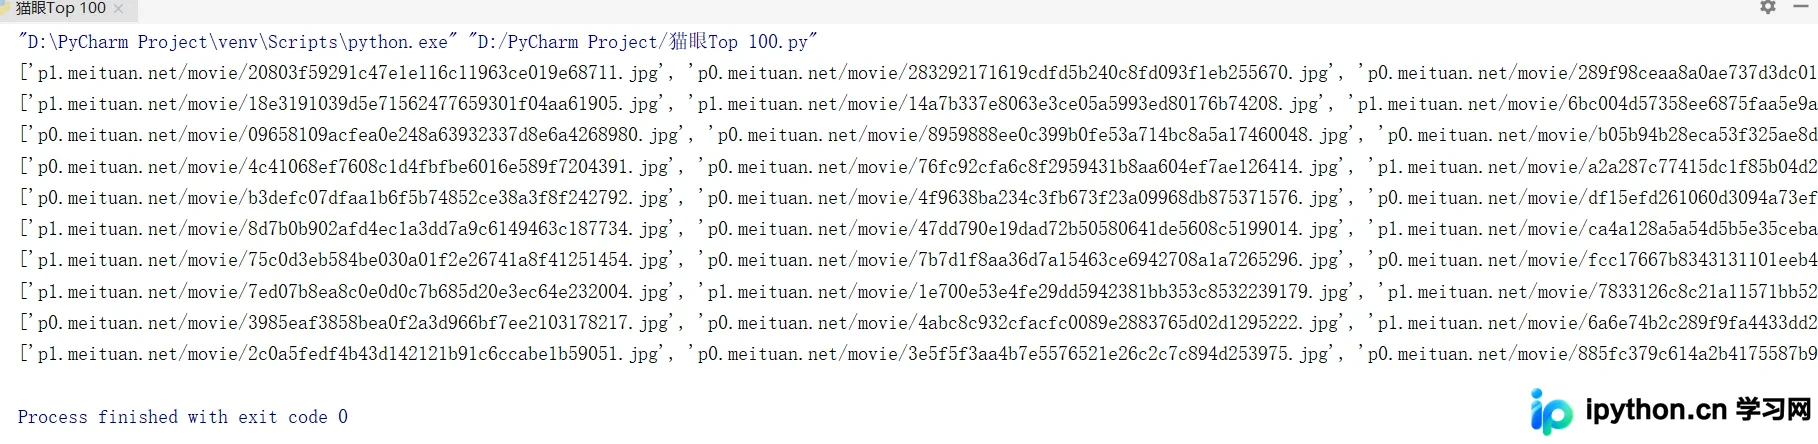
4、进入下一步处理,为每张图片设定正确的命名规则,确保拥有准确的图片地址,从而避免文件重复覆盖。
x = 1
for imgurl in name:
 imgname = 'D:/Top 100/'+str(i/10)+str(x)+'.jpg'
 imgurl = 'https://'+imgurl
 urllib.request.urlretrieve(imgurl,filename=imgname)
 x += 1
5、最后一步,由于涉及多页数据爬取,因此引入循环结构,完成10页内容的完整抓取。
for i in range(0, 100, 10):
  url = 'http://maoyan.com/board/4?offset='+str(i)
  get_one_page(url, i)
  #定义函数,多次调用
技术对比与总结
总体而言,这是一个相对简单的基础应用案例,也是笔者学习后的实践成果。在此示例中,笔者选择了正则表达式实现功能,但需注意,针对更复杂的爬虫项目,可能存在更简单或更严谨的方法,例如使用BeautifulSoup或XPath等工具,这些方法需要掌握更多知识,建议后续深入学习。
总结
以上就是本文的全部内容,希望本文的内容对大家的学习或者工作具有一定的参考学习价值,谢谢大家对本站的支持。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















