


Python实现决策树剪枝算法详解:从ID3到CART

本文详细解析Python中决策树剪枝算法的实现。涵盖ID3算法基于信息熵的分裂逻辑,以及CART算法采用基尼指数进行二元划分的机制。通过完整代码示例,展示如何计算香农熵、处理连续变量划分,并实现预剪枝与后剪枝策略,帮助开发者掌握机器学习核心算法的底层实现。
Python决策树剪枝算法概述
本文详细介绍如何在Python中实现决策树的剪枝算法,提供完整的代码示例供读者参考学习。
决策树基本原理
决策树是一种基于树形结构的预测模型,用于描述对象属性与目标值之间的映射关系。树中的每个节点代表一个对象特征,分叉路径对应可能的属性取值,而叶子节点则代表最终的分类或回归结果。决策树通常只生成单一输出,若需处理多输出问题,可分别构建独立的决策树模型。
ID3算法与信息熵计算
ID3算法是决策树早期的重要算法之一,其核心思想源于奥卡姆剃刀原理,即倾向于选择更简单的模型。ID3(Iterative Dichotomiser 3)由Ross Quinlan提出,是一种启发式算法,旨在通过信息增益最大化来构建决策树,虽不保证生成最小树结构,但能有效降低复杂度。在信息论中,信息熵衡量系统的无序程度:系统越有序,熵值越低;系统越混乱,熵值越高。ID3通过计算信息增益来选择最优分裂属性,信息增益越大,纯度提升越显著。该算法采用自顶向下的贪婪搜索策略遍历可能的决策空间。
CART算法与基尼指数实现
CART(分类与回归树)算法使用基尼指数(Gini Index)作为分裂标准。基尼指数定义为 gini(T) = 1 - Σ(p_j^2),其中 p_j 表示类别 j 在数据集 T 中的相对频率。当数据集中某一类占主导时,基尼指数最小。将数据集 T 划分为子集 T1(含 N1 个实例)和 T2(含 N2 个实例)后,加权基尼指数定义为 gini_split(T) = (N1/N)*gini(T1) + (N2/N)*gini(T2)。算法选择使 gini_split(T) 最小的划分方式作为节点分裂标准。具体实现中,首先通过 calcShannon 函数计算数据集的香农熵,并为所有可能的分类标签创建计数字典。
def calcShannonEnt(dataSet):
  numEntries = len(dataSet)
  labelCounts = {}
  # 给所有可能分类创建字典
  for featVec in dataSet:
    currentLabel = featVec[-1]
    if currentLabel not in labelCounts.keys():
      labelCounts[currentLabel] = 0
    labelCounts[currentLabel] += 1
  shannonEnt = 0.0
  # 以2为底数计算香农熵
  for key in labelCounts:
    prob = float(labelCounts[key]) / numEntries
    shannonEnt -= prob * log(prob, 2)
  return shannonEnt
# 对离散变量划分数据集,取出该特征取值为value的所有样本
def splitDataSet(dataSet, axis, value):
  retDataSet = []
  for featVec in dataSet:
    if featVec[axis] == value:
      reducedFeatVec = featVec[:axis]
      reducedFeatVec.extend(featVec[axis + 1:])
      retDataSet.append(reducedFeatVec)
  return retDataSet
连续变量划分处理
针对连续变量,需设计特定的数据集划分逻辑。direction 参数用于规定划分方向,即决定是提取小于 value 的样本子集,还是提取大于 value 的样本子集,从而实现对连续特征的离散化处理。
  numFeatures = len(dataSet[0]) - 1
  baseEntropy = calcShannonEnt(dataSet)
  bestInfoGain = 0.0
  bestFeature = -1
  bestSplitDict = {}
  for i in range(numFeatures):
    featList = [example[i] for example in dataSet]
    # 对连续型特征进行处理
    if type(featList[0]).__name__ == 'float' or type(featList[0]).__name__ == 'int':
      # 产生n-1个候选划分点
      sortfeatList = sorted(featList)
      splitList = []
      for j in range(len(sortfeatList) - 1):
        splitList.append((sortfeatList[j] + sortfeatList[j + 1]) / 2.0)

      bestSplitEntropy = 10000
      slen = len(splitList)
      # 求用第j个候选划分点划分时,得到的信息熵,并记录最佳划分点
      for j in range(slen):
        value = splitList[j]
        newEntropy = 0.0
        subDataSet0 = splitContinuousDataSet(dataSet, i, value, 0)
        subDataSet1 = splitContinuousDataSet(dataSet, i, value, 1)
        prob0 = len(subDataSet0) / float(len(dataSet))
        newEntropy += prob0 * calcShannonEnt(subDataSet0)
        prob1 = len(subDataSet1) / float(len(dataSet))
        newEntropy += prob1 * calcShannonEnt(subDataSet1)
        if newEntropy < bestSplitEntropy:
          bestSplitEntropy = newEntropy
          bestSplit = j
      # 用字典记录当前特征的最佳划分点
      bestSplitDict[labels[i]] = splitList[bestSplit]
      infoGain = baseEntropy - bestSplitEntropy
    # 对离散型特征进行处理
    else:
      uniqueVals = set(featList)
      newEntropy = 0.0
      # 计算该特征下每种划分的信息熵
      for value in uniqueVals:
        subDataSet = splitDataSet(dataSet, i, value)
        prob = len(subDataSet) / float(len(dataSet))
        newEntropy += prob * calcShannonEnt(subDataSet)
      infoGain = baseEntropy - newEntropy
    if infoGain > bestInfoGain:
      bestInfoGain = infoGain
      bestFeature = i
  # 若当前节点的最佳划分特征为连续特征,则将其以之前记录的划分点为界进行二值化处理
  # 即是否小于等于bestSplitValue
  if type(dataSet[0][bestFeature]).__name__ == 'float' or type(dataSet[0][bestFeature]).__name__ == 'int':
    bestSplitValue = bestSplitDict[labels[bestFeature]]
    labels[bestFeature] = labels[bestFeature] + '<=' + str(bestSplitValue)
    for i in range(shape(dataSet)[0]):
      if dataSet[i][bestFeature] <= bestSplitValue:
        dataSet[i][bestFeature] = 1
      else:
        dataSet[i][bestFeature] = 0
  return bestFeature
def chooseBestFeatureToSplit(dataSet, labels):
  numFeatures = len(dataSet[0]) - 1
  baseEntropy = calcShannonEnt(dataSet)
  bestInfoGain = 0.0
  bestFeature = -1
  bestSplitDict = {}
  for i in range(numFeatures):
    featList = [example[i] for example in dataSet]
    # 对连续型特征进行处理
    if type(featList[0]).__name__ == 'float' or type(featList[0]).__name__ == 'int':
      # 产生n-1个候选划分点
      sortfeatList = sorted(featList)
      splitList = []
      for j in range(len(sortfeatList) - 1):
        splitList.append((sortfeatList[j] + sortfeatList[j + 1]) / 2.0)

      bestSplitEntropy = 10000
      slen = len(splitList)
      # 求用第j个候选划分点划分时,得到的信息熵,并记录最佳划分点
      for j in range(slen):
        value = splitList[j]
        newEntropy = 0.0
        subDataSet0 = splitContinuousDataSet(dataSet, i, value, 0)
        subDataSet1 = splitContinuousDataSet(dataSet, i, value, 1)
        prob0 = len(subDataSet0) / float(len(dataSet))
        newEntropy += prob0 * calcShannonEnt(subDataSet0)
        prob1 = len(subDataSet1) / float(len(dataSet))
        newEntropy += prob1 * calcShannonEnt(subDataSet1)
        if newEntropy < bestSplitEntropy:
          bestSplitEntropy = newEntropy
          bestSplit = j
      # 用字典记录当前特征的最佳划分点
      bestSplitDict[labels[i]] = splitList[bestSplit]
      infoGain = baseEntropy - bestSplitEntropy
    # 对离散型特征进行处理
    else:
      uniqueVals = set(featList)
      newEntropy = 0.0
      # 计算该特征下每种划分的信息熵
      for value in uniqueVals:
        subDataSet = splitDataSet(dataSet, i, value)
        prob = len(subDataSet) / float(len(dataSet))
        newEntropy += prob * calcShannonEnt(subDataSet)
      infoGain = baseEntropy - newEntropy
    if infoGain > bestInfoGain:
      bestInfoGain = infoGain
      bestFeature = i
  # 若当前节点的最佳划分特征为连续特征,则将其以之前记录的划分点为界进行二值化处理
  # 即是否小于等于bestSplitValue
  if type(dataSet[0][bestFeature]).__name__ == 'float' or type(dataSet[0][bestFeature]).__name__ == 'int':
    bestSplitValue = bestSplitDict[labels[bestFeature]]
    labels[bestFeature] = labels[bestFeature] + '<=' + str(bestSplitValue)
    for i in range(shape(dataSet)[0]):
      if dataSet[i][bestFeature] <= bestSplitValue:
        dataSet[i][bestFeature] = 1
      else:
        dataSet[i][bestFeature] = 0
  return bestFeature
``def classify(inputTree, featLabels, testVec):
  firstStr = inputTree.keys()[0]
  if u'<=' in firstStr:
    featvalue = float(firstStr.split(u"<=")[1])
    featkey = firstStr.split(u"<=")[0]
    secondDict = inputTree[firstStr]
    featIndex = featLabels.index(featkey)
    if testVec[featIndex] <= featvalue:
      judge = 1
    else:
      judge = 0
    for key in secondDict.keys():
      if judge == int(key):
        if type(secondDict[key]).__name__ == 'dict':
          classLabel = classify(secondDict[key], featLabels, testVec)
        else:
          classLabel = secondDict[key]
  else:
    secondDict = inputTree[firstStr]
    featIndex = featLabels.index(firstStr)
    for key in secondDict.keys():
      if testVec[featIndex] == key:
        if type(secondDict[key]).__name__ == 'dict':
          classLabel = classify(secondDict[key], featLabels, testVec)
        else:
          classLabel = secondDict[key]
  return classLabel
def majorityCnt(classList):
  classCount={}
  for vote in classList:
    if vote not in classCount.keys():
      classCount[vote]=0
    classCount[vote]+=1
  return max(classCount)
def testing_feat(feat, train_data, test_data, labels):
  class_list = [example[-1] for example in train_data]
  bestFeatIndex = labels.index(feat)
  train_data = [example[bestFeatIndex] for example in train_data]
  test_data = [(example[bestFeatIndex], example[-1]) for example in test_data]
  all_feat = set(train_data)
  error = 0.0
  for value in all_feat:
    class_feat = [class_list[i] for i in range(len(class_list)) if train_data[i] == value]
    major = majorityCnt(class_feat)
    for data in test_data:
      if data[0] == value and data[1] != major:
        error += 1.0
  # print 'myTree %d' % error
  return error
模型测试与可视化
在模型构建完成后,需进行测试环节以验证算法效果。
  error = 0.0
  for i in range(len(data_test)):
    if classify(myTree, labels, data_test[i]) != data_test[i][-1]:
      error += 1
  # print 'myTree %d' % error
  return float(error)
def testingMajor(major, data_test):
  error = 0.0
  for i in range(len(data_test)):
    if major != data_test[i][-1]:
      error += 1
  # print 'major %d' % error
  return float(error)

**递归产生决策树**

```def createTree(dataSet,labels,data_full,labels_full,test_data,mode):
  classList=[example[-1] for example in dataSet]
  if classList.count(classList[0])==len(classList):
    return classList[0]
  if len(dataSet[0])==1:
    return majorityCnt(classList)
  labels_copy = copy.deepcopy(labels)
  bestFeat=chooseBestFeatureToSplit(dataSet,labels)
  bestFeatLabel=labels[bestFeat]

  if mode == "unpro" or mode == "post":
    myTree = {bestFeatLabel: {}}
  elif mode == "prev":
    if testing_feat(bestFeatLabel, dataSet, test_data, labels_copy) < testingMajor(majorityCnt(classList),
                                            test_data):
      myTree = {bestFeatLabel: {}}
    else:
      return majorityCnt(classList)
  featValues=[example[bestFeat] for example in dataSet]
  uniqueVals=set(featValues)

  if type(dataSet[0][bestFeat]).__name__ == 'unicode':
    currentlabel = labels_full.index(labels[bestFeat])
    featValuesFull = [example[currentlabel] for example in data_full]
    uniqueValsFull = set(featValuesFull)

  del (labels[bestFeat])

  for value in uniqueVals:
    subLabels = labels[:]
    if type(dataSet[0][bestFeat]).__name__ == 'unicode':
      uniqueValsFull.remove(value)

    myTree[bestFeatLabel][value] = createTree(splitDataSet \
                           (dataSet, bestFeat, value), subLabels, data_full, labels_full,
                         splitDataSet \
                           (test_data, bestFeat, value), mode=mode)
  if type(dataSet[0][bestFeat]).__name__ == 'unicode':
    for value in uniqueValsFull:
      myTree[bestFeatLabel][value] = majorityCnt(classList)

  if mode == "post":
    if testing(myTree, test_data, labels_copy) > testingMajor(majorityCnt(classList), test_data):
      return majorityCnt(classList)
  return myTree


<div class="se-preview-section-delimiter"></div>

```**读入数据**

```def load_data(file_name):
  with open(r"dd.csv", 'rb') as f:
   df = pd.read_csv(f,sep=",")
   print(df)
   train_data = df.values[:11, 1:].tolist()
  print(train_data)
  test_data = df.values[11:, 1:].tolist()
  labels = df.columns.values[1:-1].tolist()
  return train_data, test_data, labels


<div class="se-preview-section-delimiter"></div>

```测试并绘制树图
import matplotlib.pyplot as plt
decisionNode = dict(boxstyle="round4", color='red') # 定义判断结点形态
leafNode = dict(boxstyle="circle", color='grey') # 定义叶结点形态
arrow_args = dict(arrowstyle="<-", color='blue') # 定义箭头


# 计算树的叶子节点数量
def getNumLeafs(myTree):
  numLeafs = 0
  firstSides = list(myTree.keys())
  firstStr = firstSides[0]
  secondDict = myTree[firstStr]
  for key in secondDict.keys():
    if type(secondDict[key]).__name__ == 'dict':
      numLeafs += getNumLeafs(secondDict[key])
    else:
      numLeafs += 1
  return numLeafs


# 计算树的最大深度
def getTreeDepth(myTree):
  maxDepth = 0
  firstSides = list(myTree.keys())
  firstStr = firstSides[0]
  secondDict = myTree[firstStr]
  for key in secondDict.keys():
    if type(secondDict[key]).__name__ == 'dict':
      thisDepth = 1 + getTreeDepth(secondDict[key])
    else:
      thisDepth = 1
    if thisDepth > maxDepth:
      maxDepth = thisDepth
  return maxDepth


# 画节点
def plotNode(nodeTxt, centerPt, parentPt, nodeType):
  createPlot.ax1.annotate(nodeTxt, xy=parentPt, xycoords='axes fraction', \
              xytext=centerPt, textcoords='axes fraction', va="center", ha="center", \
              bbox=nodeType, arrowprops=arrow_args)


# 画箭头上的文字
def plotMidText(cntrPt, parentPt, txtString):
  lens = len(txtString)
  xMid = (parentPt[0] + cntrPt[0]) / 2.0 - lens * 0.002
  yMid = (parentPt[1] + cntrPt[1]) / 2.0
  createPlot.ax1.text(xMid, yMid, txtString)


def plotTree(myTree, parentPt, nodeTxt):
  numLeafs = getNumLeafs(myTree)
  depth = getTreeDepth(myTree)
  firstSides = list(myTree.keys())
  firstStr = firstSides[0]
  cntrPt = (plotTree.x0ff + (1.0 + float(numLeafs)) / 2.0 / plotTree.totalW, plotTree.y0ff)
  plotMidText(cntrPt, parentPt, nodeTxt)
  plotNode(firstStr, cntrPt, parentPt, decisionNode)
  secondDict = myTree[firstStr]
  plotTree.y0ff = plotTree.y0ff - 1.0 / plotTree.totalD
  for key in secondDict.keys():
    if type(secondDict[key]).__name__ == 'dict':
      plotTree(secondDict[key], cntrPt, str(key))
    else:
      plotTree.x0ff = plotTree.x0ff + 1.0 / plotTree.totalW
      plotNode(secondDict[key], (plotTree.x0ff, plotTree.y0ff), cntrPt, leafNode)
      plotMidText((plotTree.x0ff, plotTree.y0ff), cntrPt, str(key))
  plotTree.y0ff = plotTree.y0ff + 1.0 / plotTree.totalD


def createPlot(inTree):
  fig = plt.figure(1, facecolor='white')
  fig.clf()
  axprops = dict(xticks=[], yticks=[])
  createPlot.ax1 = plt.subplot(111, frameon=False, **axprops)
  plotTree.totalW = float(getNumLeafs(inTree))
  plotTree.totalD = float(getTreeDepth(inTree))
  plotTree.x0ff = -0.5 / plotTree.totalW
  plotTree.y0ff = 1.0
  plotTree(inTree, (0.5, 1.0), '')
  plt.show()
if __name__ == "__main__":
  train_data, test_data, labels = load_data("dd.csv")
  data_full = train_data[:]
  labels_full = labels[:]

  mode="post"
  mode = "prev"
  mode="post"
  myTree = createTree(train_data, labels, data_full, labels_full, test_data, mode=mode)
  createPlot(myTree)
  print(json.dumps(myTree, ensure_ascii=False, indent=4))
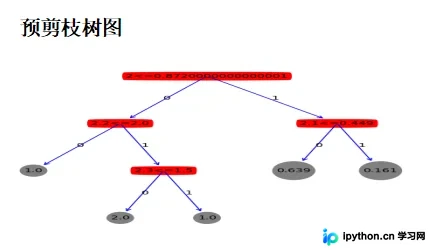
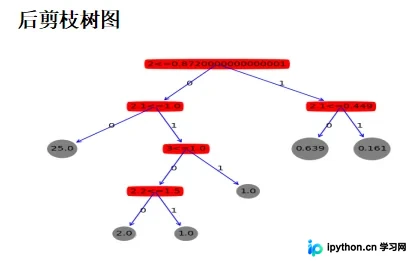
通过设置不同的 mode 参数,可以分别生成三种不同形态的树图,以可视化决策树的分裂过程。
if __name__ == "__main__":
  train_data, test_data, labels = load_data("dd.csv")
  data_full = train_data[:]
  labels_full = labels[:]

  mode="post"
  mode = "prev"
  mode="post"
  myTree = createTree(train_data, labels, data_full, labels_full, test_data, mode=mode)
  createPlot(myTree)
  print(json.dumps(myTree, ensure_ascii=False, indent=4))
通过选择 mode 参数,可以分别得到三种树图 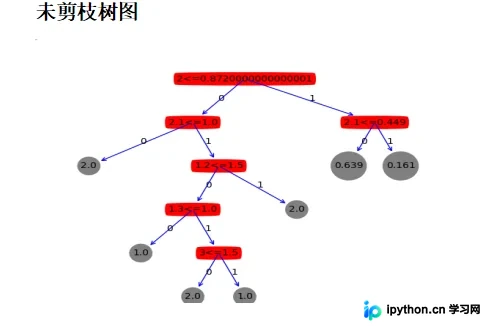 。
更多关于Python相关内容感兴趣的读者可查看本站专题:《Python数据结构与算法教程》、《Python加密解密算法与技巧总结》、《Python编码操作技巧总结》、《Python函数使用技巧总结》、《Python字符串操作技巧汇总》及《Python入门与进阶经典教程》
希望本文所述对大家Python程序设计有所帮助。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















